
INDUSTRIA · DOCUMENTOS · ERP
Cómo automatizar pedidos, albaranes y facturas para que entren en el ERP sin picar datos
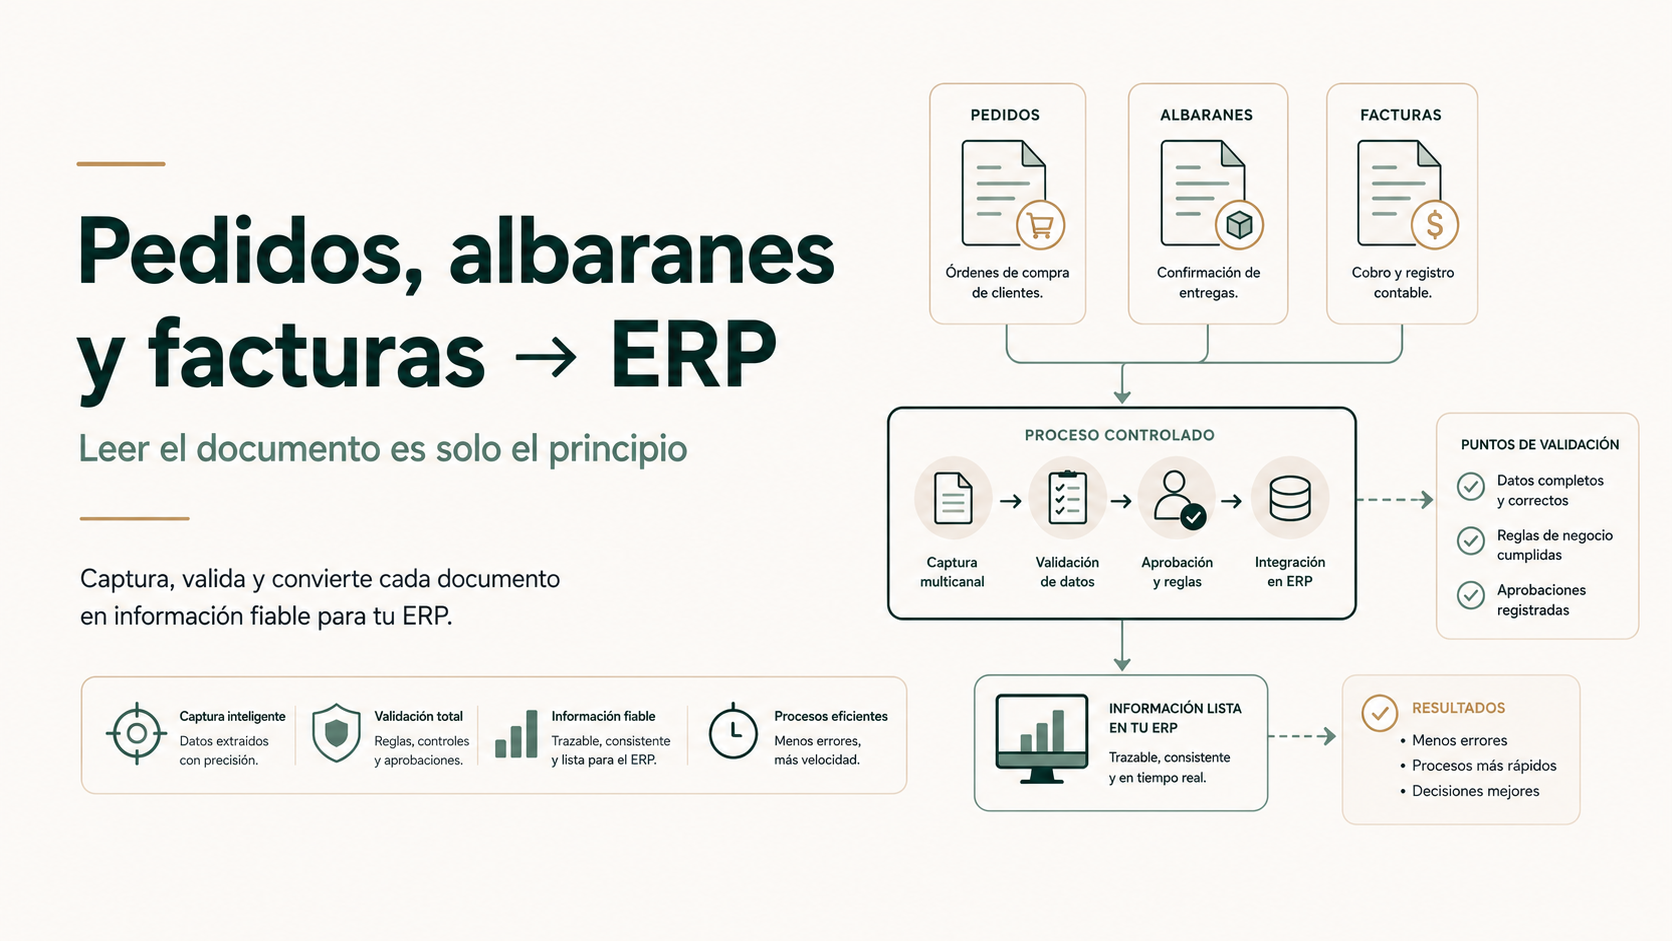
Que un OCR haya leído correctamente un albarán no significa que el ERP sepa qué hacer con él. Entre reconocer el texto y crear una transacción fiable hay que resolver clientes, proveedores, referencias, cantidades, duplicados y excepciones.
El documento puede estar perfectamente leído y seguir sin ser una transacción válida.
Un PDF trae nombres, códigos, cantidades y precios. El ERP necesita clientes, proveedores, artículos, unidades, pedidos, recepciones y reglas internas válidas.
La automatización fiable no salta directamente del OCR a “crear”. Primero clasifica, normaliza, resuelve referencias, coteja el documento con lo que ya existe y detecta duplicados.
Cuando algo no encaja, el resultado correcto no es adivinar. Es detener solo ese caso, explicar qué falla y pedir la revisión necesaria.
El OCR ha leído el albarán. Todavía no tenemos una recepción válida.
Imaginemos un albarán con veinte líneas. La herramienta reconoce bien el proveedor, la fecha, las referencias y las cantidades. A primera vista parece que el trabajo está hecho.
Pero el ERP no conoce “Tornillo M8 zincado” como texto libre. Conoce una referencia concreta. Tampoco sabe si las 120 unidades del documento corresponden al pedido correcto, si ya se registró una recepción anterior o si esa unidad se compra por cajas de 50.
Ahí está la diferencia entre digitalizar y automatizar. Leer el documento es una parte; convertirlo en una operación coherente dentro del sistema es otra.
En la automatización de procesos en industria ya aparece este tipo de fricción alrededor del ERP: información que existe digitalmente pero que todavía necesita una persona para traducirse al lenguaje interno del negocio.
Cinco controles antes de escribir una sola línea en el ERP
En lugar de pensar en “cinco puertas”, resulta más natural hablar de cinco controles. Son comprobaciones consecutivas que reducen el riesgo de transformar un documento correcto en una transacción incorrecta.
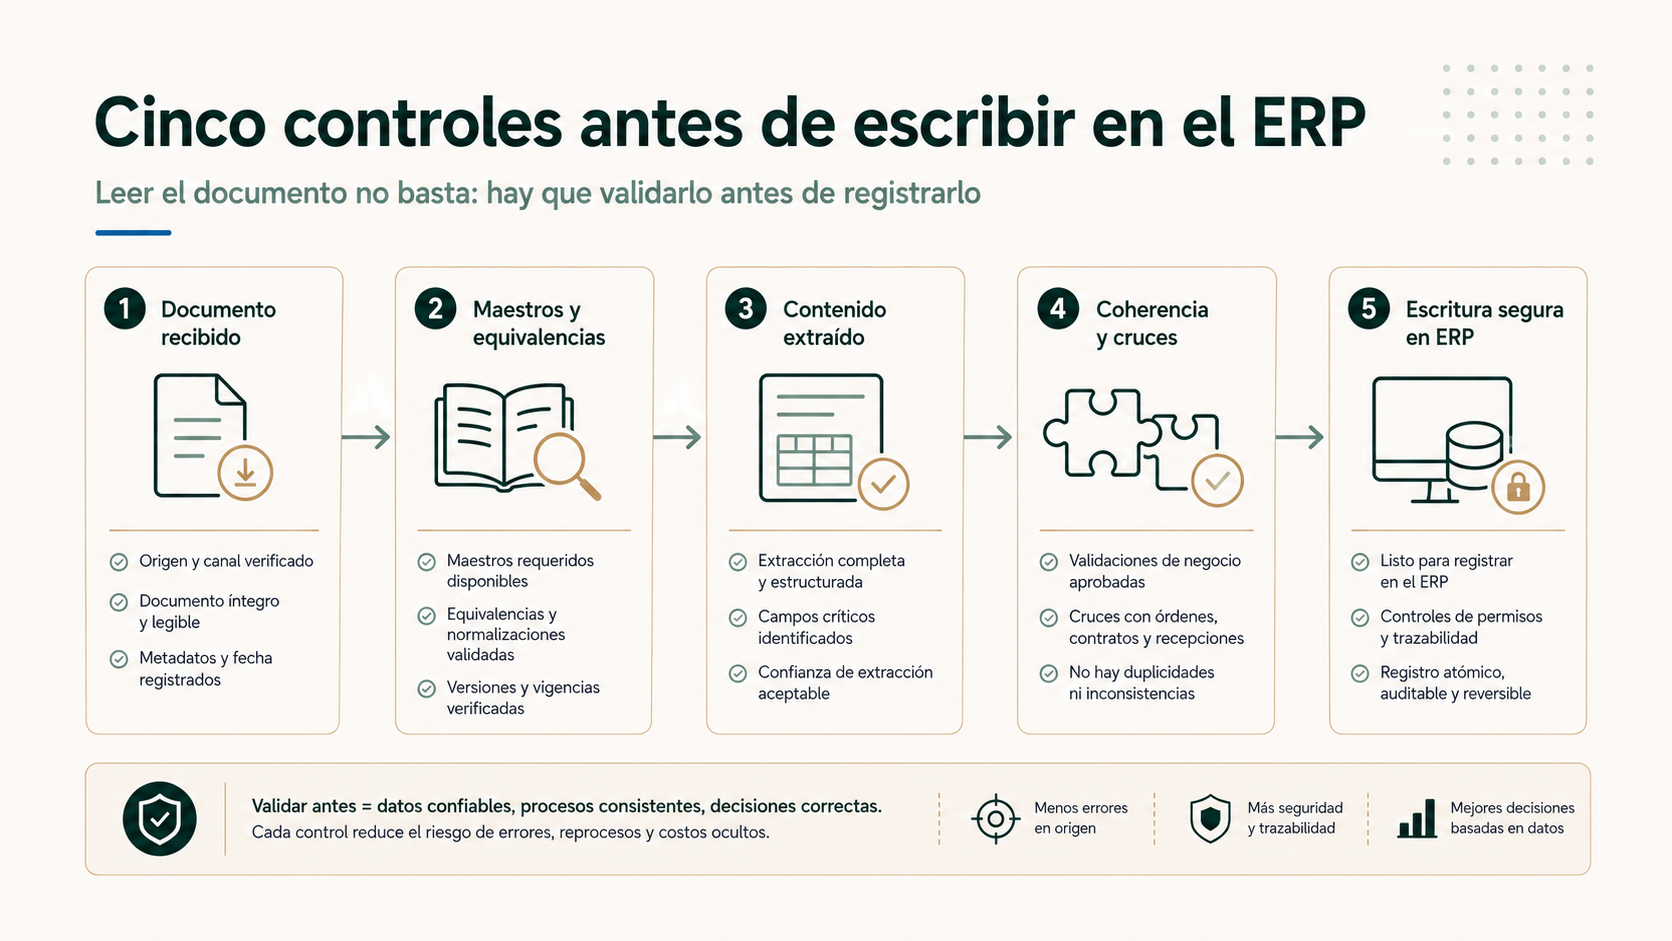
La mayor parte del valor está en los controles intermedios. Si solo automatizamos la extracción, hemos reducido tecleo. Si además resolvemos maestros y comprobamos el proceso de negocio, empezamos a automatizar de verdad.
Pedido, albarán y factura se parecen en PDF; dentro del ERP no hacen lo mismo
Los tres pueden llegar adjuntos en un correo y compartir muchos campos. Sin embargo, cada uno intenta crear o actualizar un objeto diferente.
Pedido de cliente
Destino: pedido de venta.
Hay que identificar cliente, referencias, cantidades, precios, entrega y posibles duplicados.
Albarán
Destino: recepción o entrega.
Debe relacionarse con el pedido y reflejar lo que realmente se recibió o entregó.
Factura de proveedor
Destino: factura/borrador contable.
Además de leerla, puede requerir comparación con pedido y recepción.
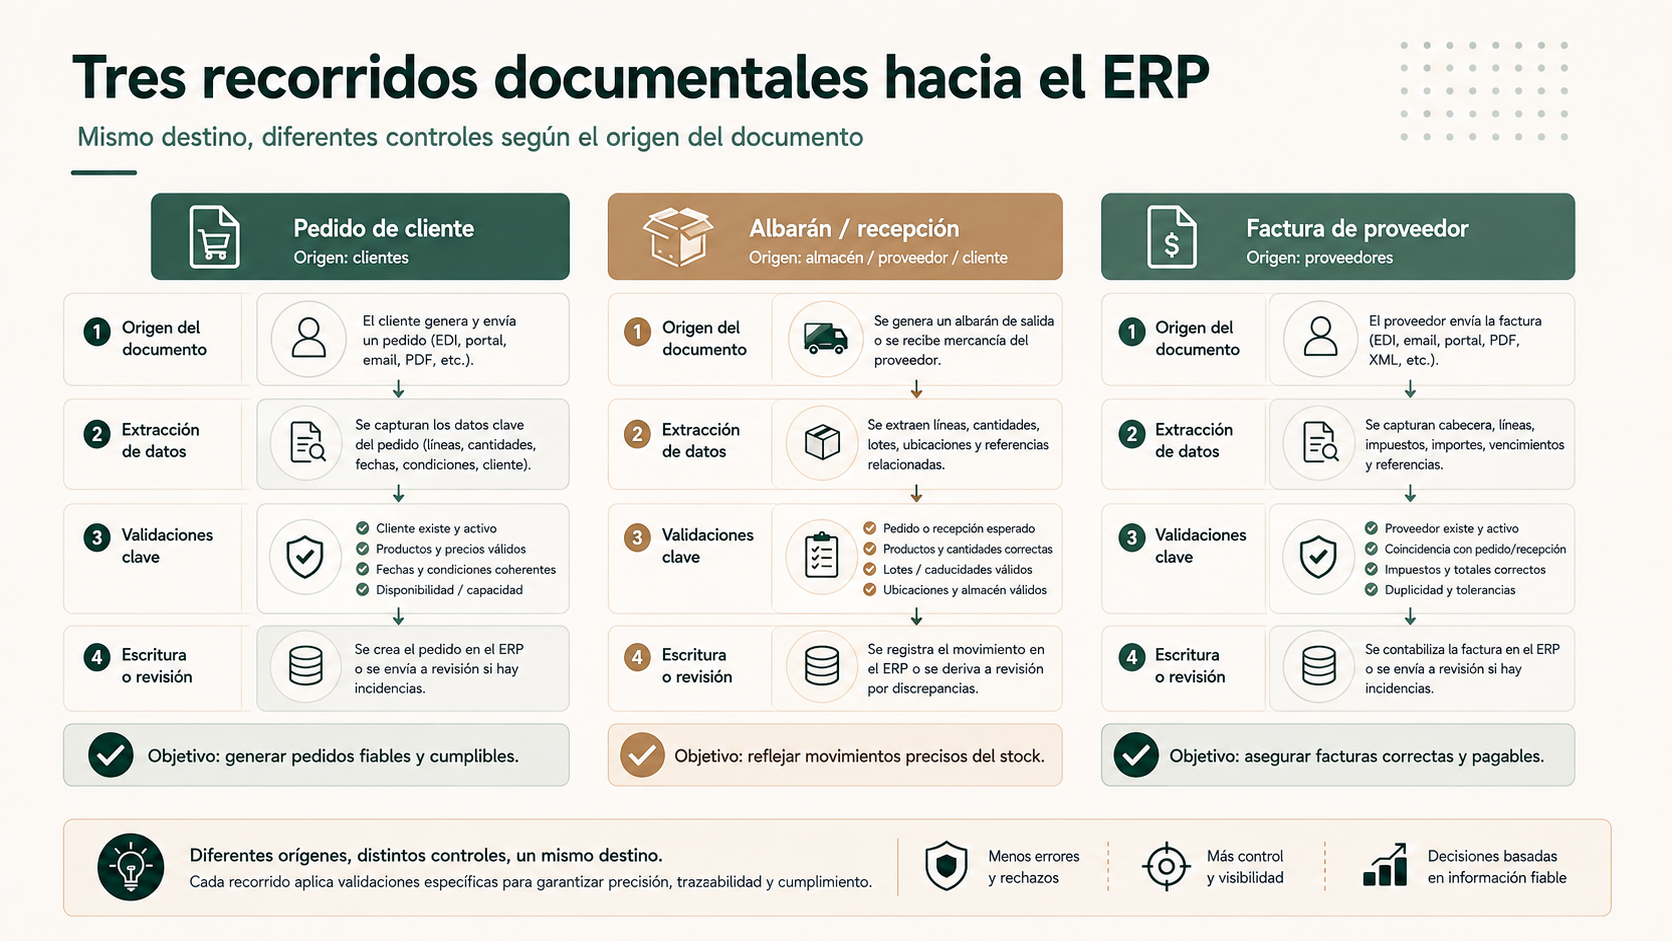
Esta separación es importante para diseñar excepciones. Una referencia desconocida en un pedido no se resuelve igual que una cantidad superior a la recibida en una factura.
El documento puede llegar por email, portal, EDI o una carpeta
El canal de entrada debería ser una capa separada de la lógica. Un PDF que llega por email y el mismo PDF subido por un proveedor a un portal tendrían que acabar en el mismo proceso de clasificación y validación.
Las fuentes habituales son:
- Email y buzones compartidos.
- Portales de clientes o proveedores.
- Carpetas de red o almacenamiento cloud.
- Escáner o fotografía móvil.
- EDI u otros formatos estructurados.
- APIs de otros sistemas.
- Exportaciones de plataformas de compra o marketplaces.
La ventaja de desacoplar la entrada es práctica: si mañana un proveedor deja de enviar PDFs por correo y pasa a un portal, no hay que rediseñar las reglas que resuelven productos, cantidades o duplicados.
OCR, extracción y normalización: tres trabajos diferentes
OCR significa reconocimiento óptico de caracteres. Convierte una imagen o un PDF escaneado en texto que una máquina puede leer. Es útil, pero no sabe por sí solo qué significado empresarial tiene cada fragmento.
Después viene la extracción estructurada: localizar campos concretos como número de factura, proveedor, fecha, moneda, total o líneas. Google Document AI, por ejemplo, dispone de un analizador preentrenado de facturas y de extractores personalizados para tipos de documento que no tienen un procesador específico.
La tercera capa es la normalización: convertir lo extraído en un formato coherente. “1.250,50 €”, “1250.50 EUR” y “EUR 1,250.50” deberían terminar representando el mismo valor. Lo mismo ocurre con fechas, unidades o referencias.
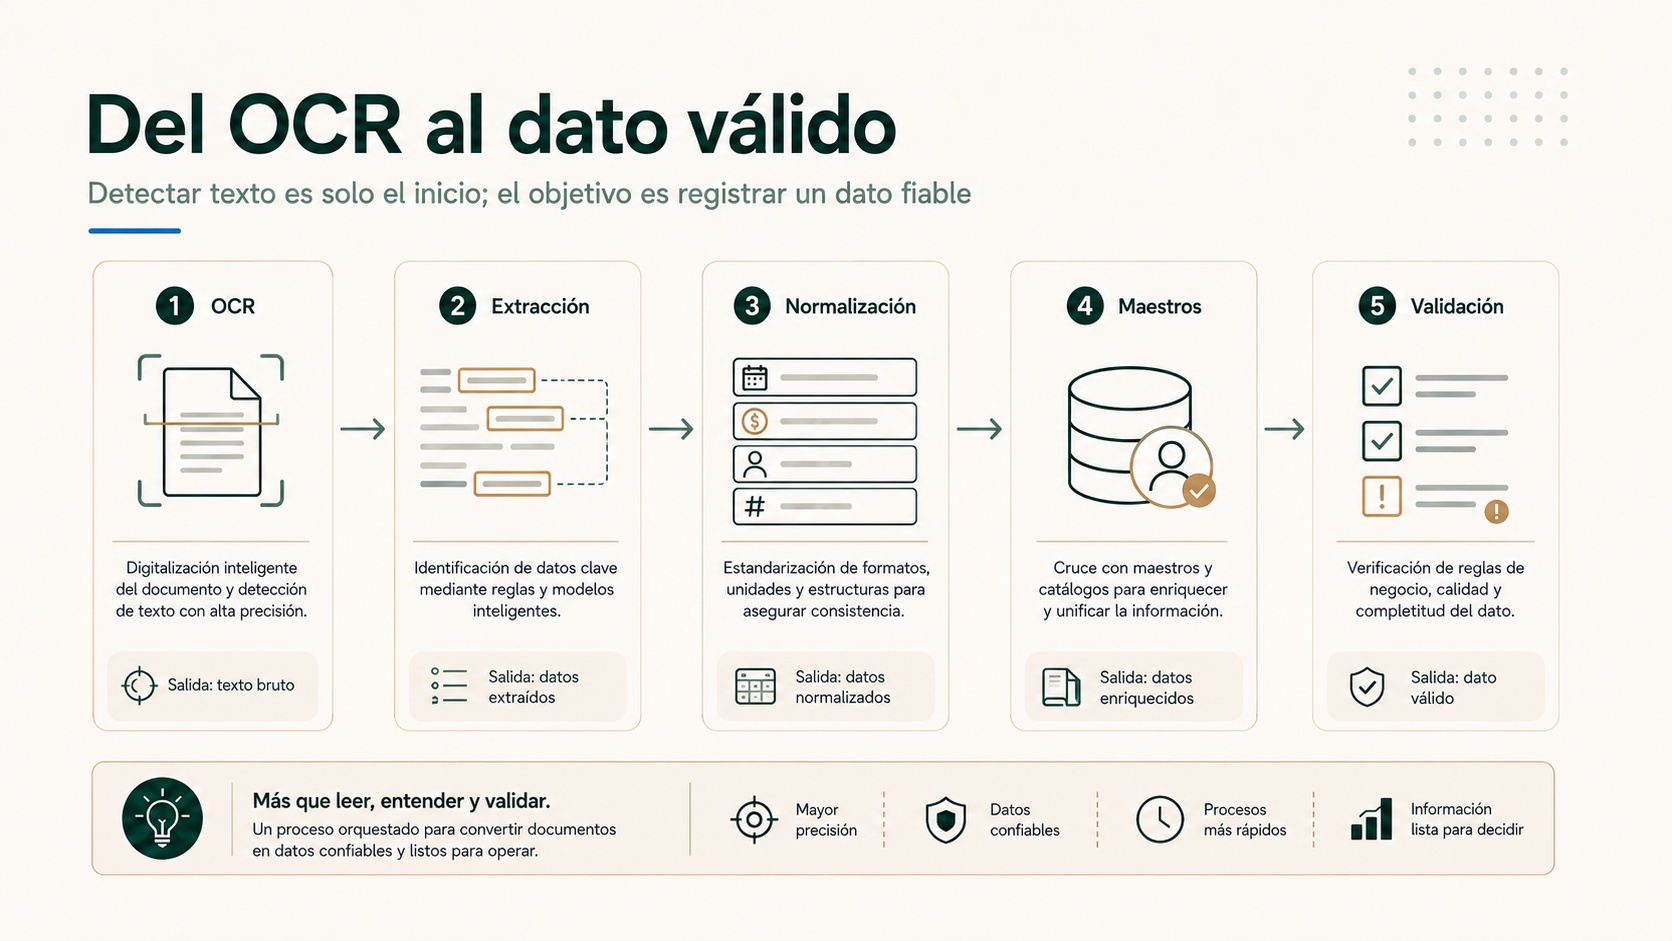
En otras palabras: reconocer texto, entender campos y preparar datos son tareas distintas. Y todavía falta una cuarta: relacionar esos datos con el ERP.
Los maestros suelen ser más difíciles que el OCR
Un extractor puede leer con mucha claridad “Rodamientos García SL”. Si en el ERP existen “RODGAR”, “Rodamientos García, S.L.” y un registro antiguo del mismo proveedor, la extracción no resuelve el problema de identidad.
Lo mismo ocurre con las líneas. El proveedor puede utilizar su referencia RX-884-B y la empresa comprar ese artículo como MAT-004821. La automatización necesita una equivalencia fiable.
Las dificultades habituales son:
- Clientes y proveedores duplicados.
- Nombres comerciales distintos de la razón social.
- Referencias de proveedor distintas del SKU interno.
- Artículos sustituidos o descatalogados.
- Unidades de compra y almacenamiento diferentes.
- Varias direcciones de entrega.
- Varios almacenes o centros.
- Condiciones fiscales o comerciales dependientes de la operación.
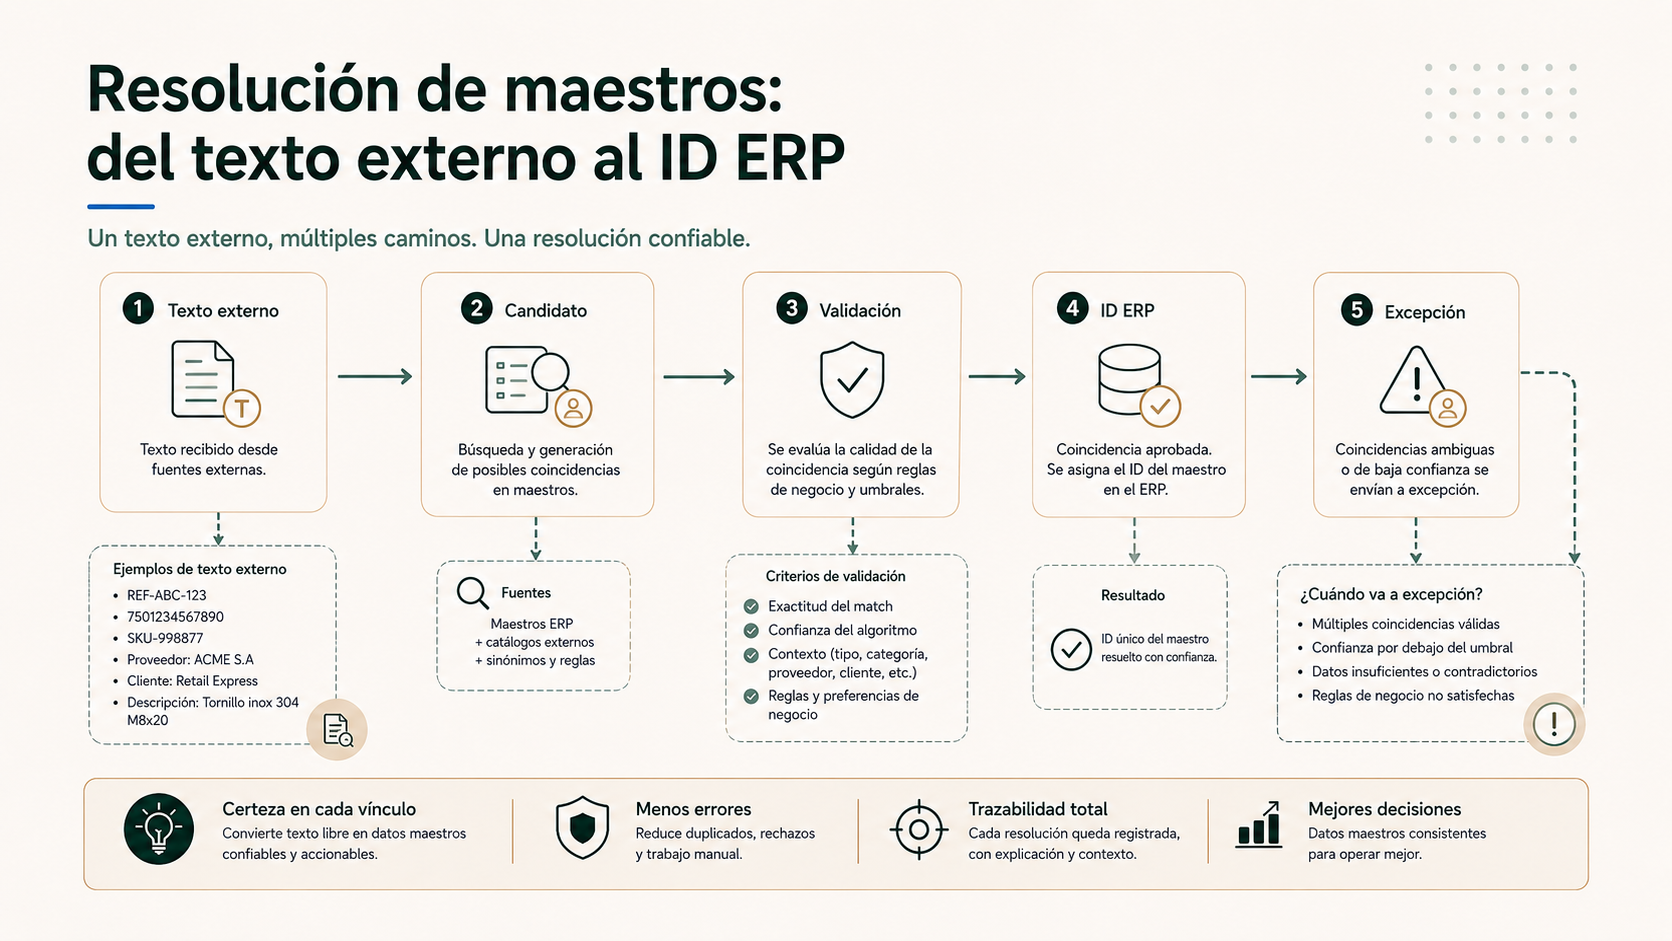
Aquí no interesa que la IA “sea creativa”. Puede ayudar a encontrar candidatos, pero la salida útil es un ID interno que exista y sea válido. Cuando la correspondencia no es suficientemente clara, debe aparecer una excepción.
Cada excepción resuelta puede mejorar el sistema. Si un responsable confirma que RX-884-B equivale siempre a MAT-004821 para ese proveedor, la relación puede guardarse y dejar de preguntarse en documentos futuros.
Pedido de cliente: convertir un documento comercial en un pedido de venta
Un pedido recibido por PDF o Excel suele contener justo lo que alguien acabaría tecleando: cliente, dirección, líneas, cantidades y fechas. Automatizarlo parece directo hasta que aparecen las referencias externas.
Un flujo razonable podría:
- Identificar al cliente por código, NIF/CIF, email, dominio, dirección u otra referencia fiable.
- Extraer la referencia de pedido del cliente.
- Resolver cada línea contra el artículo interno.
- Convertir unidades cuando exista una equivalencia aprobada.
- Comprobar precios y descuentos contra tarifa o condiciones del ERP cuando proceda.
- Validar la dirección de entrega.
- Buscar un pedido previo con la misma referencia antes de crear otro.
- Preparar un borrador o enviar a revisión si alguna línea no está resuelta.
- Crear el pedido y guardar el identificador ERP en el expediente documental.
El dato extraído no debería tener más autoridad que el maestro del ERP. Si el documento escribe una descripción antigua de un artículo y existe una equivalencia validada, la referencia interna manda.
Albarán: registrar lo recibido, no lo que esperábamos recibir
El albarán es especialmente sensible porque está cerca del movimiento físico. Un pedido puede esperar 100 unidades y el proveedor entregar 80. El sistema no debe completar las 20 restantes porque “eso era lo pedido”.
La validación puede comprobar:
- Pedido relacionado.
- Proveedor o cliente.
- Fecha de entrega o recepción.
- Referencias internas.
- Cantidad documentada.
- Unidad de medida.
- Recepciones parciales anteriores.
- Excesos o faltantes.
- Lotes o números de serie cuando sean obligatorios.
En determinados procesos, el documento puede preparar la recepción para que una persona confirme físicamente lo recibido. En otros, la organización puede tener controles que permitan registrar automáticamente determinados casos. La arquitectura debe reflejar el proceso real de la empresa, no asumir que un albarán equivale siempre a mercancía verificada.
Factura de proveedor: comprobar pedido, recepción y factura antes de darla por buena
En documentación de ERP aparece a menudo el término inglés three-way matching. Algunas traducciones hablan de “cotejo de tres vías” o “conciliación de tres vías”, expresiones poco naturales fuera del entorno del software. Aquí lo llamaremos simplemente comprobación pedido-recepción-factura.
La lógica es fácil de entender:
- Pedido: qué se acordó comprar y a qué precio.
- Recepción: qué cantidad se recibió realmente.
- Factura: qué está cobrando el proveedor.
Odoo 19 documenta una función de verificación de tres pasos/3-way matching ligada a cantidades recibidas. Dynamics 365 Finance documenta igualmente políticas de comparación entre pedido, recepción y factura, incluyendo tolerancias de cantidad y precio.
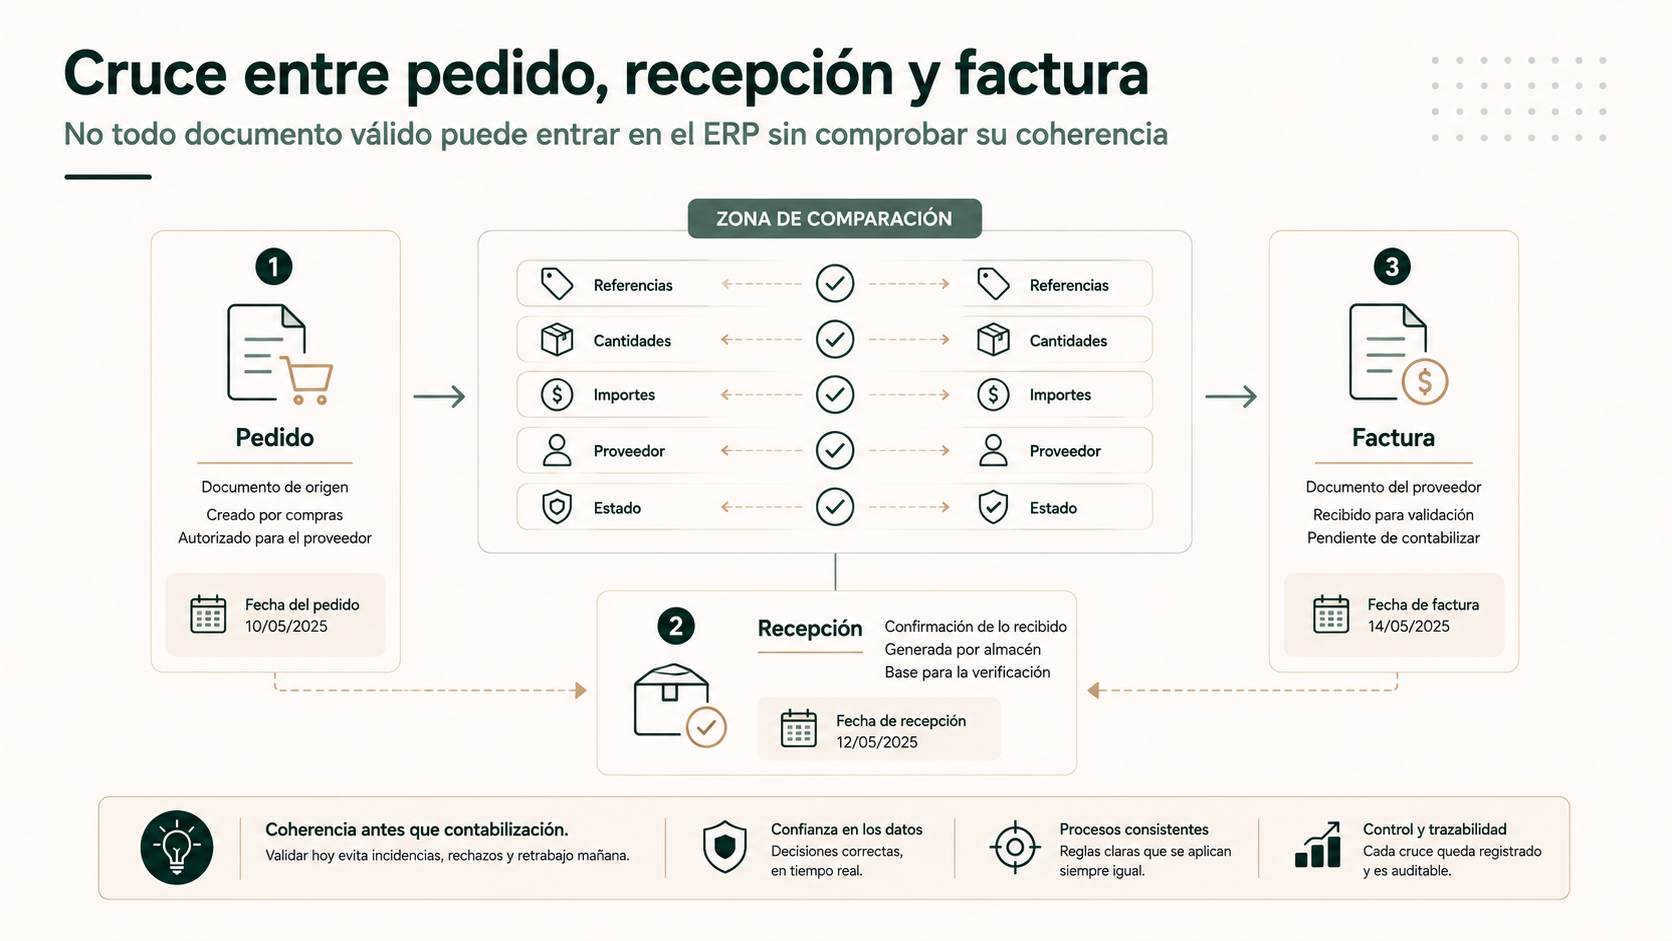
Las tolerancias son una decisión de negocio. Una empresa puede aceptar pequeñas diferencias en ciertos conceptos y otra exigir coincidencia exacta. No existe un porcentaje universal que deba aplicarse.
Cuando una diferencia supera lo aprobado, el sistema puede dejar la factura en revisión indicando exactamente dónde está el problema: precio, cantidad, impuesto, recepción inexistente o pedido no encontrado.
Dos tipos de duplicado que conviene no confundir
Duplicado de archivo. El mismo PDF ha entrado dos veces. Puede detectarse con una huella digital del archivo —un checksum o hash— que permite reconocer que los bytes son idénticos.
Duplicado de negocio. Dos archivos distintos contienen la misma factura, el mismo pedido o el mismo albarán. Aquí hay que comprobar claves del documento: proveedor, número, referencia, fecha, importe u otros identificadores.
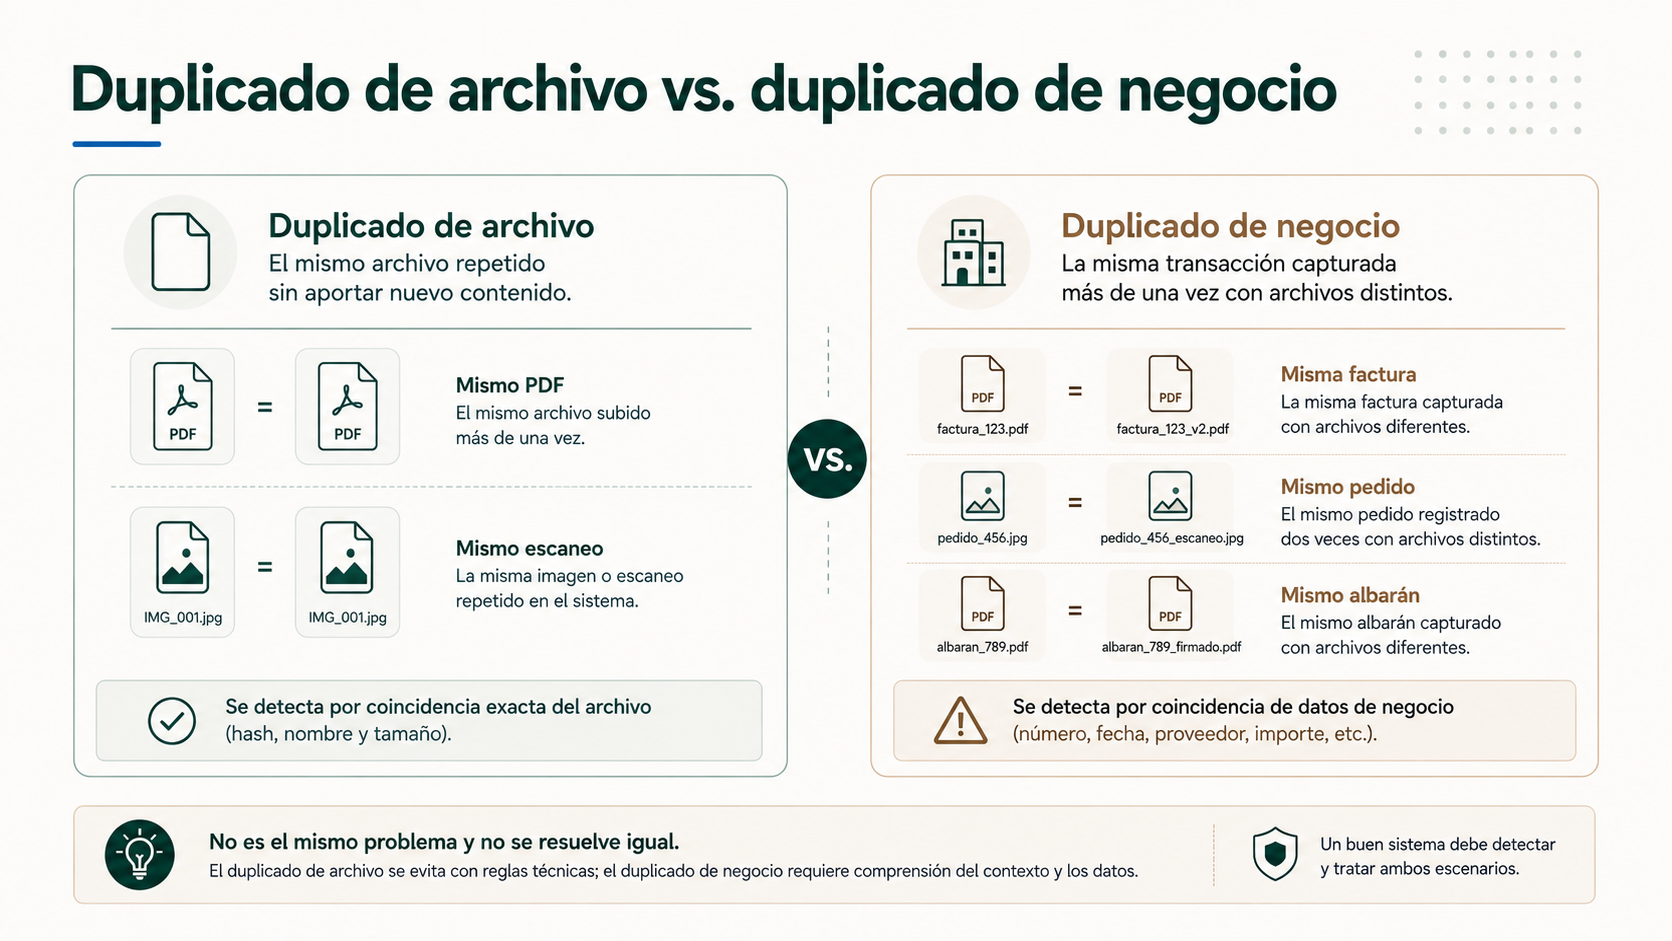
Microsoft Invoice Capture documenta detección de archivos repetidos mediante checksum, mientras que Dynamics 365 Finance también dispone de controles sobre números de factura duplicados. Son dos problemas relacionados, pero no equivalentes.
Si solo controlamos archivos idénticos, un proveedor puede enviar la misma factura primero como PDF y luego como una nueva exportación con metadatos diferentes. Técnicamente son archivos distintos; empresarialmente sigue siendo la misma factura.
Una zona intermedia de validación evita convertir cada duda en un error del ERP
En integraciones se utiliza mucho la palabra inglesa staging. En este contexto significa algo sencillo: una zona intermedia donde los datos ya están preparados, pero todavía no han creado la transacción definitiva.
Esa zona puede guardar:
- El documento original.
- Los campos extraídos.
- Los IDs de cliente, proveedor y artículos encontrados.
- Las reglas que se han superado.
- Las reglas que han fallado.
- Candidatos cuando existe ambigüedad.
- Diferencias frente a pedido o recepción.
- La acción pendiente y su responsable.
Una factura de veinte líneas puede tener diecinueve perfectamente resueltas y una referencia dudosa. La persona revisa esa línea, no vuelve a teclear el documento entero.
Es el mismo principio que resulta útil en otros procesos de automatización documental: separar la interpretación del dato de la escritura definitiva permite controlar excepciones sin renunciar a automatizar el resto.
Reintentar sin duplicar: por qué la idempotencia importa
Otra palabra habitual en integraciones es idempotencia. Explicada sin jerga: si la misma operación se ejecuta dos veces, no debería crear dos resultados.
Imaginemos que la integración envía un pedido al ERP. El ERP lo crea, pero la respuesta tarda demasiado y el sistema que envió la petición interpreta que ha fallado. Si reintenta sin controles, puede crear un segundo pedido.
Para evitarlo conviene:
- Asignar una clave técnica o de negocio al documento.
- Comprobar antes de crear si ya existe una transacción vinculada.
- Guardar el ID que devuelve el ERP.
- Distinguir “no recibí respuesta” de “la operación no ocurrió”.
- Diseñar reintentos seguros y una cola para fallos que necesitan revisión.
Este detalle técnico no suele aparecer en una demo de OCR, pero marca la diferencia entre un prototipo y una integración que puede funcionar cada día.
Dónde aporta IA y dónde es mejor una regla
La IA es útil cuando el documento cambia de forma, el texto es ambiguo o hay que interpretar contenido. No tiene sentido pedirle que sustituya controles que el ERP ya puede resolver de manera determinista.
| Tarea | Enfoque preferente | Motivo |
|---|---|---|
| Clasificar documentos mezclados. | IA / clasificador. | Hay variabilidad de formato y contenido. |
| Extraer campos de PDFs variables. | OCR + extractor documental. | Convierte documento en datos estructurados. |
| Buscar un SKU por equivalencia exacta. | Tabla/regla. | Resultado determinista. |
| Proponer SKU cuando la descripción es ambigua. | IA como apoyo. | Puede ordenar candidatos; no debe inventar el maestro. |
| Comprobar duplicado por número de factura. | Regla ERP. | La clave es conocida. |
| Validar tolerancia de precio. | Regla de negocio. | La empresa define el límite. |
| Explicar una excepción al usuario. | IA opcional. | Puede convertir datos técnicos en una explicación clara. |
La IA puede ayudar a encontrar la salida correcta. La autorización para escribir debería depender de evidencia, reglas y permisos.
Factura electrónica: menos OCR no significa menos validación
España publicó en marzo de 2026 el Real Decreto 238/2026, que desarrolla el sistema de facturación electrónica obligatoria entre empresarios y profesionales. A medida que la factura estructurada gane presencia, una parte de la extracción dejará de depender de leer PDFs.
Eso mejora el dato de entrada, pero no elimina las preguntas importantes:
- ¿El proveedor está correctamente identificado?
- ¿La factura ya existe?
- ¿Está vinculada al pedido correcto?
- ¿Se recibió lo que se factura?
- ¿Precio y cantidad están dentro de las condiciones acordadas?
- ¿Los impuestos y demás datos son coherentes con la operación?
Un XML puede ser estructuralmente perfecto y seguir representando una factura que la empresa debe revisar. Además, pedidos y albaranes seguirán llegando durante mucho tiempo en formatos heterogéneos.
No todos los ERP se integran igual: API, importación, base de datos o RPA
La parte documental puede estar muy bien resuelta y aun así encontrarse con una limitación en el sistema de destino. Por eso conviene revisar desde el principio cómo permite escribir el ERP y no dejar esa pregunta para el final del proyecto.
Las opciones más habituales son:
- API. Suele ser la vía preferente cuando expone las operaciones necesarias y permite trabajar con identificadores, validaciones y respuestas estructuradas.
- Importaciones estructuradas. Algunos sistemas permiten cargar CSV, Excel, XML u otros formatos. Puede ser una buena opción si el proceso admite trabajo por lotes.
- Conectores o middleware. Una capa intermedia puede traducir el modelo documental al modelo del ERP y gestionar colas, reintentos y credenciales.
- Acceso controlado a base de datos. Solo cuando el fabricante y la arquitectura lo permiten; escribir directamente en tablas internas sin respetar la lógica de negocio puede ser peligroso.
- RPA. Automatización de la interfaz cuando no existe otra vía razonable. Puede resolver sistemas cerrados, pero es más sensible a cambios de pantalla, campos o flujos.
La tecnología de integración no cambia el principio del artículo. El dato debe superar las mismas comprobaciones antes de convertirse en una operación. Lo único que cambia es el mecanismo utilizado para escribirla.
Un documento no debería perder su rastro después de entrar en el ERP
La trazabilidad no termina al crear el pedido o la factura. Meses después puede ser necesario responder preguntas muy concretas: ¿qué documento originó esta transacción?, ¿qué campo se corrigió?, ¿quién validó la excepción?, ¿qué versión del archivo se procesó?
Un diseño robusto conserva la relación entre:
- Documento original.
- Identificador del proceso o expediente.
- Datos extraídos.
- Correcciones realizadas por una persona.
- Reglas aplicadas.
- Objeto creado en el ERP.
- Usuario o servicio que ejecutó la escritura.
- Fecha y resultado de cada intento.
Esa relación permite investigar errores sin reconstruir la historia a partir de correos y capturas. También ayuda a mejorar la automatización: si siempre se corrige el mismo proveedor, referencia o unidad, probablemente falta una regla o un maestro bien mantenido.
Qué cambia cuando el documento tiene 2 líneas y cuando tiene 200
El volumen de líneas altera mucho la experiencia de revisión. En una factura sencilla, una persona puede comprobar todo el documento en pocos segundos. En un albarán de 180 referencias, obligarla a revisar línea por línea destruye buena parte del beneficio.
Por eso conviene distinguir entre validación del documento y validación de excepciones. Si 176 líneas cumplen todas las reglas y cuatro presentan una referencia desconocida o una cantidad fuera de tolerancia, la interfaz debería llevar al usuario directamente a esas cuatro.
También es útil agrupar incidencias por tipo:
- Referencias sin equivalencia.
- Diferencias de cantidad.
- Diferencias de precio.
- Campos fiscales incompletos.
- Pedido o recepción no encontrados.
El objetivo no es que el revisor “confíe” ciegamente en el sistema. Es que pueda comprobar de forma eficiente qué controles se han ejecutado y dónde existe una diferencia real.
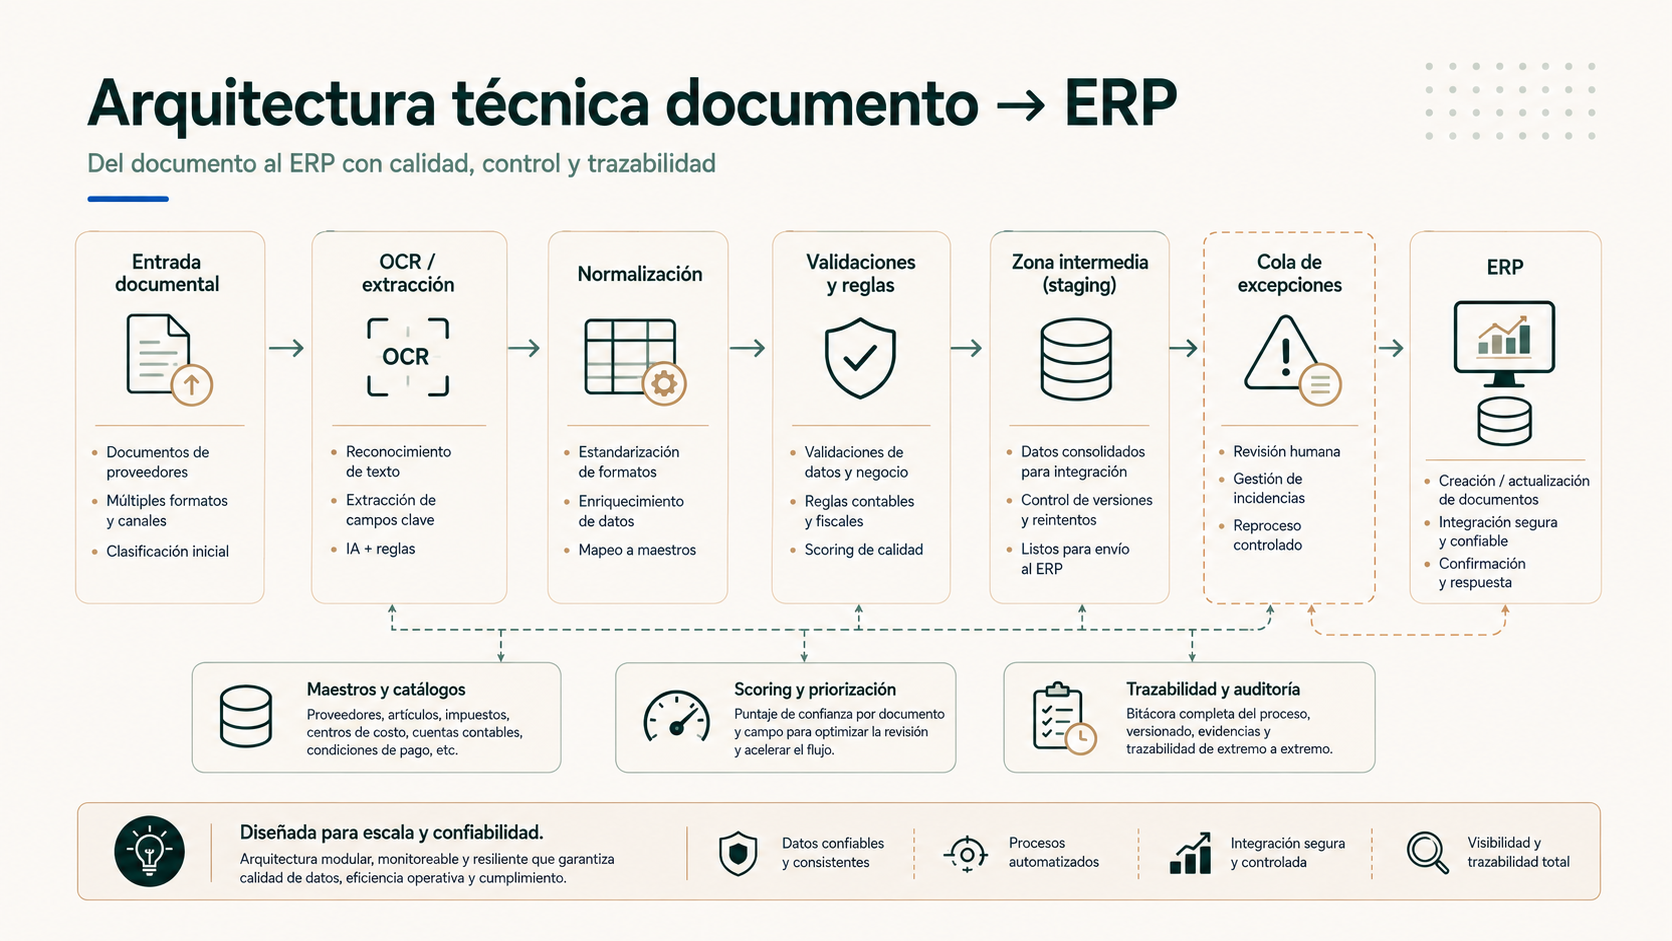
Arquitectura técnica: del documento al ERP sin saltarse controles
- Entrada. Email, portal, EDI, carpeta, API o escáner.
- Duplicado de archivo. Comprobar si ese fichero ya se procesó.
- Clasificación. Identificar tipo documental.
- OCR y extracción. Obtener campos y líneas.
- Normalización. Fechas, importes, monedas, unidades, referencias e impuestos.
- Resolución de maestros. Cliente, proveedor, artículos, almacenes y otros IDs internos.
- Comprobación de negocio. Pedidos, recepciones, precios, cantidades, duplicados y tolerancias.
- Zona intermedia. Preparar la transacción y aislar dudas.
- Cola de excepciones. Mostrar qué falla y qué debe decidir una persona.
- Integración ERP. API preferentemente; otros mecanismos si el sistema no ofrece una integración adecuada.
- Reintentos seguros. Evitar transacciones duplicadas.
- Auditoría. Registrar qué documento originó qué transacción y qué se corrigió.
Una excepción útil dice qué falta; “error de validación” no sirve
La cola de revisión es el puesto de trabajo de la persona que resuelve lo que la automatización no ha podido demostrar.
Los motivos deberían ser concretos:
- Proveedor no encontrado.
- Cliente ambiguo.
- SKU desconocido.
- Unidad sin equivalencia.
- Pedido inexistente.
- Cantidad superior a la permitida.
- Precio fuera de tolerancia.
- Factura probablemente duplicada.
- Impuesto incoherente.
- Documento ilegible.
- ERP no disponible.
- Permisos insuficientes.
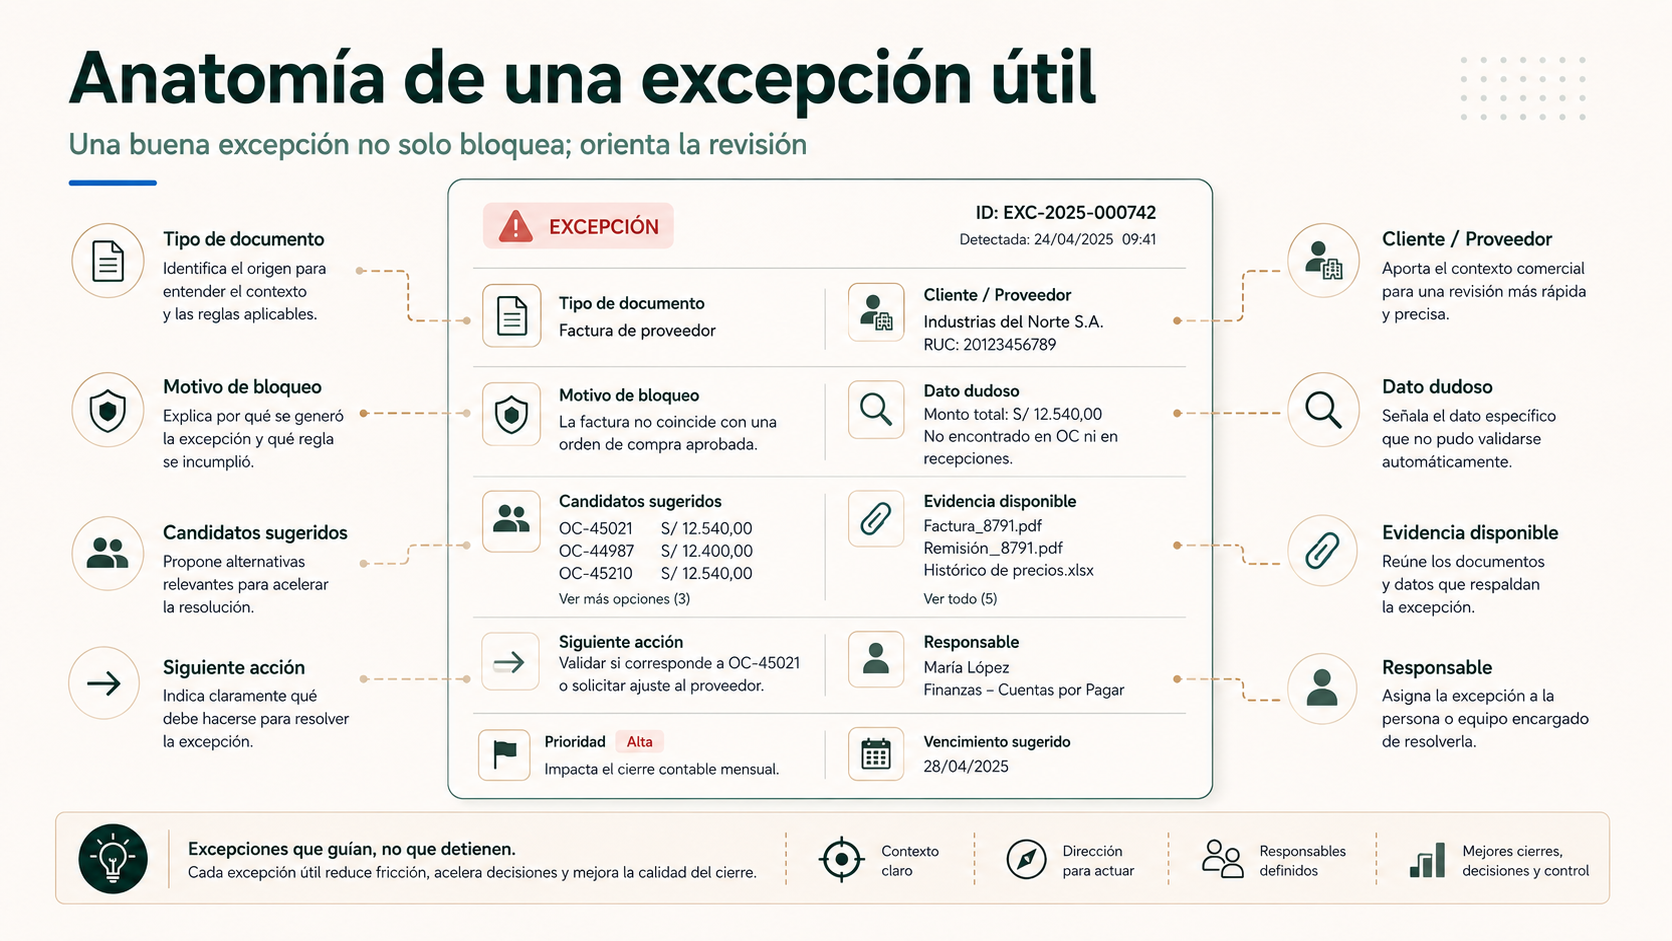
Una buena excepción también ofrece candidatos cuando los hay. Si una referencia externa puede corresponder a dos SKU, el revisor debería verlos con contexto, no tener que buscarlos desde cero.
Lo que no automatizaría directamente
- Crear artículos nuevos en el maestro porque la descripción “se parece” a algo.
- Dar de alta proveedores sin el circuito correspondiente.
- Inventar un SKU cuando no existe equivalencia.
- Modificar cantidades o precios para hacerlos cuadrar.
- Aceptar discrepancias fuera de tolerancia sin revisión.
- Registrar una recepción que nadie ha confirmado cuando el proceso exige comprobación física.
- Sobrescribir una transacción ya contabilizada sin una política explícita.
- Usar un usuario técnico con permisos mucho más amplios de los necesarios.
Antes del piloto, conviene medir cuánto “picado” existe de verdad
En algunos equipos la percepción es que introducir documentos consume muchísimo tiempo, pero el volumen real es bajo. En otros ocurre lo contrario: cada documento parece rápido, pero hay cientos al día y muchas correcciones posteriores. Medir evita diseñar el proyecto sobre una impresión.
Una muestra de una o dos semanas puede registrar:
- Número de pedidos, albaranes y facturas recibidos.
- Canal y formato de entrada.
- Número medio de líneas por documento.
- Minutos dedicados a introducir y comprobar cada tipo.
- Porcentaje que ya llega en formato estructurado.
- Referencias que obligan a buscar equivalencias.
- Documentos que requieren consultar a otra persona.
- Correcciones realizadas después de introducirlos en el ERP.
- Duplicados y documentos que vuelven a procesarse.
Estos datos ayudan a decidir dónde empezar. Quizá las facturas ya entren bastante bien mediante una solución del ERP y el problema real esté en los albaranes. O quizá los pedidos de un único cliente representen el 40 % del tecleo y utilicen siempre la misma plantilla. En ese caso, un piloto muy acotado puede producir más impacto que una plataforma documental genérica.
También permite separar dos retornos diferentes: ahorro de tiempo y reducción de errores. Un proceso puede ahorrar pocos minutos por documento y, aun así, justificar la automatización si evita errores costosos en referencias, cantidades o duplicados.
Cómo lanzaría un piloto documento → ERP
El piloto debería reducir variables, no intentar soportar desde el primer día todos los proveedores, documentos y casuísticas.
- Elegir un tipo documental. Por ejemplo, facturas de proveedor o pedidos de cliente.
- Seleccionar una muestra real. Incluir documentos limpios y problemáticos.
- Definir los campos críticos.
- Identificar los maestros del ERP que intervienen.
- Construir extracción y normalización sin escritura.
- Medir cuántas referencias se resuelven automáticamente.
- Añadir comprobaciones con pedidos o recepciones.
- Crear la zona intermedia y la cola de excepciones.
- Escribir primero como borrador o en un entorno de prueba cuando sea posible.
- Probar duplicados, caídas y reintentos.
- Ampliar formatos y proveedores solo cuando las excepciones importantes estén controladas.
Las métricas deberían medir calidad y operación, no solo velocidad: documentos procesados, líneas vinculadas automáticamente, revisiones necesarias, errores por categoría, duplicados detectados, tiempo documento → ERP, tiempo de revisión y correcciones posteriores.
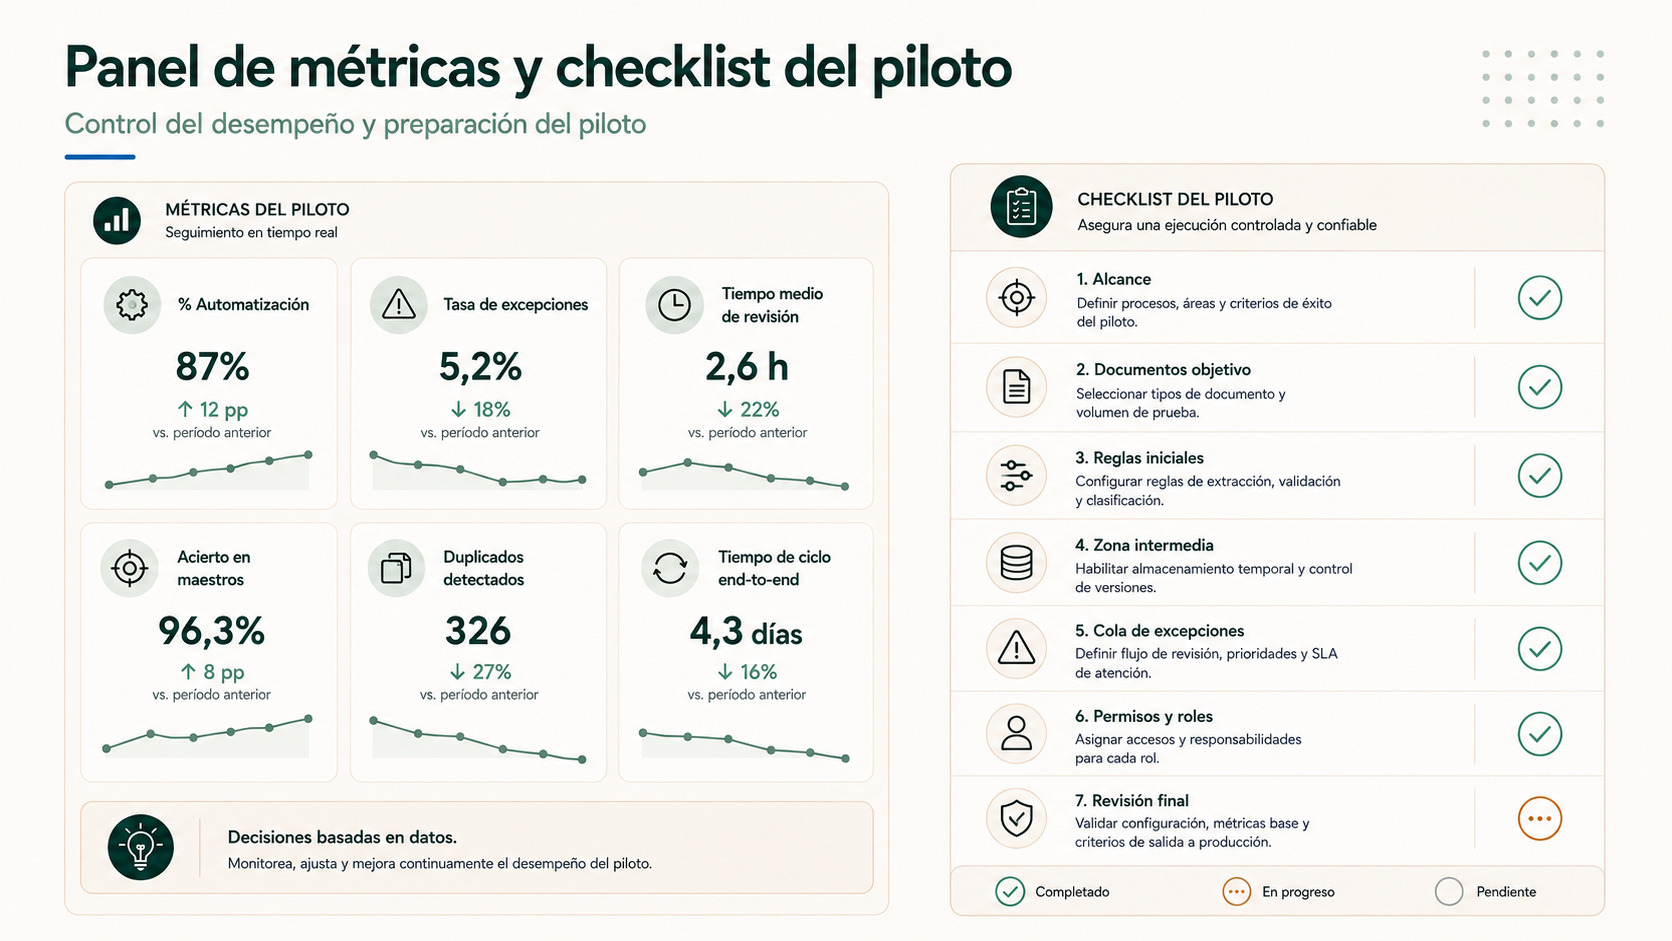
Cuando el proceso esté bien medido, resulta mucho más fácil valorar el coste de automatizarlo y decidir si el ahorro de trabajo manual, errores y tiempos de ciclo justifica ampliar el alcance.
Conclusión: el ERP no debería recibir lo que “cree” haber leído la IA
Un documento automatizado no termina cuando aparece texto estructurado en una pantalla. Termina cuando el sistema puede demostrar qué cliente, proveedor, artículo, cantidad y transacción representa ese documento.
Los casos claros pueden avanzar prácticamente solos. Los ambiguos deben detenerse justo donde aparece la duda, con suficiente contexto para que una persona la resuelva rápido.
Ese diseño permite automatizar mucho sin convertir el ERP en el lugar donde descubrimos los errores después.
El objetivo no es picar más rápido. Es dejar de picar los datos que ya existen y dedicar la intervención humana a comprobar únicamente lo que no puede demostrarse de forma fiable.
¿Quieres analizar un flujo de documentos hacia tu ERP?
Podemos revisar una muestra real de pedidos, albaranes o facturas, identificar qué se introduce manualmente, qué maestros intervienen, qué excepciones aparecen y qué posibilidades de integración ofrece el ERP.
Analizar un flujo documento → ERPFuentes
- Odoo 19 — Políticas de control de facturas.
Documentación sobre cantidades pedidas/recibidas y la verificación entre pedido, recepción y factura en el proceso de compra.
Consultar fuente - Odoo 19 — Digitalización de documentos.
Campos reconocidos por OCR, relación de facturas con pedidos de compra y uso de datos del pedido para completar información de la factura.
Consultar fuente - Microsoft Dynamics 365 Finance — Three-way matching policies.
Referencia oficial sobre comparación entre pedido, recepción y factura, incluidas tolerancias de cantidad y precio.
Consultar fuente - Microsoft Dynamics 365 Finance — Invoice Capture.
Documentación sobre ingestión de facturas, metadatos procedentes de OCR y controles de documentos duplicados.
Consultar fuente - Google Cloud Document AI — Procesadores preentrenados.
Invoice Parser para extraer datos de facturas y normalizar entidades documentales.
Consultar fuente - Google Cloud Document AI — Extractor personalizado.
Alternativa para definir entidades en tipos de documento sin un procesador preentrenado específico.
Consultar fuente - BOE — Real Decreto 238/2026.
Desarrollo del sistema de facturación electrónica obligatoria entre empresarios y profesionales en España.
Consultar fuente
Las capacidades concretas dependen de cada ERP, versión, licencia, configuración e integración disponible. Los ejemplos de Odoo, Dynamics 365 y Google Document AI se utilizan para ilustrar patrones técnicos, no para afirmar que todos los sistemas funcionan igual.
