
AUTOMATIZACIÓN DOCUMENTAL · OCR · IA · INTEGRACIONES
Automatización documental con IA
Leer un PDF es solo una parte del problema. Una automatización documental útil debe reconocer qué ha llegado, extraer los datos correctos, validarlos, resolver excepciones y completar una acción verificable en el sistema de destino.
Leer es una capacidad. Automatizar es un proceso.
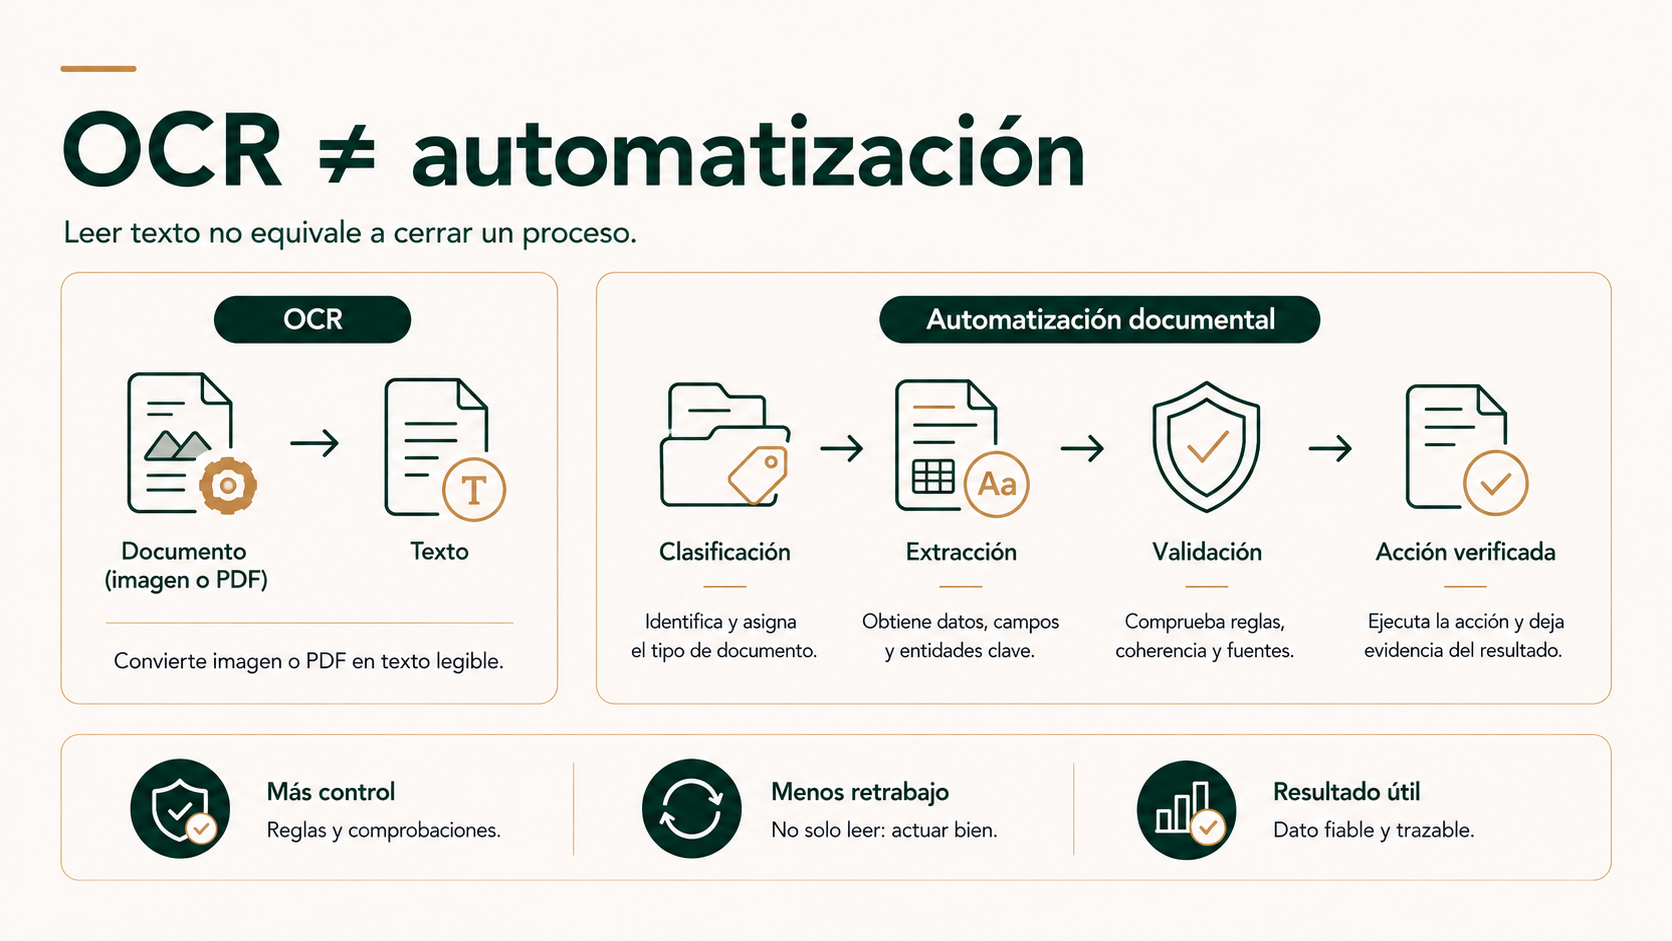
El OCR puede convertir una imagen en texto. Un extractor puede localizar campos. Un clasificador puede decidir qué tipo de documento ha llegado. Ninguna de esas capacidades, por separado, garantiza que el dato sea válido para negocio ni que pueda escribirse automáticamente en un ERP, CRM u otro sistema.
Una automatización documental completa necesita captura, preparación, clasificación, extracción, normalización, validación, acción y gestión de excepciones.
El objetivo no es conseguir que la IA “lea documentos”, sino convertir información documental en una acción fiable, trazable y verificable.
Un OCR puede leer una factura perfectamente y aun así registrar algo incorrecto
Una factura llega por correo. El sistema reconoce el texto, identifica el proveedor, extrae la fecha, el número de factura y el total. Todos los campos parecen correctos.
¿El proceso está automatizado?
Todavía no.
Falta saber si ese proveedor existe en el ERP, si está activo, si el número ya fue registrado, si el importe coincide con el pedido, si la moneda es correcta, si la factura pertenece realmente a esa sociedad, si el documento está completo y qué debe ocurrir cuando alguna de esas comprobaciones falla.
El salto importante en automatización documental no está entre “una persona lee” y “una IA lee”. Está entre extraer información y convertir esa información en una operación controlada.
OCR → texto. Automatización documental → proceso terminado o excepción controlada.
Esta diferencia importa porque muchas demos funcionan extraordinariamente bien con un documento ideal: se carga un PDF y aparecen unos campos estructurados. Pero el trabajo empresarial empieza justo después.
Si estás valorando qué procesos merece la pena abordar, conviene empezar por el criterio general de qué procesos automatizar y cuáles dejar como están. No todo flujo documental tiene suficiente volumen, estabilidad o impacto como para justificar la misma arquitectura.
OCR, extracción, clasificación y automatización documental no son sinónimos
El vocabulario del mercado mezcla conceptos con facilidad. Conviene separarlos porque cada uno resuelve una parte distinta.
OCR
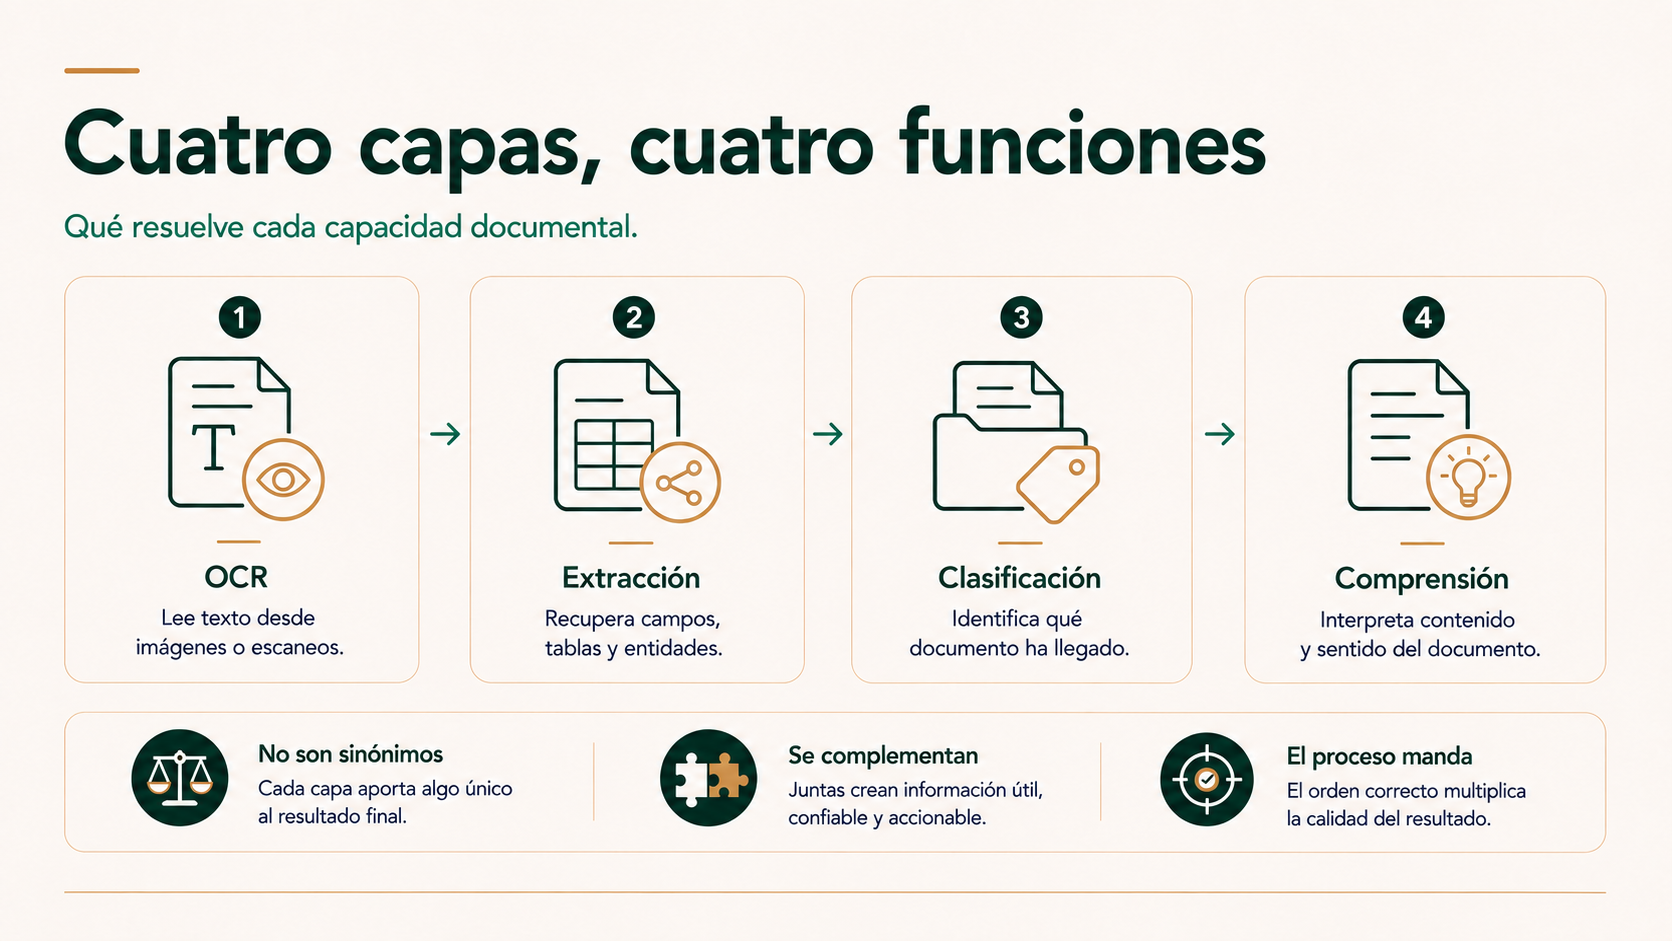
Reconocimiento óptico de caracteres. Convierte texto presente en una imagen o documento escaneado en una representación digital utilizable.
Extracción
Busca datos concretos: proveedor, fecha, número de documento, importe, dirección, líneas de producto o cualquier campo definido.
Clasificación
Determina qué ha llegado: factura, albarán, contrato, justificante, formulario, parte, certificado u otra categoría.
Automatización
Utiliza esos resultados dentro de un proceso: valida, consulta sistemas, decide una ruta, crea una tarea, escribe un registro o deriva una excepción.
Google Cloud Document AI diferencia actualmente procesadores de digitalización/OCR, extracción y clasificación. Microsoft Document Intelligence combina OCR con tecnologías de comprensión documental para extraer texto, tablas, estructura y pares clave-valor, y ofrece modelos preconstruidos y personalizados. Amazon Textract distingue igualmente detección de texto de análisis de formularios, tablas, consultas y documentos como facturas o recibos.
Es decir: incluso los propios proveedores estructuran el problema en capacidades diferentes.
¿Y qué significa IDP?
IDP son las siglas de Intelligent Document Processing, normalmente traducido como procesamiento inteligente de documentos. Es un término de mercado que suele agrupar OCR, clasificación, extracción, modelos de machine learning o IA generativa y lógica de procesamiento.
Puede ser útil para describir una categoría tecnológica, pero no sustituye al análisis del proceso. Dos empresas pueden comprar una solución catalogada como IDP y necesitar arquitecturas completamente diferentes porque una solo quiere indexar contratos y otra pretende crear asientos o pedidos automáticamente.
Clasificar y separar puede ser tan importante como extraer
En un entorno real, el problema rara vez llega como una carpeta perfectamente ordenada con un único tipo documental. Un buzón puede recibir una factura junto con un albarán, fotografías, justificantes, contratos, comunicaciones y PDFs que contienen varios documentos concatenados.
Antes de preguntar “¿qué campos extraigo?”, puede ser necesario responder “¿qué documento es este?” y “¿dónde empieza y termina cada documento?”. Esa clasificación decide qué modelo, reglas y sistema de destino deben utilizarse después.
Una clasificación incorrecta puede tener más impacto que un campo mal leído. Si una factura se interpreta como justificante, o un anexo se asocia al expediente equivocado, todo el flujo posterior puede ejecutarse correctamente sobre una premisa incorrecta.
Por eso conviene evaluar clasificación y separación con métricas propias, especialmente cuando el canal de entrada mezcla documentos distintos. En una gestoría, por ejemplo, esa necesidad puede aparecer dentro de un proceso de correo, pero el diseño específico de bandejas de entrada pertenece a la guía sobre automatizar el correo de una gestoría.
Las ocho capas de una automatización documental
En lugar de pensar en “leer PDFs”, resulta más útil dibujar el flujo completo desde que el documento aparece hasta que el proceso termina.
Entrada y captura
El documento puede llegar por email, formulario, carpeta, escáner, API, portal, aplicación móvil o canal de mensajería. La primera decisión es identificar de dónde llega y con qué contexto.
Preparación
Formato, rotación, calidad, páginas vacías, duplicados, documentos concatenados o imágenes poco legibles pueden necesitar tratamiento antes de extraer nada.
Clasificación
El sistema determina qué tipo de documento tiene delante y qué flujo debe utilizar. Un error aquí puede enviar un archivo perfectamente legible al proceso equivocado.
Extracción
Se recuperan los datos necesarios: texto, campos, tablas, líneas, entidades o relaciones relevantes para el proceso.
Normalización y resolución
Los valores se convierten a formatos homogéneos y, cuando procede, se relacionan con clientes, proveedores, productos, contratos o expedientes existentes.
Validación
Se comprueba que los datos sean técnicamente válidos y coherentes con las reglas del negocio y las fuentes de verdad disponibles.
Acción
El sistema crea una tarea, actualiza un expediente, prepara una operación o escribe en ERP, CRM, gestor documental u otra aplicación.
Verificación y excepción
Se comprueba que la acción terminó correctamente y se deriva a revisión aquello que no puede resolverse de forma segura.
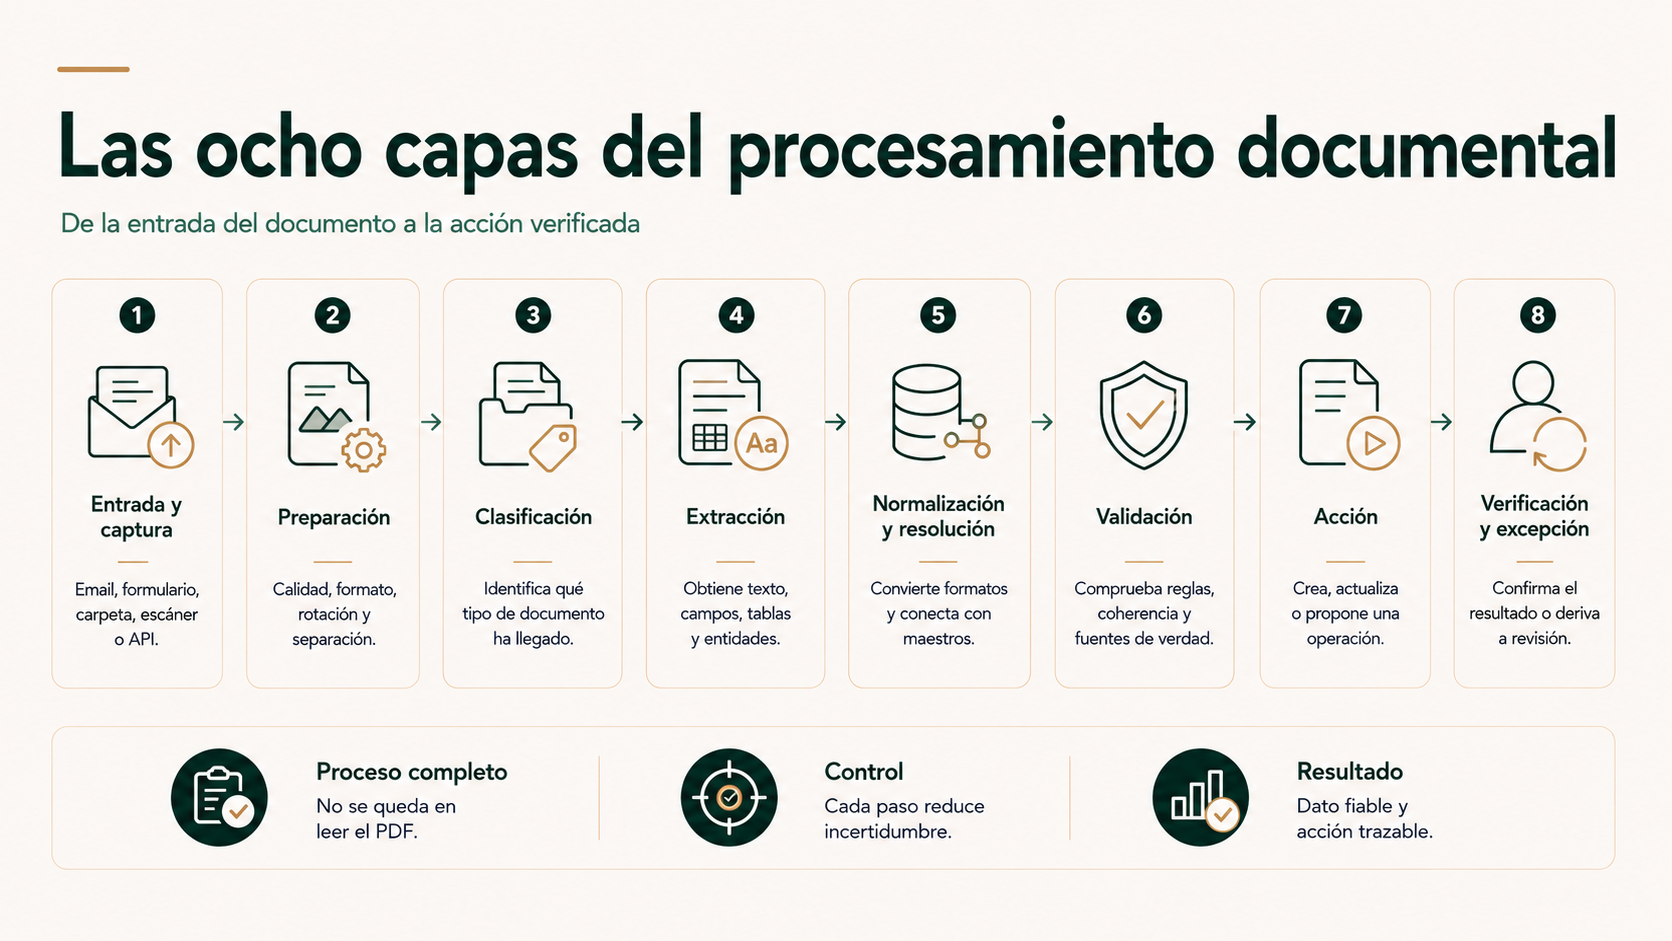
No todos los proyectos necesitan ocho componentes tecnológicos distintos. Varias capas pueden estar resueltas por una misma plataforma. Lo importante es que las responsabilidades existan, aunque la implementación sea sencilla.
Extraer un valor y convertirlo en un dato útil son tareas diferentes
Supongamos que tres documentos expresan el mismo importe como 1.234,50 €, EUR 1,234.50 o 1 234,50. La lectura puede ser correcta en los tres casos, pero el sistema de destino probablemente espera una representación homogénea.
Lo mismo ocurre con fechas, direcciones, unidades, identificadores fiscales, referencias internas o nombres de empresa.
Y hay un paso todavía más importante: resolver entidades.
Que un documento diga “Transportes García” no significa que el sistema sepa automáticamente qué proveedor corresponde. Puede haber varias sociedades, nombres comerciales, delegaciones o registros históricos.
La automatización debe decidir si puede asociar ese texto con un maestro existente y con qué grado de seguridad.
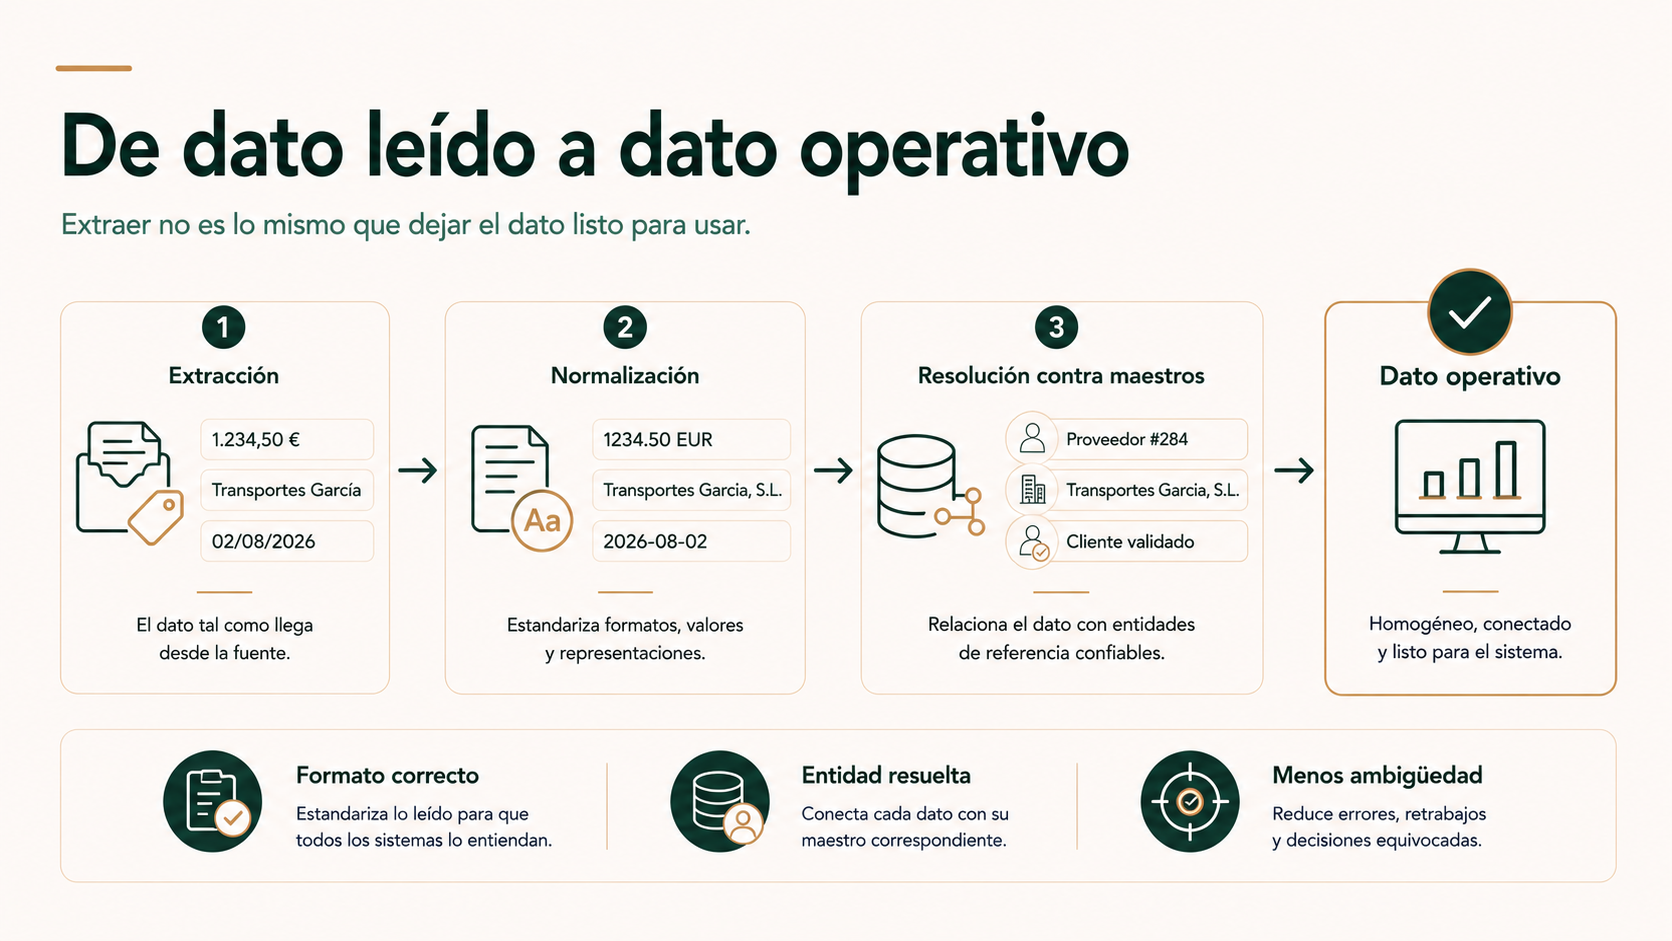
Esta es una de las razones por las que la complejidad de un proyecto documental depende mucho más del proceso que del número de páginas.
La validación importa más que una cifra global de precisión
Es tentador resumir la calidad de un sistema documental con una cifra: “95 % de precisión”. El problema es que esa media puede ocultar justo el error que importa.
Un modelo puede acertar casi siempre el nombre del proveedor y fallar ocasionalmente el IBAN, el importe o la referencia de pedido. El impacto empresarial no es equivalente.
Por eso conviene separar varias validaciones.
| Tipo | Qué comprueba | Ejemplo |
|---|---|---|
| Técnica | Formato, tipo y presencia de campos. | La fecha existe y tiene un formato interpretable. |
| De negocio | Reglas y estados permitidos. | El importe no supera una tolerancia definida. |
| Contra maestros | Correspondencia con entidades existentes. | El proveedor existe y está activo. |
| Cruzada | Coherencia con otros documentos o sistemas. | Factura, pedido y recepción son compatibles. |
| De incertidumbre | Calidad/confianza del resultado. | Un campo dudoso requiere otra comprobación. |
Amazon Textract, por ejemplo, devuelve confidence scores —puntuaciones de confianza— y recomienda elegir umbrales según la sensibilidad de la aplicación. No propone una cifra universal válida para cualquier proceso: el umbral adecuado depende del riesgo.
Confianza del modelo ≠ validez del dato para negocio.
Un campo con alta confianza todavía puede ser incompatible con un pedido. Y un campo con confianza menor puede verificarse de forma determinista contra una base de datos.
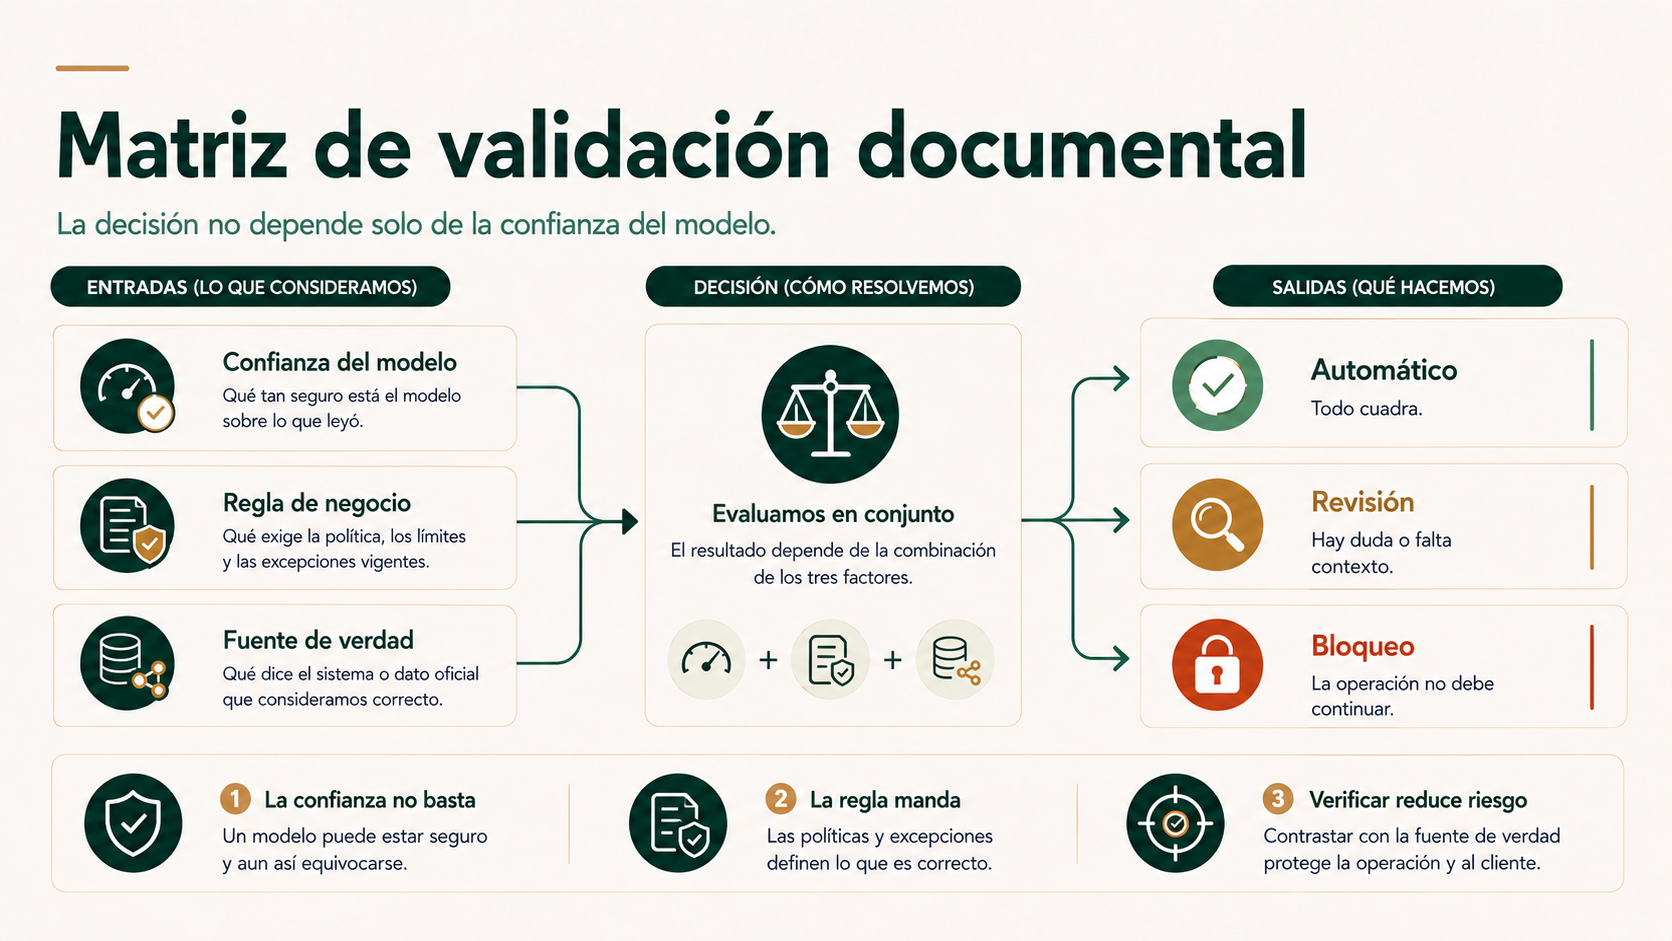
Dónde encaja la IA generativa y por qué no sustituye automáticamente a todo lo anterior
Los modelos generativos han ampliado mucho las posibilidades de tratamiento documental. Son útiles cuando el formato cambia, la información aparece en texto libre o necesitamos extraer significado en lugar de una posición fija.
Eso no convierte en innecesarios el OCR, los parsers especializados o las reglas.
Microsoft diferencia actualmente Document Intelligence —orientado a extracción fiable de documentos estructurados— de otras capacidades basadas en modelos de lenguaje para contenido más complejo y multimodal. Google mantiene OCR, clasificadores, procesadores preentrenados y extractores personalizados como capacidades diferenciadas.
La decisión depende del problema.
Reglas y modelos especializados
Encajan especialmente bien cuando el esquema es conocido, los campos están definidos y necesitamos comportamiento predecible y verificable.
IA generativa
Aporta valor cuando el documento es variable, el lenguaje es menos estructurado o hace falta interpretar contenido semántico antes de convertirlo a un esquema.
Una buena arquitectura puede usar ambos. Por ejemplo: IA para localizar una cláusula en un contrato y reglas deterministas para comprobar que la fecha obtenida cae dentro de un periodo permitido.
La regla práctica es sencilla: IA donde la variabilidad lo exige; reglas donde la condición puede expresarse claramente.
Esta distinción será todavía más importante cuando tratemos específicamente la diferencia entre workflows y agentes de IA.
Staging: una zona intermedia antes de tocar el sistema definitivo
Staging puede traducirse aquí como zona intermedia de validación.
En lugar de hacer documento → IA → ERP, podemos hacer documento → extracción → validación → staging → ERP.
En esa zona intermedia, los datos pueden quedar pendientes de una comprobación automática adicional, una corrección o una aprobación.
No tiene por qué ser una aplicación compleja. Dependiendo del volumen puede ser una cola de revisión, una tabla controlada o una interfaz específica para excepciones.
Es especialmente útil cuando la operación final es sensible, existen maestros ambiguos o el sistema necesita acumular contexto antes de actuar.
Human-in-the-loop no significa revisar el 100 %
Si una persona tiene que comprobar todos los documentos exactamente igual que antes, probablemente solo hemos desplazado trabajo.
Una revisión humana bien diseñada es selectiva.
La futura guía específica sobre human-in-the-loop profundizará en revisión, aprobación, excepción y toma de control. Aquí lo importante es entender su función dentro del proceso documental.
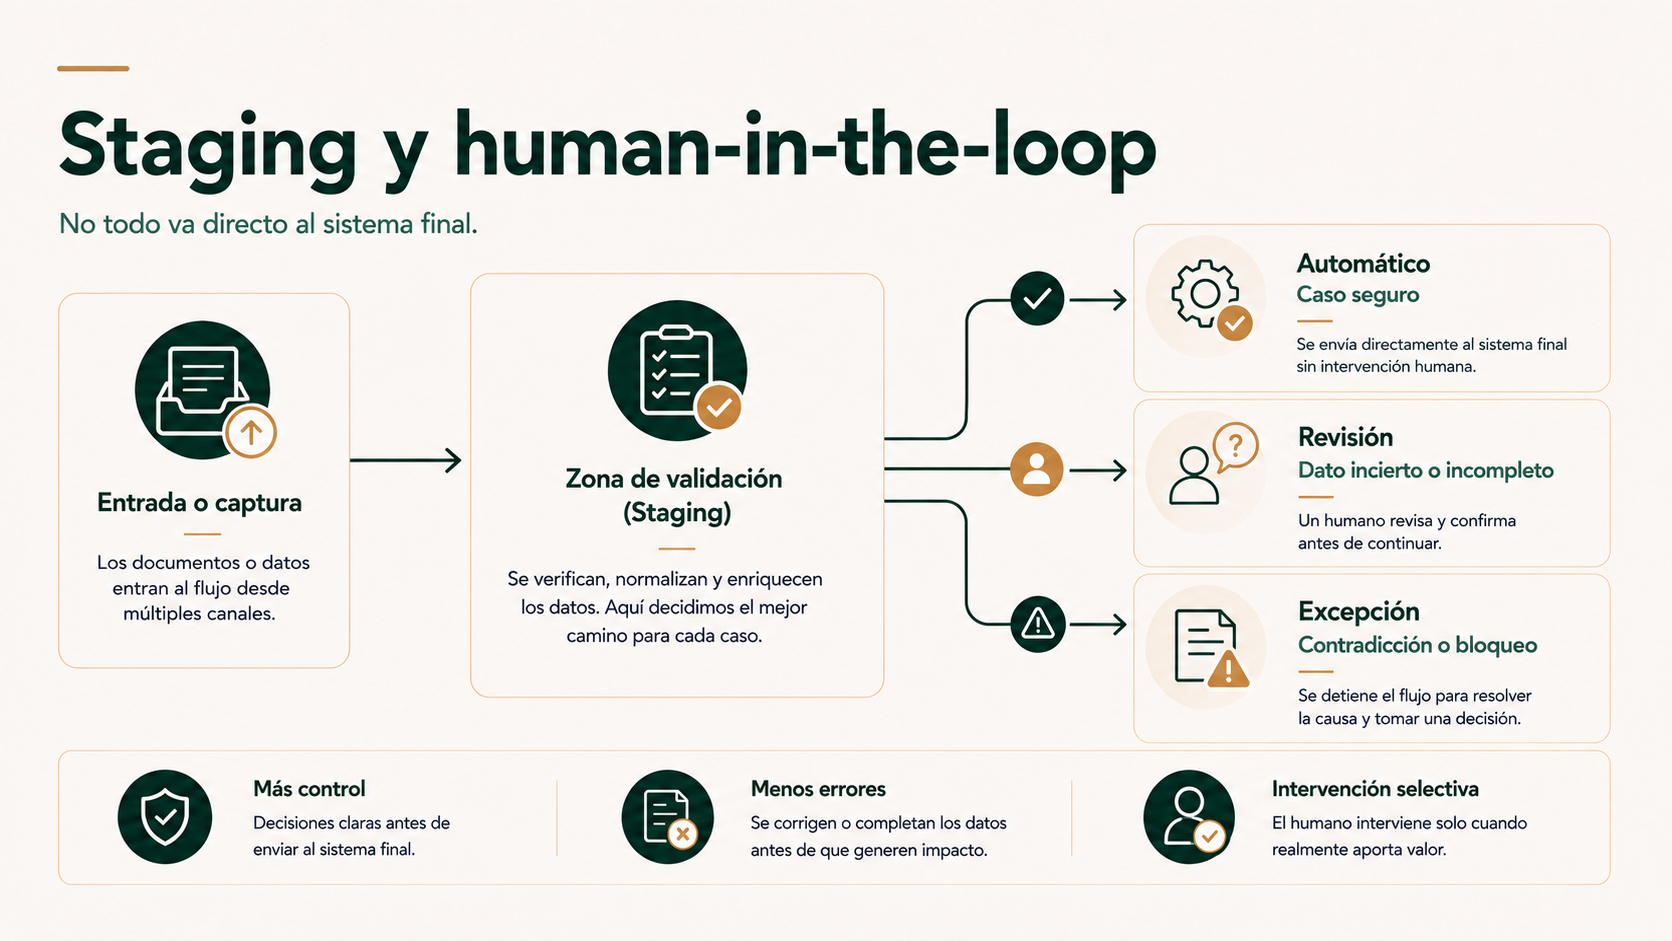
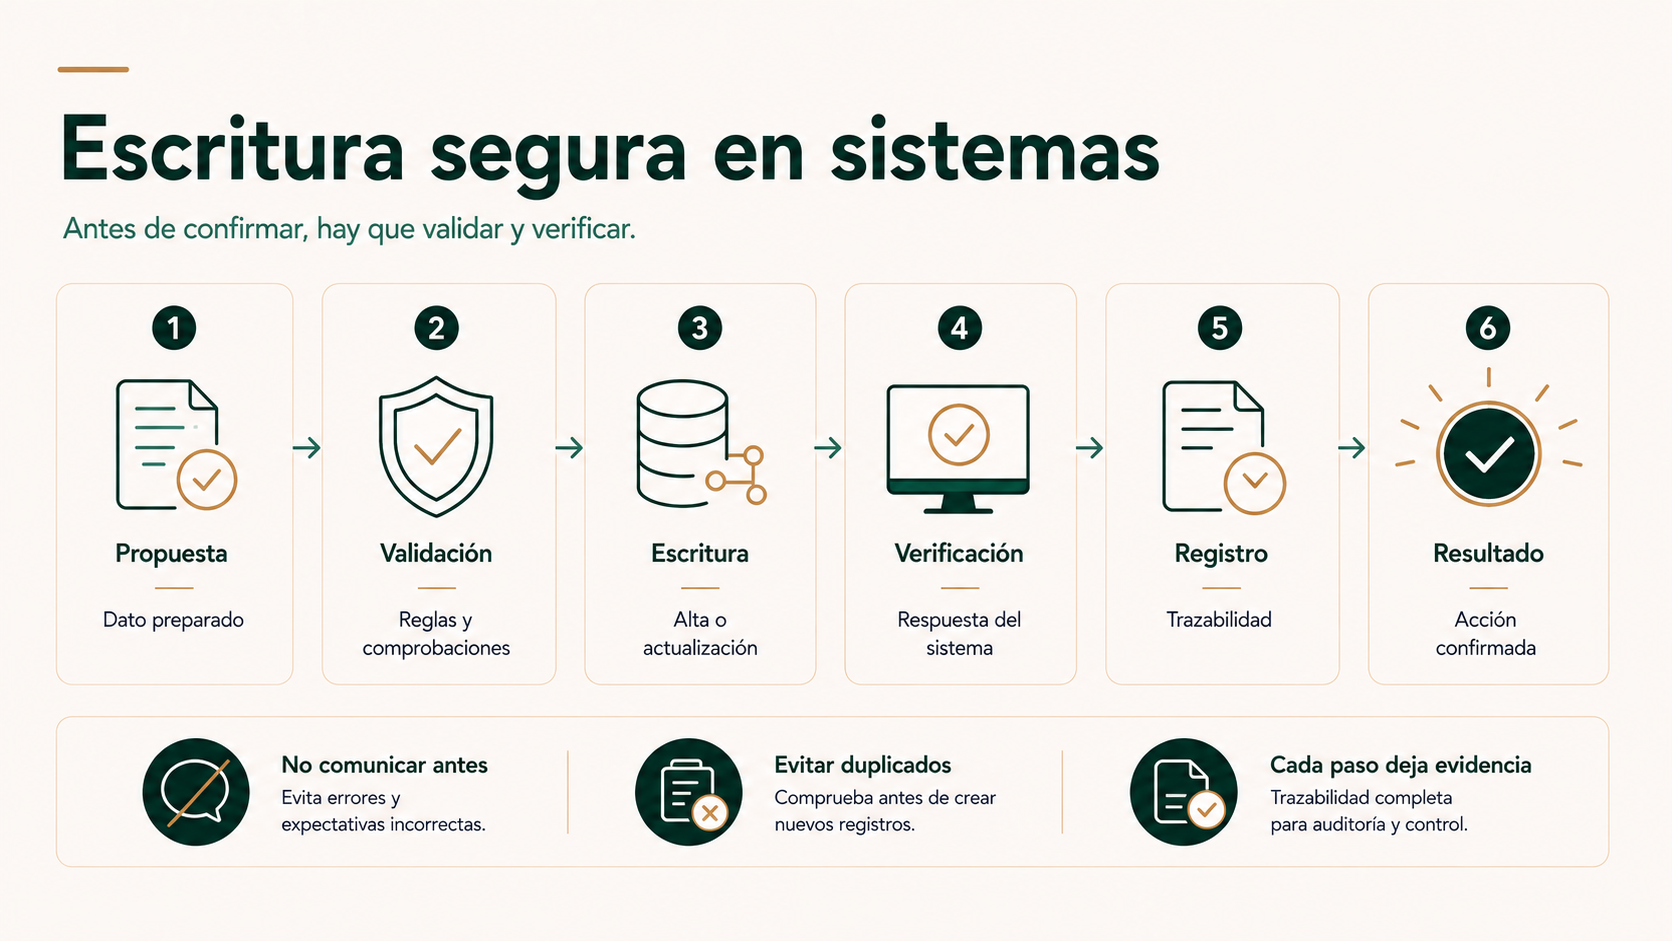
“Escribir en el ERP” es una operación distinta de “extraer datos”
Una demo puede terminar cuando aparecen los campos estructurados en pantalla. Un proceso empresarial suele terminar más tarde.
Si el objetivo es crear o actualizar un registro, debemos comprobar qué sistema es la fuente de verdad, qué entidad debe modificarse, qué permisos tiene la integración, si el registro ya existe, qué ocurre si la llamada falla, si un reintento puede duplicar la operación y cómo verificamos que el sistema aceptó realmente el cambio.
Un patrón razonable sería:
extraer → validar → resolver → proponer → escribir → verificar → registrar resultado
La palabra verificar es importante. El sistema no debería comunicar “factura registrada”, “cliente actualizado” o “documento archivado” solo porque envió una petición. Debe comprobar la respuesta del destino.
En industria, esta problemática se vuelve especialmente visible en el flujo de pedidos, albaranes y facturas hacia el ERP, donde además aparecen matching, duplicados y controles específicos.
Documento, dato y expediente no son lo mismo
Automatizar tampoco significa copiar todo el contenido a todas las aplicaciones.
El documento original puede necesitar conservarse como evidencia o referencia. El dato estructurado sirve para operar. El expediente reúne documentos, estados, responsables y decisiones.
Cada uno puede tener una fuente de verdad distinta.
Un contrato puede permanecer en un gestor documental mientras el CRM recibe solo fecha, cliente, tipo y estado. Una factura puede conservarse en el repositorio original mientras el ERP recibe los campos contables necesarios.
Este diseño evita crear copias sin finalidad y reduce inconsistencias.
Exactitud y minimización también son decisiones de arquitectura
Cuando los documentos contienen datos personales, la automatización no puede diseñarse únicamente desde la comodidad técnica.
La Agencia Española de Protección de Datos publicó en julio de 2026 una nota técnica específica sobre calidad, exactitud y minimización en tratamientos que incorporan sistemas de IA. El principio práctico es relevante para cualquier flujo documental: tratar los datos necesarios para una finalidad concreta y prestar atención a su exactitud cuando la salida del sistema puede producir acciones o decisiones posteriores.
Eso se traduce en preguntas operativas: qué campos necesitamos realmente, qué información debe abandonar el sistema origen, qué proveedor procesa el archivo y en qué condiciones, cuánto tiempo debe conservarse, quién puede acceder al original y qué nivel de verificación exige cada dato antes de utilizarlo.
No todos los documentos tienen la misma sensibilidad. Un parte interno, una factura y un informe médico plantean riesgos muy distintos.
Por eso seguridad y privacidad no deberían añadirse al final del proyecto. Forman parte de la definición de las capas, permisos, registros y excepciones desde el principio.
La calidad del documento de entrada condiciona todo lo que viene después
Un sistema puede estar correctamente diseñado y recibir una fotografía torcida, un PDF dañado, un escaneo borroso, una tabla partida entre páginas o un documento incompleto.
Google Document AI incorpora incluso análisis de calidad dentro de determinadas capacidades OCR. AWS recomienda cuidar el documento de entrada y utilizar las señales de confianza devueltas por el servicio de acuerdo con el caso de uso.
La respuesta correcta ante un documento ilegible no es rellenar el hueco con una suposición.
“No puedo determinar este dato con suficiente seguridad” es una salida válida del sistema. Una automatización madura necesita saber detenerse.
Por eso la preparación y la detección de calidad están al principio del pipeline, no al final.
Las excepciones no son el ruido del proceso: son parte del diseño
Un flujo documental de producción debería saber qué hacer, como mínimo, cuando ocurre alguno de estos casos:
| Excepción | Ejemplo | Salida posible |
|---|---|---|
| Documento no reconocido | No pertenece a ninguna clase conocida. | Clasificación manual o nueva ruta. |
| Ilegible/incompleto | Falta una página o no se lee un campo. | Solicitar nuevo documento. |
| Campo ausente | No aparece un dato obligatorio. | Completar o detener. |
| Dato incierto | Dos valores posibles. | Revisión selectiva. |
| Entidad ambigua | Dos proveedores podrían coincidir. | Resolución humana/regla adicional. |
| Duplicado | El documento puede haberse procesado antes. | Bloquear y comprobar. |
| Contradicción | El documento no coincide con otro sistema. | Excepción de negocio. |
| Error de destino | ERP no responde o rechaza la operación. | Reintento controlado/escalado. |
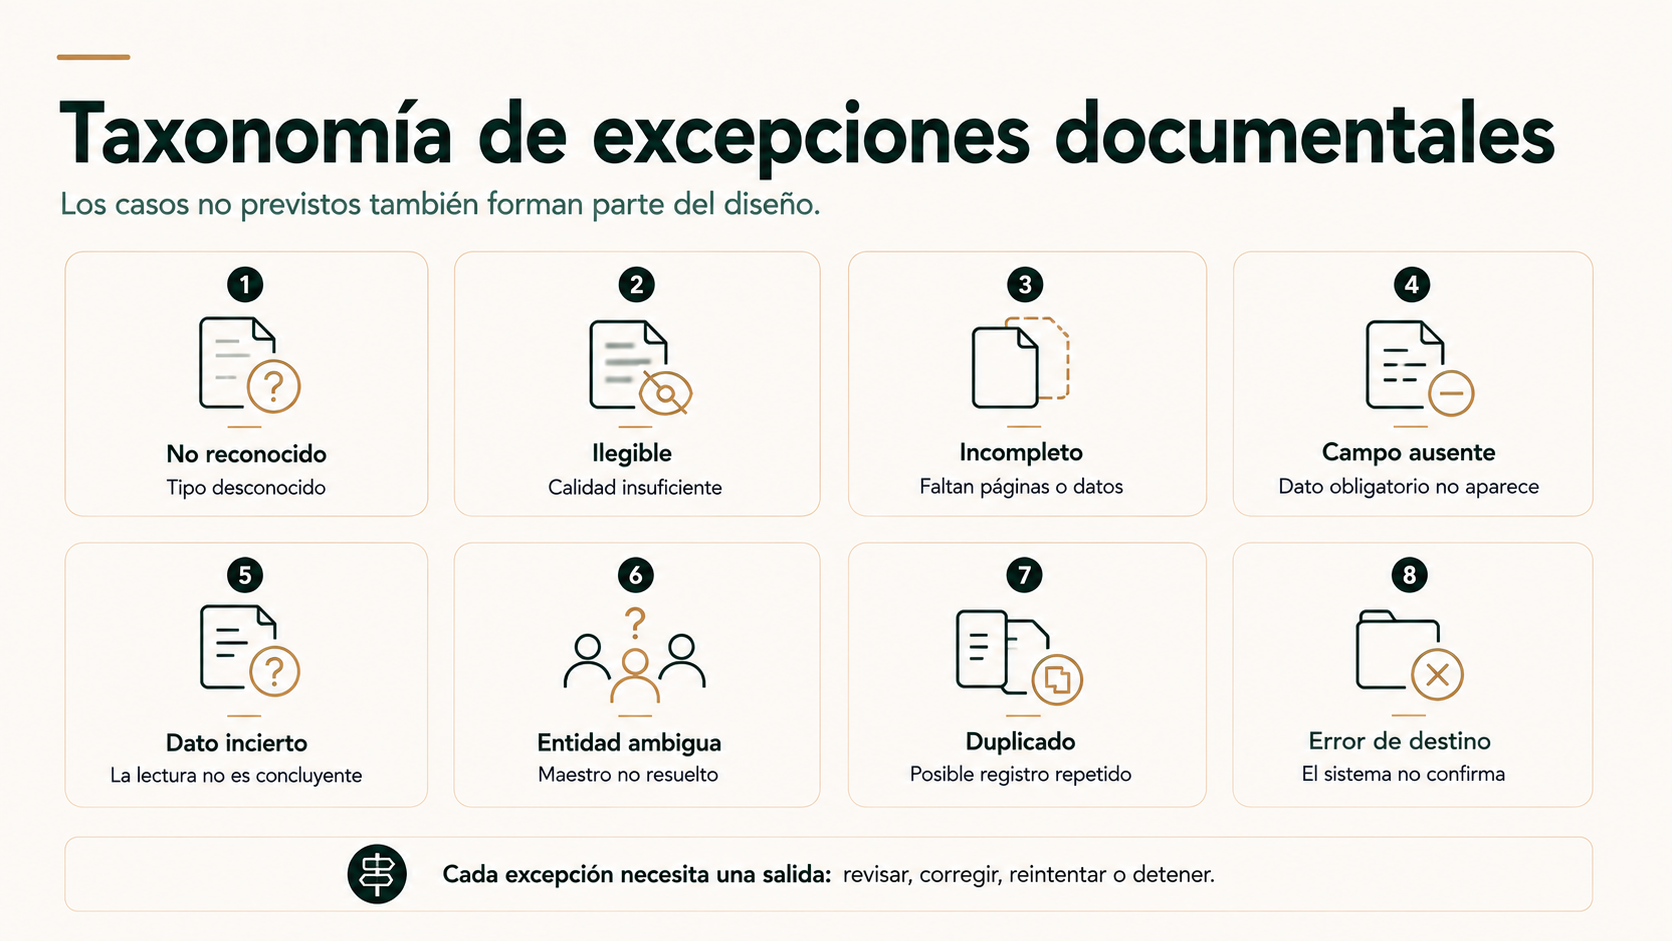
Diseñar solo el camino perfecto es una de las razones por las que una prueba funciona y producción se atasca.
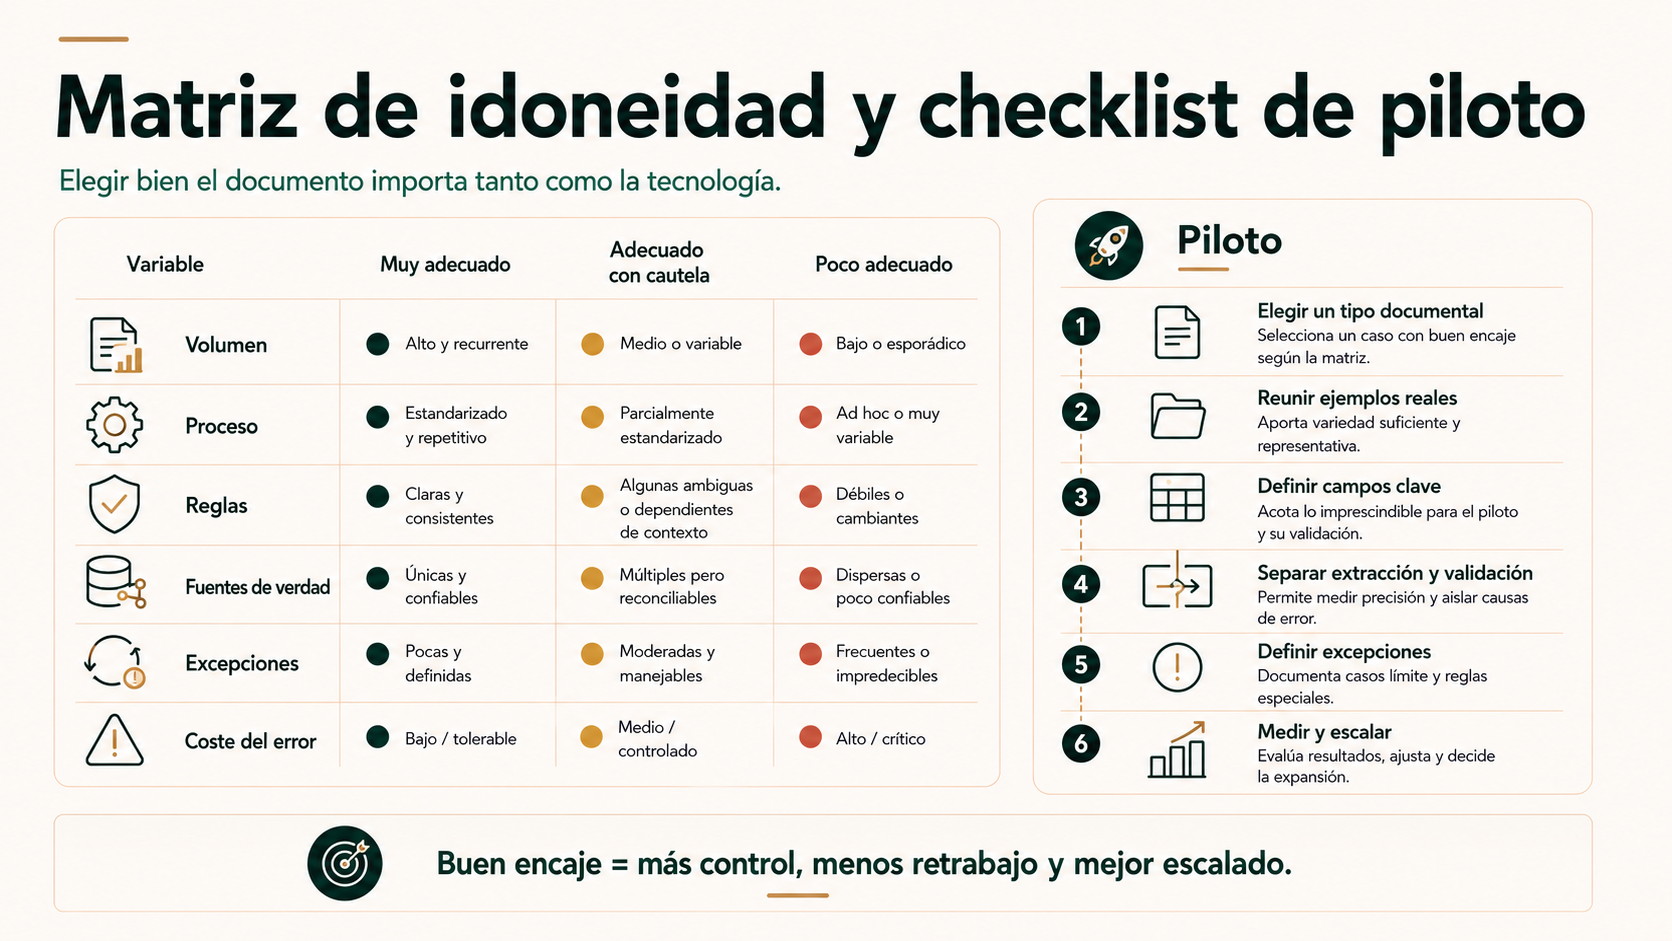
Qué documentos encajan mejor con la automatización
La pregunta útil no es “¿se puede leer este documento con IA?”. En muchos casos la respuesta será sí. La pregunta es si compensa convertir esa lectura en un proceso automatizado.
| Variable | Mejor encaje | Mayor cautela |
|---|---|---|
| Volumen | Alto/repetitivo. | Muy bajo o esporádico. |
| Proceso | Estable y conocido. | Cambia constantemente. |
| Datos requeridos | Campos definidos. | Objetivo ambiguo. |
| Fuentes de verdad | Maestros y sistemas disponibles. | No existe referencia fiable. |
| Reglas | Comprobaciones expresables. | Juicio experto difícil de formalizar. |
| Excepciones | Conocidas y clasificables. | Gran variedad sin patrón. |
| Coste del error | Controlable o verificable. | Muy alto sin posibilidad de comprobación. |
| Sistema destino | Integrable y con propietario claro. | Sin API/proceso estable o sin responsable. |
Un documento poco estructurado no es automáticamente un mal candidato. Puede existir un gran volumen y una extracción semántica muy valiosa. Del mismo modo, una factura perfectamente estructurada puede no justificar un proyecto si llegan cuatro al mes.
El criterio debe combinar volumen, variabilidad, riesgo, reglas e impacto.
El mismo tipo de documento puede requerir arquitecturas distintas
Dos empresas pueden recibir facturas y, sin embargo, necesitar soluciones muy diferentes. Una quizá solo quiere archivarlas con metadatos para poder buscarlas. Otra necesita comprobar proveedor, pedido, recepción y tolerancias antes de registrar la operación. Una tercera puede trabajar con un ERP que ya incorpora buena parte de esas capacidades.
Por eso no tiene sentido definir la solución únicamente a partir del nombre del documento. Hay que analizar qué acción empresarial pretende desencadenar.
Lo mismo ocurre con contratos, formularios, partes o informes. Si el objetivo es encontrar una cláusula, la arquitectura puede terminar en una consulta. Si el objetivo es actualizar un expediente, aparecen identificación, validación e integración. Si además esa actualización genera una acción económica, el nivel de control debe aumentar.
Qué determina realmente la complejidad y el coste de un proyecto documental
El número de páginas procesadas influye en el consumo de servicios, pero rara vez explica por sí solo el coste de diseñar una automatización.
La complejidad aumenta con el número de tipos documentales, la variabilidad de formatos, la calidad de entrada, la cantidad de campos, la necesidad de resolver datos contra maestros, el número de reglas, la frecuencia de excepciones, los sistemas de destino y el nivel de seguridad o trazabilidad exigido.
También importa cuánto comportamiento específico hay que construir alrededor de la extracción. Un parser preentrenado puede resolver rápidamente campos habituales de una factura estándar. Si el negocio necesita interpretar referencias internas propias, asociarlas con un catálogo, comprobar condiciones particulares y después escribir en un sistema sin conector directo, el problema ya no es principalmente de OCR.
Esto explica por qué dos proyectos que procesan “facturas” pueden tener presupuestos muy distintos. La metodología económica general está desarrollada en la guía sobre precio de la automatización de procesos.
Casos de uso que comparten arquitectura, no necesariamente solución
Facturas, gastos, pedidos, albaranes, formularios de alta, contratos, anexos, partes de trabajo, informes y expedientes pueden compartir las ocho capas descritas en este artículo. Eso no significa que deban usar el mismo modelo, proveedor o grado de automatización.
En gestorías, por ejemplo, la pieza específica sobre automatización documental profundiza en controles y excepciones propios del trabajo contable y administrativo. En despachos de abogados, documentos y expedientes añaden además límites de secreto profesional, permisos y criterio jurídico. En industria, el flujo de documentos hacia ERP añade matching y escritura segura. La función de esta guía transversal es proporcionar el mapa común y dejar que cada vertical desarrolle después sus reglas particulares.
Qué métricas utilizar en lugar de quedarse con “la IA acierta mucho”
Una evaluación útil no debería mirar únicamente la precisión media de extracción.
Conviene medir precisión por campo crítico, porcentaje de documentos procesados sin intervención, tasa de excepciones y motivo, tiempo de resolución, duplicados detectados o evitados, errores que alcanzan el sistema destino, documentos ilegibles, fallos de integración, tiempo total de ciclo y, cuando sea relevante, coste por documento procesado.
Una automatización que extrae muy bien pero produce una cola enorme de excepciones quizá no está resolviendo el problema. Otra con menor automatización inicial puede aportar más valor si detecta correctamente los casos seguros y reduce retrabajo.
Cómo empezar: un tipo documental, errores reales y un sistema de destino
Un piloto útil no necesita abarcar todos los documentos de la empresa.
- Elegir una familia concreta. Facturas de proveedor, partes, formularios o contratos con un objetivo definido.
- Reunir ejemplos representativos. No solo los limpios: también fotografías malas, campos vacíos y formatos poco frecuentes.
- Definir qué datos hacen falta realmente. Extraer veinte campos cuando se utilizan seis aumenta complejidad sin beneficio.
- Separar extracción de validación. Documentar qué comprueba el modelo y qué comprueba una regla o sistema.
- Definir las excepciones antes de automatizar. Qué bloquea, qué revisa y quién resuelve.
- Conectar un destino concreto. Una automatización sin acción final puede evaluar extracción, pero no el proceso completo.
- Medir por campo y por resultado. No solo “documentos acertados”.
- Escalar después de controlar los errores críticos.
Antes de construir, también conviene valorar el coste total. El precio de una automatización documental depende de tipos de documento, variabilidad, campos, reglas, fuentes de verdad, integraciones, revisión y mantenimiento; no del número de páginas solamente. La guía sobre cuánto cuesta automatizar un proceso desarrolla esa lógica económica.
Cuándo dejar el proceso manual, al menos por ahora
Que la tecnología pueda extraer datos no implica que el proyecto sea prioritario.
Puede ser mejor mantener intervención manual cuando el volumen es mínimo, el proceso cambia constantemente, no existe una definición compartida de “correcto”, la acción requiere juicio experto difícil de verificar o ni siquiera está claro cuál debe ser el sistema de destino.
También puede ser razonable automatizar solo una parte. Por ejemplo, clasificar y preparar documentos para una persona, sin escribir automáticamente en ningún sistema. O extraer cinco campos y dejar la aprobación final en manos del responsable.
Una arquitectura parcial pero controlada suele ser preferible a una automatización end-to-end que necesita demasiadas suposiciones.
La automatización documental empieza después de leer el PDF
OCR, parsers, modelos de extracción e IA generativa han hecho mucho más fácil convertir documentos en información estructurada.
Pero una empresa no obtiene valor porque un modelo muestre correctamente el número de factura en una pantalla. Lo obtiene cuando ese dato entra en un proceso fiable.
Eso exige decidir qué documento ha llegado, qué campos importan, cómo se normalizan, contra qué se comprueban, qué acción está permitida, qué sistema manda, qué hacemos con la incertidumbre y cómo verificamos el resultado.
La automatización documental empieza cuando dejamos de preguntar si la IA puede leer el PDF y preguntamos qué debe ocurrir después de leerlo.
¿Tienes un proceso documental que todavía depende de leer, copiar, comprobar y volver a introducir datos?
Podemos revisar un flujo real —documentos, reglas, excepciones, sistemas y volumen— para determinar qué parte puede automatizarse, qué controles necesita y dónde sigue teniendo sentido la intervención humana.
Analizar un flujo documental realFuentes
- Google Cloud — Document AI: lista de procesadores.
Documentación oficial sobre OCR, procesadores preentrenados, extracción, clasificación y otros componentes de procesamiento documental.
Consultar fuente - Google Cloud — Crear y gestionar procesadores de Document AI.
Referencia oficial de las distintas categorías de procesadores disponibles, incluida digitalización, clasificación y extracción personalizada.
Consultar fuente - Microsoft Learn — Azure AI Document Intelligence.
Documentación oficial sobre OCR, análisis de estructura, tablas, pares clave-valor y modelos preconstruidos y personalizados para procesamiento documental.
Consultar fuente - AWS — Amazon Textract: best practices.
Guía oficial sobre calidad del documento de entrada y uso de puntuaciones de confianza según la sensibilidad del caso de uso.
Consultar fuente - AWS — Amazon Textract: análisis de documentos.
Documentación oficial sobre detección de texto y análisis estructural de formularios, tablas y otros elementos documentales.
Consultar fuente - Agencia Española de Protección de Datos — Calidad, exactitud y minimización en tratamientos con IA.
Nota publicada el 21 de julio de 2026 sobre la aplicación de los principios de exactitud y minimización del RGPD en tratamientos de datos personales que incorporan sistemas de IA.
Consultar fuente
Las capacidades, versiones, regiones, límites y modelos disponibles en servicios de procesamiento documental cambian con el tiempo. Antes de diseñar una implantación debe comprobarse la documentación vigente de cada proveedor.
