
CRM · ERP · INTEGRACIÓN · GOBIERNO DEL DATO
Integrar CRM y ERP: qué datos sincronizar, quién manda y cómo evitar duplicados
Conectar un CRM con un ERP no resuelve por sí solo el problema del dato. Antes hay que decidir dónde nace cada información, qué sistema la gobierna, quién puede modificarla, cuándo debe cruzar y qué ocurre si ambos sistemas dejan de coincidir.
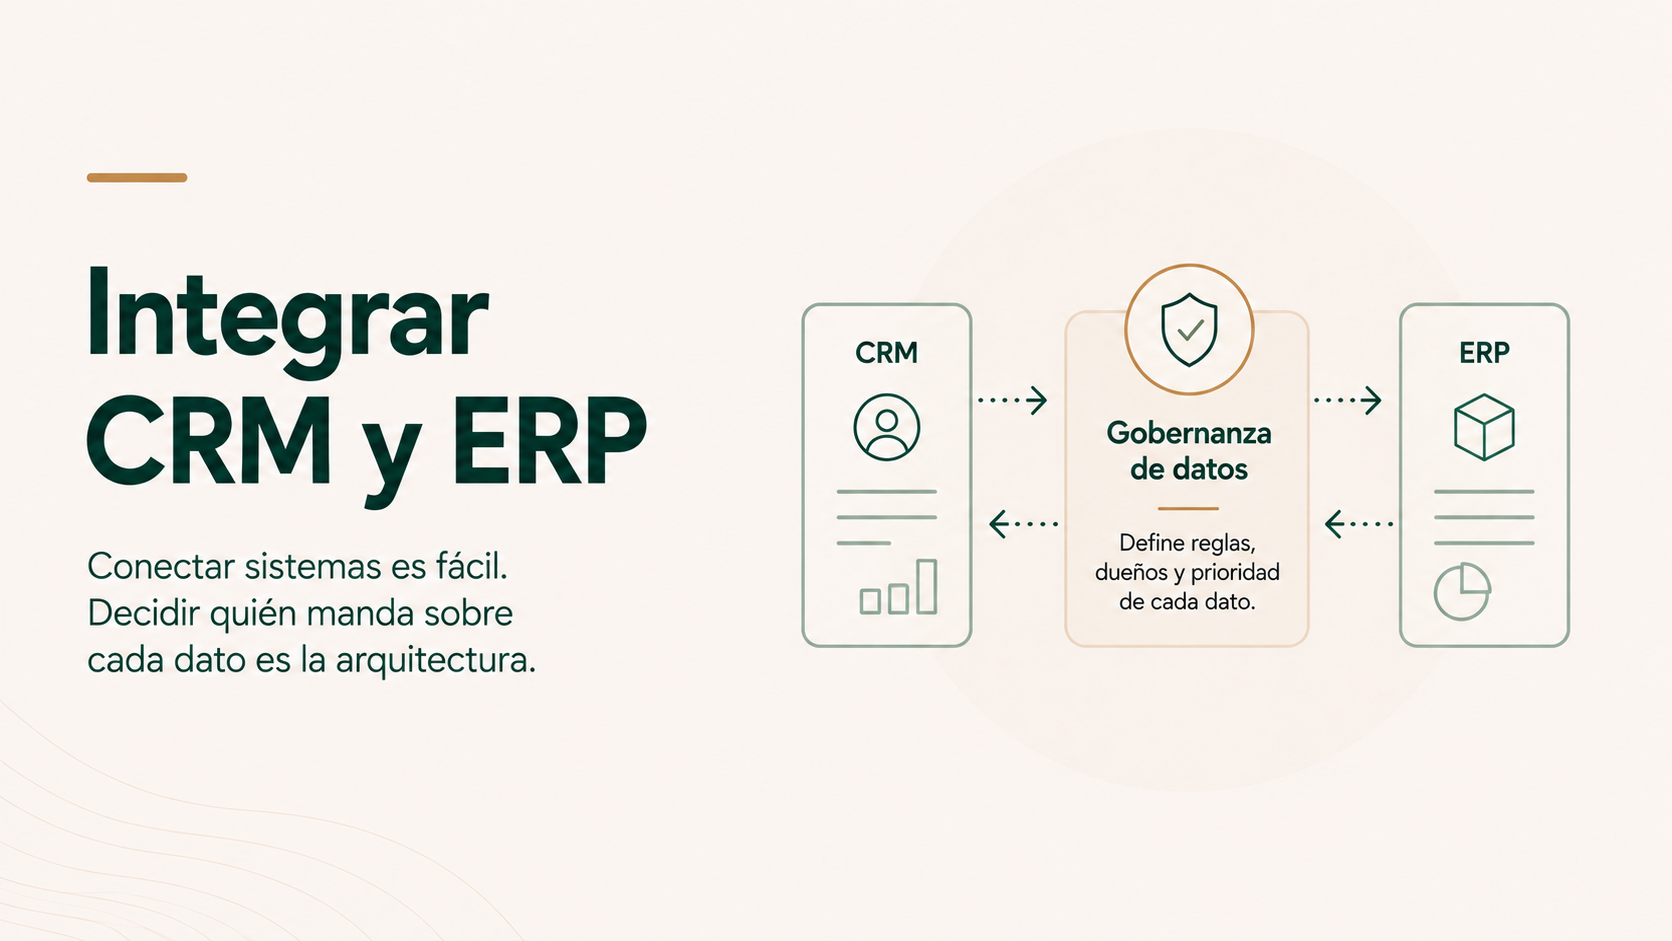
Antes de sincronizar un dato, decide quién tiene derecho a cambiarlo.
Integrar CRM y ERP no consiste en hacer que ambos tengan los mismos datos. Consiste en decidir qué dato pertenece operativamente a cada sistema, quién puede modificarlo, cuándo debe cruzar y qué hacer cuando no coincide.
Un diseño fiable necesita, entre otras cosas, autoridad clara sobre cada dato, identificadores estables, operaciones idempotentes, reglas de conflicto, reintentos seguros y comprobaciones periódicas de coherencia.
La integración correcta no replica todo. Sincroniza lo necesario y conserva una autoridad clara para cada decisión de negocio.
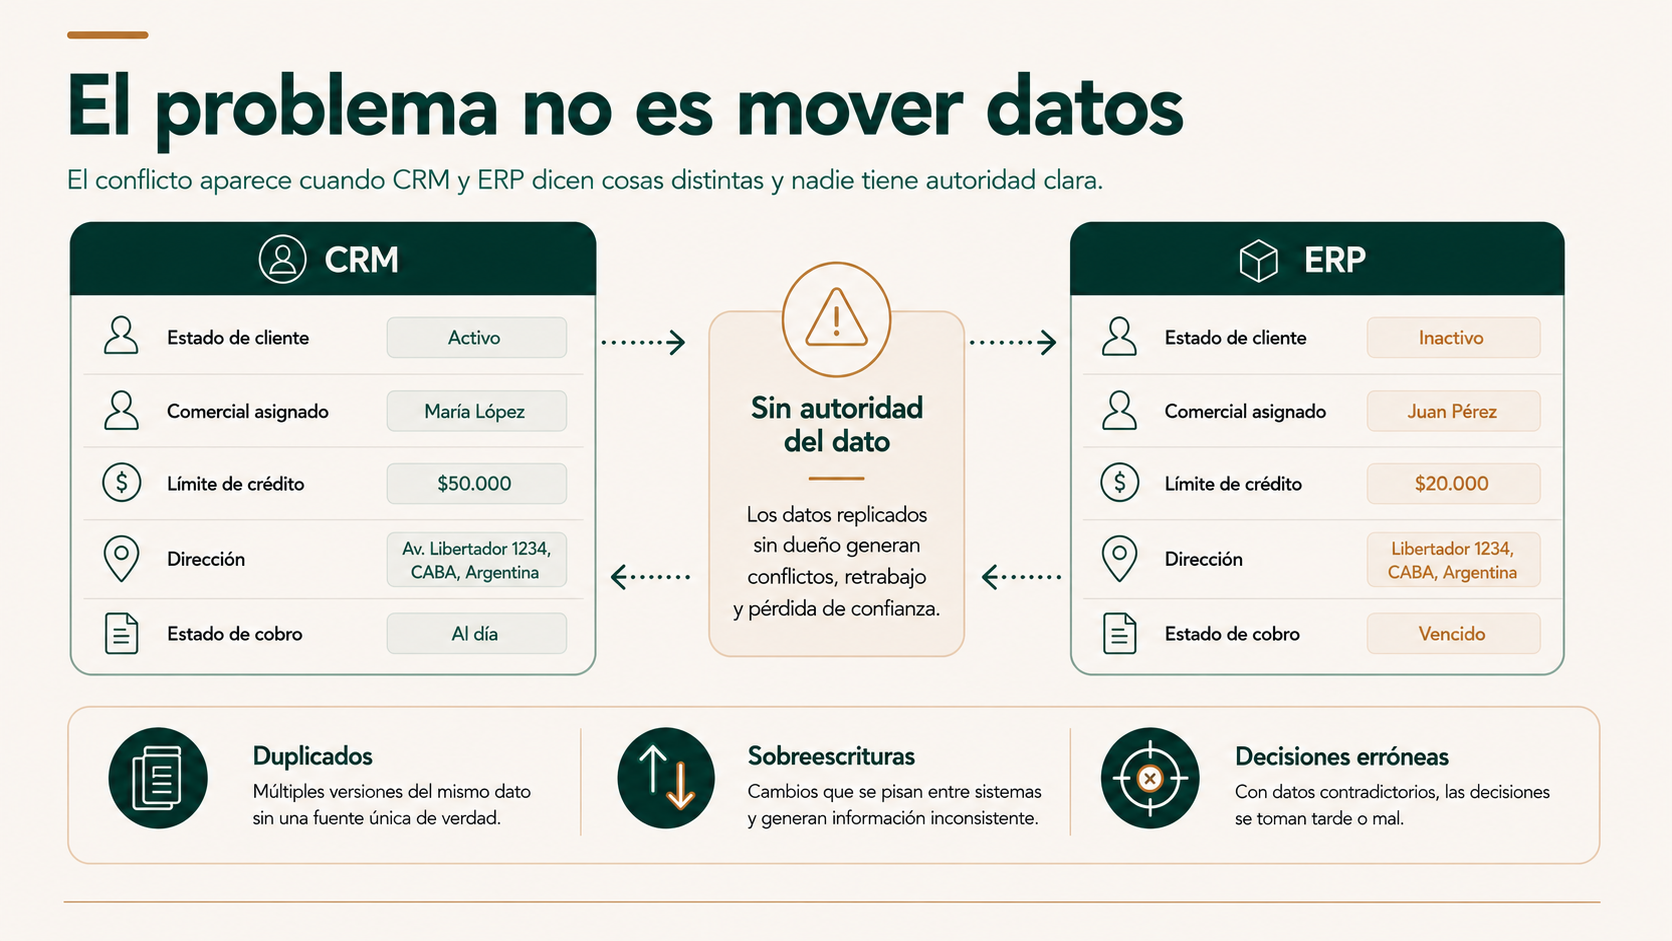
Ventas corrige el cliente en el CRM. Administración lo corrige en el ERP. Una hora después, los dos vuelven a estar mal.
Es una escena bastante más útil para entender una integración que empezar hablando de APIs.
El comercial cambia la razón social en el CRM. El ERP conserva un nombre diferente porque facturación utiliza el dato fiscal. La integración detecta la modificación del CRM y actualiza el ERP. Después otro proceso detecta que el ERP ha cambiado y devuelve el dato al CRM.
Los sistemas están perfectamente conectados. El problema es que nadie ha decidido qué significado tiene cada dato y quién puede modificarlo.
Una integración CRM–ERP puede mover contactos, empresas, oportunidades, presupuestos, pedidos, productos, facturas o estados de cobro. Pero mover información no es lo mismo que gobernarla.
Antes de diseñar conectores conviene resolver tres preguntas:
- Qué necesita saber cada sistema para cumplir su función.
- Qué sistema tiene autoridad sobre cada dato o estado.
- Qué debe ocurrir cuando el intercambio falla, se repite o produce un conflicto.
La decisión sobre si conviene integrar, configurar o automatizar alrededor del stack pertenece a otro problema y la desarrollamos en SaaS, integración o automatización a medida. Aquí partimos de que CRM y ERP deben colaborar y nos centramos en cómo evitar que esa colaboración degrade el dato.
Mapa de autoridad del dato: qué significa y para qué sirve
En Yarvia llamamos mapa de autoridad del dato a un recurso de diseño para decidir cómo se reparte la responsabilidad de la información entre sistemas. No es un estándar formal del sector.
El mapa toma cada entidad o campo relevante y responde, como mínimo, a estas preguntas:
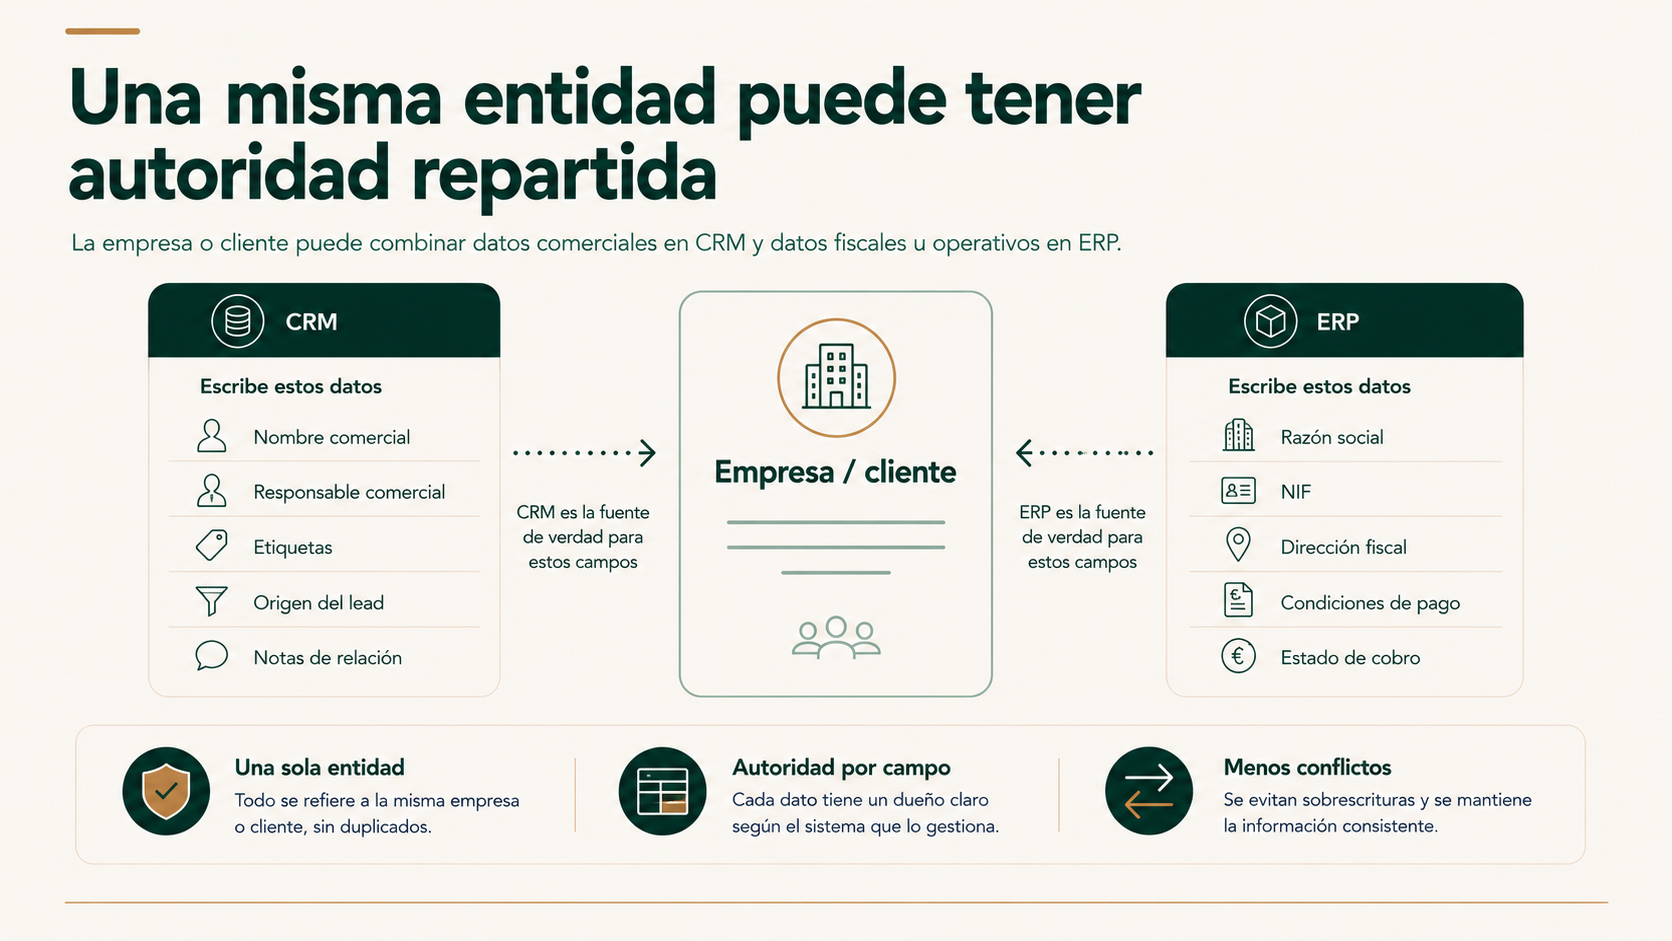
Una de las consecuencias del mapa es desmontar una idea demasiado simple: “el CRM manda sobre clientes y el ERP manda sobre facturas”.
Puede ocurrir, pero no tiene por qué ser así. Dentro de una misma empresa, el CRM puede gobernar el propietario comercial, el segmento y determinadas preferencias de contacto, mientras el ERP gobierna razón social fiscal, condiciones de pago o información necesaria para facturación.
La autoridad puede definirse por entidad, campo o estado del ciclo de vida.
El sistema que muestra un dato no tiene por qué ser el sistema autorizado para modificarlo.
Sistema de referencia, autoridad de escritura y copia operativa: tres conceptos diferentes
Conviene separarlos porque muchas integraciones los mezclan.
Sistema de referencia
Es el sistema cuya versión se considera la referencia operativa para un dato o estado concreto. También se utiliza la expresión system of record, pero no significa necesariamente que toda la entidad “pertenezca” a una sola aplicación.
Autoridad de escritura
Define quién puede cambiar el dato. Un sistema puede mostrar una copia de un campo sin estar autorizado a editarlo o devolver cambios sobre él.
Copia operativa
Es una réplica que otro sistema necesita para trabajar. Puede ser útil para mostrar contexto, filtrar, calcular o iniciar procesos aunque la fuente que gobierna el dato esté en otro lugar.
Ejemplo: el ERP puede ser la referencia del estado de cobro. El CRM necesita una copia para que ventas sepa si un cliente tiene facturas vencidas, pero el comercial no debería marcar desde el CRM una factura como pagada si ese hecho se registra contablemente en el ERP.
El CRM ve el dato. Puede utilizarlo. Incluso puede disparar una tarea comercial. Pero la autoridad para declarar el pago permanece en el ERP.
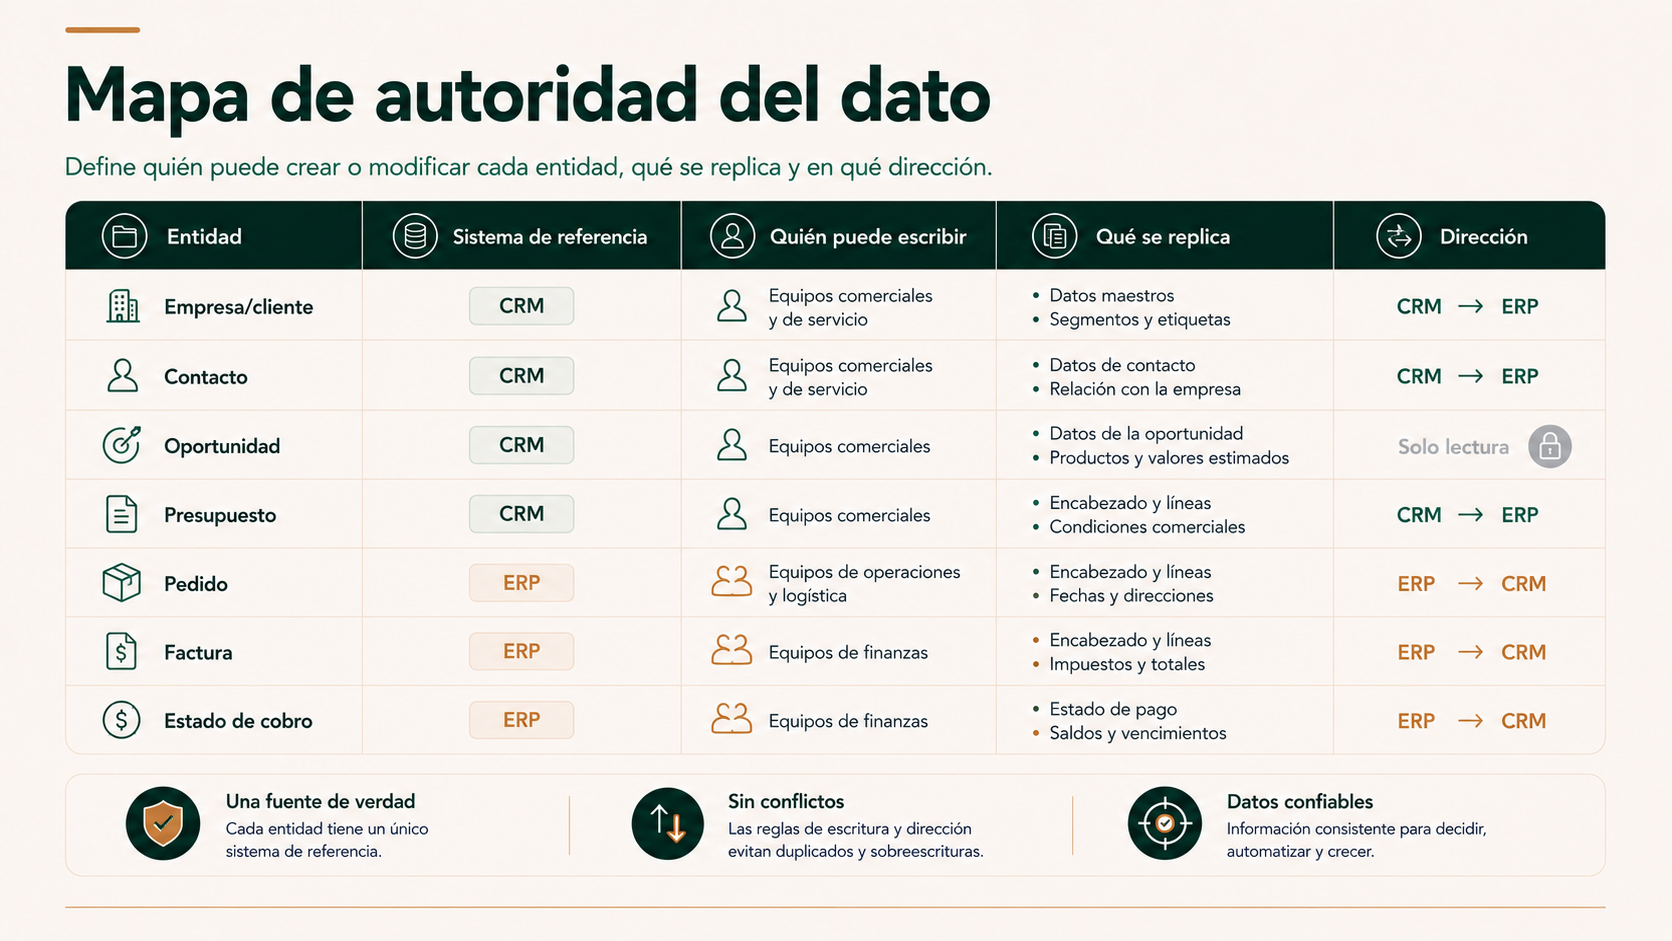
Matriz CRM–ERP: decidir entidad por entidad en lugar de sincronizar “clientes” en bloque
La siguiente tabla es un ejemplo de análisis, no una configuración universal. Una empresa puede tomar decisiones diferentes según su proceso, CRM, ERP, obligaciones y responsabilidades internas.
| Entidad / dato | Origen habitual posible | Referencia posible | Dirección | Momento útil | Riesgo a controlar |
|---|---|---|---|---|---|
| Empresa / lead | CRM | CRM antes de relación transaccional | CRM → ERP cuando proceda | Al cumplir condición de alta | Crear en ERP contactos que nunca serán clientes. |
| Contacto | CRM | CRM para relación comercial | Selectiva | Cuando sea necesario para pedido/facturación | Copiar personas innecesarias o perder relaciones. |
| Oportunidad | CRM | CRM | No siempre necesita llegar al ERP | Al convertirse en presupuesto/pedido si aplica | Replicar pipeline comercial sin utilidad operativa. |
| Presupuesto | CRM o ERP | Depende de quién calcula y aprueba | Según proceso | Creación / aceptación | Dos versiones comerciales del mismo presupuesto. |
| Pedido | ERP o CRM según proceso | Sistema que gobierna ejecución | Principalmente hacia el otro como estado/contexto | Pedido confirmado | Duplicar pedidos por reintentos. |
| Producto / tarifa | ERP con frecuencia | ERP si gobierna catálogo y precios | ERP → CRM | Cambio relevante o sincronización programada | Vender con información obsoleta. |
| Factura | ERP | ERP | ERP → CRM como resumen | Factura emitida | Crear copias que parezcan documentos contables oficiales. |
| Estado de cobro | ERP | ERP | ERP → CRM | Pago registrado / vencimiento | Permitir cambios desde CRM sin fundamento contable. |
El valor de la matriz no está en copiar estas decisiones, sino en obligar a discutirlas antes de implementar.
Una integración que replica todas las columnas de una tabla a otra puede parecer completa y, sin embargo, introducir más riesgo que una sincronización de diez campos bien gobernados.
¿Cuándo debe crearse un cliente del CRM en el ERP?
No existe una respuesta universal.
Crear en ERP cada lead que entra en el CRM puede llenar el sistema transaccional de registros que nunca comprarán. Esperar demasiado puede obligar a administración a volver a introducir datos cuando llega el primer pedido. Si ese pedido de cliente llega por email, Excel o PDF, la integración debe resolver además cómo convertirlo en una operación válida del ERP.
El momento correcto depende de qué significa «cliente» en cada organización.
Posibles condiciones de alta pueden ser:
- Oportunidad ganada.
- Presupuesto aceptado.
- Primer pedido confirmado.
- Validación administrativa o fiscal completada.
- Necesidad efectiva de facturar.
También puede existir una fase intermedia: crear un registro mínimo en ERP para reservar un identificador y completar después los campos necesarios.
La regla debe responder al proceso real. La integración no debería decidir por accidente cuándo una oportunidad comercial se convierte en una entidad transaccional.
Identificador externo y upsert: cómo reconocer al mismo registro en dos sistemas
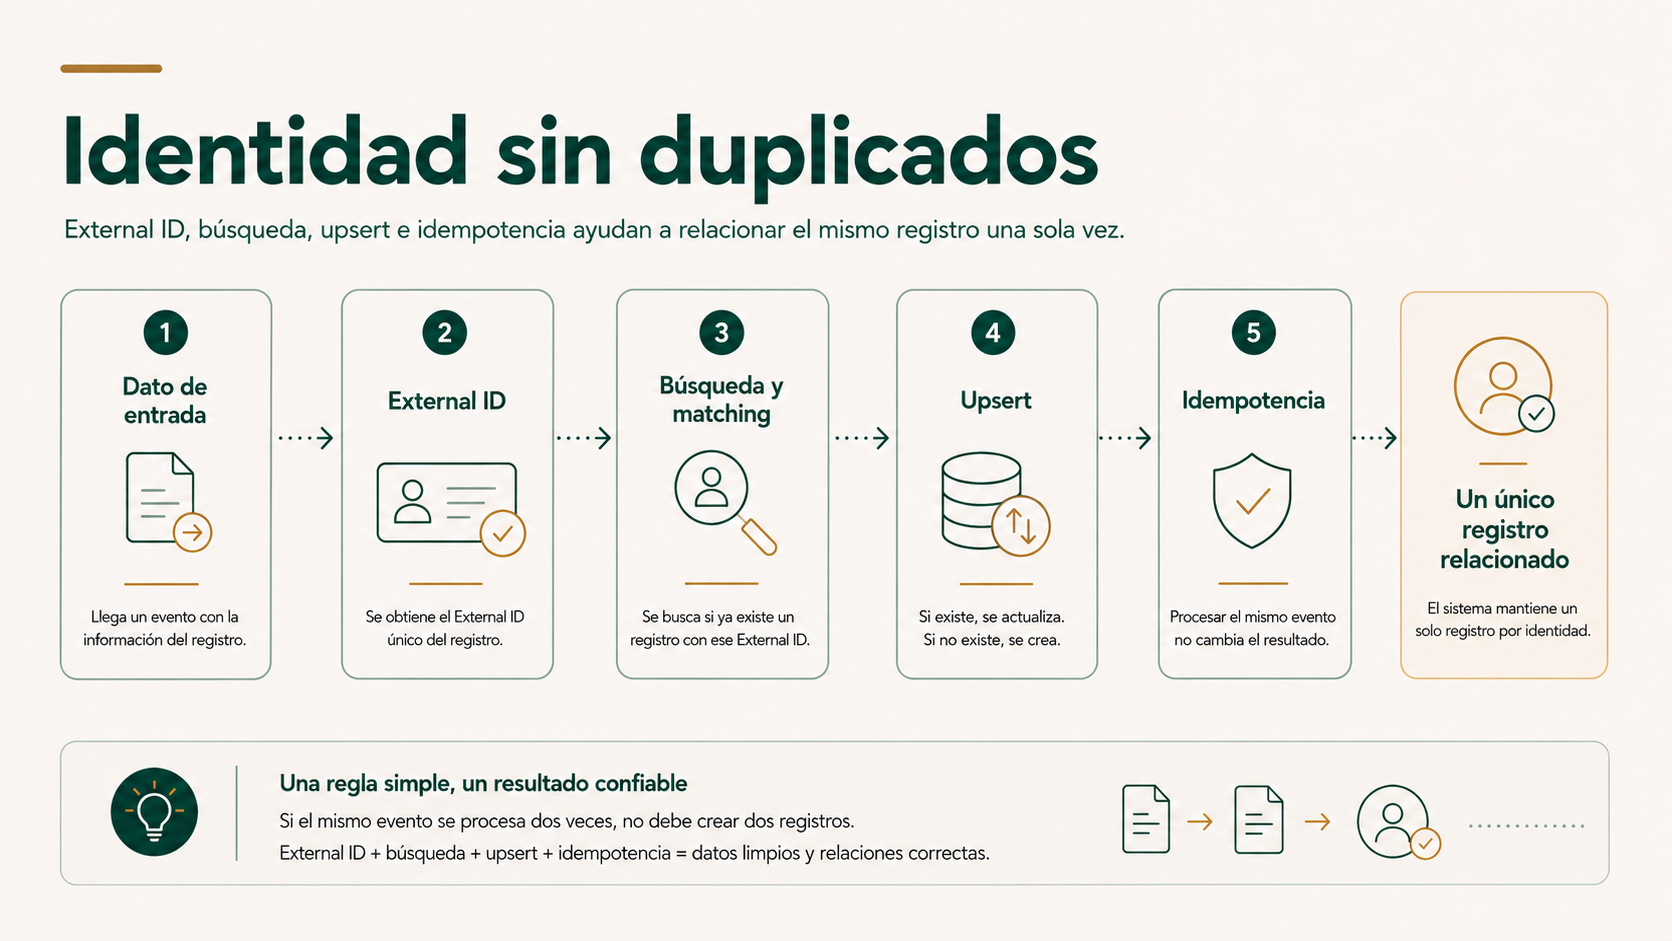
Para evitar duplicados, primero necesitamos resolver una pregunta básica: ¿cómo sabe el ERP que “Cliente 4837” del CRM es exactamente el registro que ya existe en su base de datos?
Antes de identificar, normalizar y validar el esquema
Dos sistemas pueden representar el mismo concepto de maneras incompatibles. El CRM puede admitir una dirección extensa en texto libre, mientras el ERP separa calle, número, código postal y país. Un campo puede aceptar 255 caracteres en origen y 50 en destino. Un estado puede ser texto libre en un sistema y una lista cerrada de valores en el otro.
Por eso conviene incluir una capa de normalización y validación de esquema antes de escribir. “Esquema” significa aquí la estructura que espera el sistema: tipos de dato, campos obligatorios, longitudes, formatos, valores permitidos y relaciones.
Esta capa puede convertir fechas a un formato común, normalizar identificadores fiscales, mapear códigos de país, traducir estados entre catálogos y detectar valores que no caben o no cumplen las restricciones del destino.
Truncar automáticamente un valor para que “quepa” puede ser peligroso. Si una dirección, razón social o referencia se corta sin criterio, la llamada técnica puede terminar correctamente y el dato quedar degradado. Ante una incompatibilidad relevante, es preferible transformar con una regla explícita o abrir una excepción.
Identificador externo
Un identificador externo es una referencia estable que permite relacionar un registro de un sistema con su equivalente en otro.
Por ejemplo, el ERP puede guardar en el cliente un campo `crm_contact_id` con el identificador original del CRM. O el CRM puede conservar el `erp_partner_id` devuelto cuando se crea el registro.
En otras plataformas se utilizan claves alternativas: combinaciones o campos únicos que permiten localizar un registro sin conocer su identificador interno nativo. Microsoft Dataverse documenta precisamente las alternate keys como mecanismo para referenciar filas usando identificadores de sistemas externos.
El NIF puede ayudar a encontrar coincidencias, pero no siempre es una clave técnica suficiente: puede faltar, cambiar de formato, compartirse en estructuras concretas o no existir en determinados tipos de contacto. El email tampoco debería asumirse como identificador universal de una empresa.
Upsert: actualizar si existe, crear si no existe
Upsert combina dos operaciones: update —actualizar— e insert —crear—.
En lugar de programar «busca; si existe actualiza; si no existe crea», una API que soporta upsert puede recibir una clave estable y decidir la operación adecuada.
Llega el cliente CRM-4837.
El ERP busca la clave externa CRM-4837.
Si existe: actualiza únicamente los campos autorizados.
Si no existe: crea el registro y conserva la relación.
Microsoft Dataverse documenta upsert precisamente para escenarios de integración donde el sistema externo puede no conocer la clave primaria de Dataverse. Salesforce también utiliza este patrón como una forma habitual de comprobar un identificador único antes de insertar.
Upsert reduce una parte del problema de duplicados, pero no decide si dos registros representan a la misma entidad.
Si llegan “ACME SL” y “Acme Sociedad Limitada” con identificadores externos diferentes, ambos pueden crearse correctamente mediante upsert. La operación técnica ha funcionado; el problema de identidad sigue sin resolver.
Por eso un buen diseño separa matching de identidad —decidir si hablamos de la misma entidad— de la operación técnica de crear o actualizar.
Idempotencia: si el mismo evento se procesa dos veces, no debe crear dos pedidos
Idempotencia es una propiedad de diseño que permite repetir una operación sin producir efectos adicionales no deseados.
En términos sencillos: si el mismo evento llega dos veces, la segunda ejecución no debería duplicar el resultado.
Esto importa porque los sistemas distribuidos reintentan. Un timeout no significa necesariamente que la operación haya fallado. Puede ocurrir que el ERP haya creado el pedido pero la integración no haya recibido la respuesta.
Si el middleware interpreta «no recibí respuesta» como «no se creó» y vuelve a llamar a `crear pedido`, podemos terminar con dos pedidos válidos.
Salesforce insiste en el diseño idempotente para evitar que invocaciones repetidas creen registros o procesen transacciones dos veces.
Regla práctica: un reintento seguro necesita una forma de reconocer que está intentando completar la misma operación, no una operación nueva.
Eso puede resolverse mediante identificadores únicos de evento, claves idempotentes, identificadores externos, comprobaciones previas o endpoints diseñados para upsert, según las capacidades de cada plataforma.
La entrada sobre pedidos, albaranes y facturas hacia ERP desarrolla este problema dentro de un flujo documental industrial. Aquí lo tratamos como requisito general de integración.
Sincronización selectiva: no todo tiene que viajar en ambos sentidos
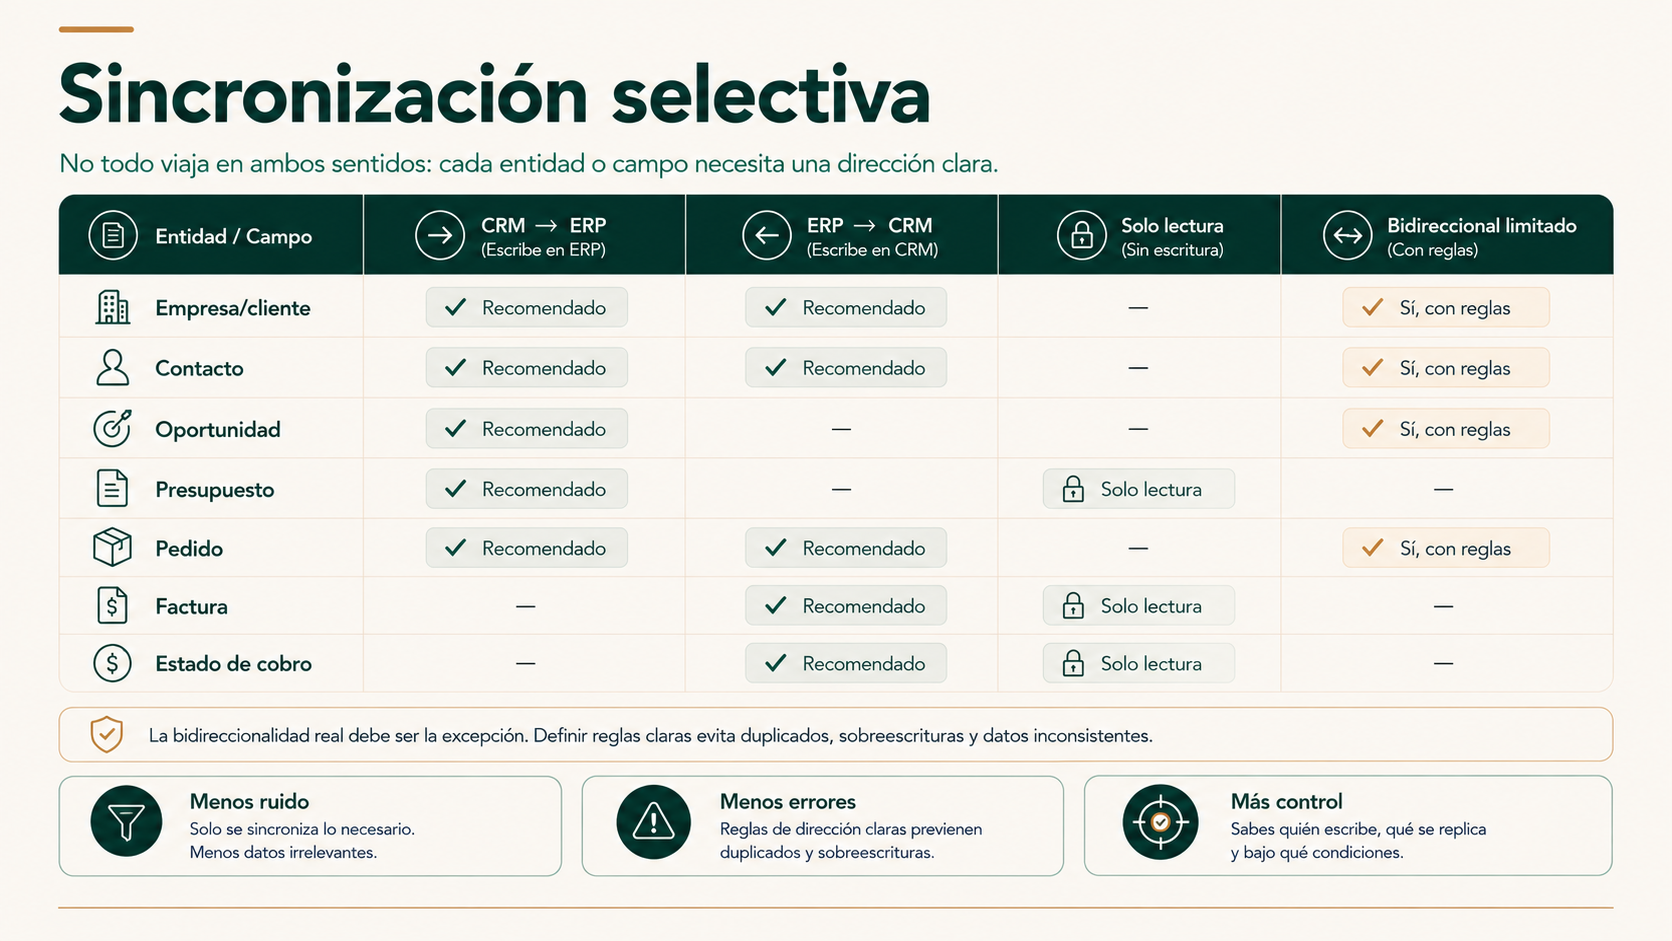
La sincronización bidireccional completa suele sonar atractiva: cualquier cambio en CRM llega a ERP y cualquier cambio en ERP vuelve al CRM.
Pero cuanto más simétrica es la escritura, más importante se vuelve resolver conflictos.
En muchos escenarios es más robusta una sincronización selectiva:
- Empresas comerciales: CRM → ERP cuando se activa una condición de alta.
- Catálogo y precios aprobados: ERP → CRM.
- Oportunidades: permanecen en CRM.
- Pedidos confirmados: ERP → CRM como estado y referencia.
- Estado de factura y cobro: ERP → CRM.
- Datos de contacto comercial: CRM gobierna determinados campos.
- Datos fiscales: ERP gobierna los campos relevantes para facturación.
El CRM puede mostrar muchos de estos datos como copias operativas y, al mismo tiempo, bloquear su edición local.
Bidireccional no significa maduro. Unidireccional no significa limitado. La dirección correcta depende de quién tiene autoridad para producir el dato.
Sincronizar por eventos de negocio, no por cualquier cambio técnico
No todos los cambios de un registro justifican activar un proceso completo.
Cambiar una nota interna o corregir una tilde puede no tener ninguna relevancia para el ERP. En cambio, pedido confirmado, factura emitida o pago registrado sí representan transiciones de negocio que otros sistemas pueden necesitar conocer.
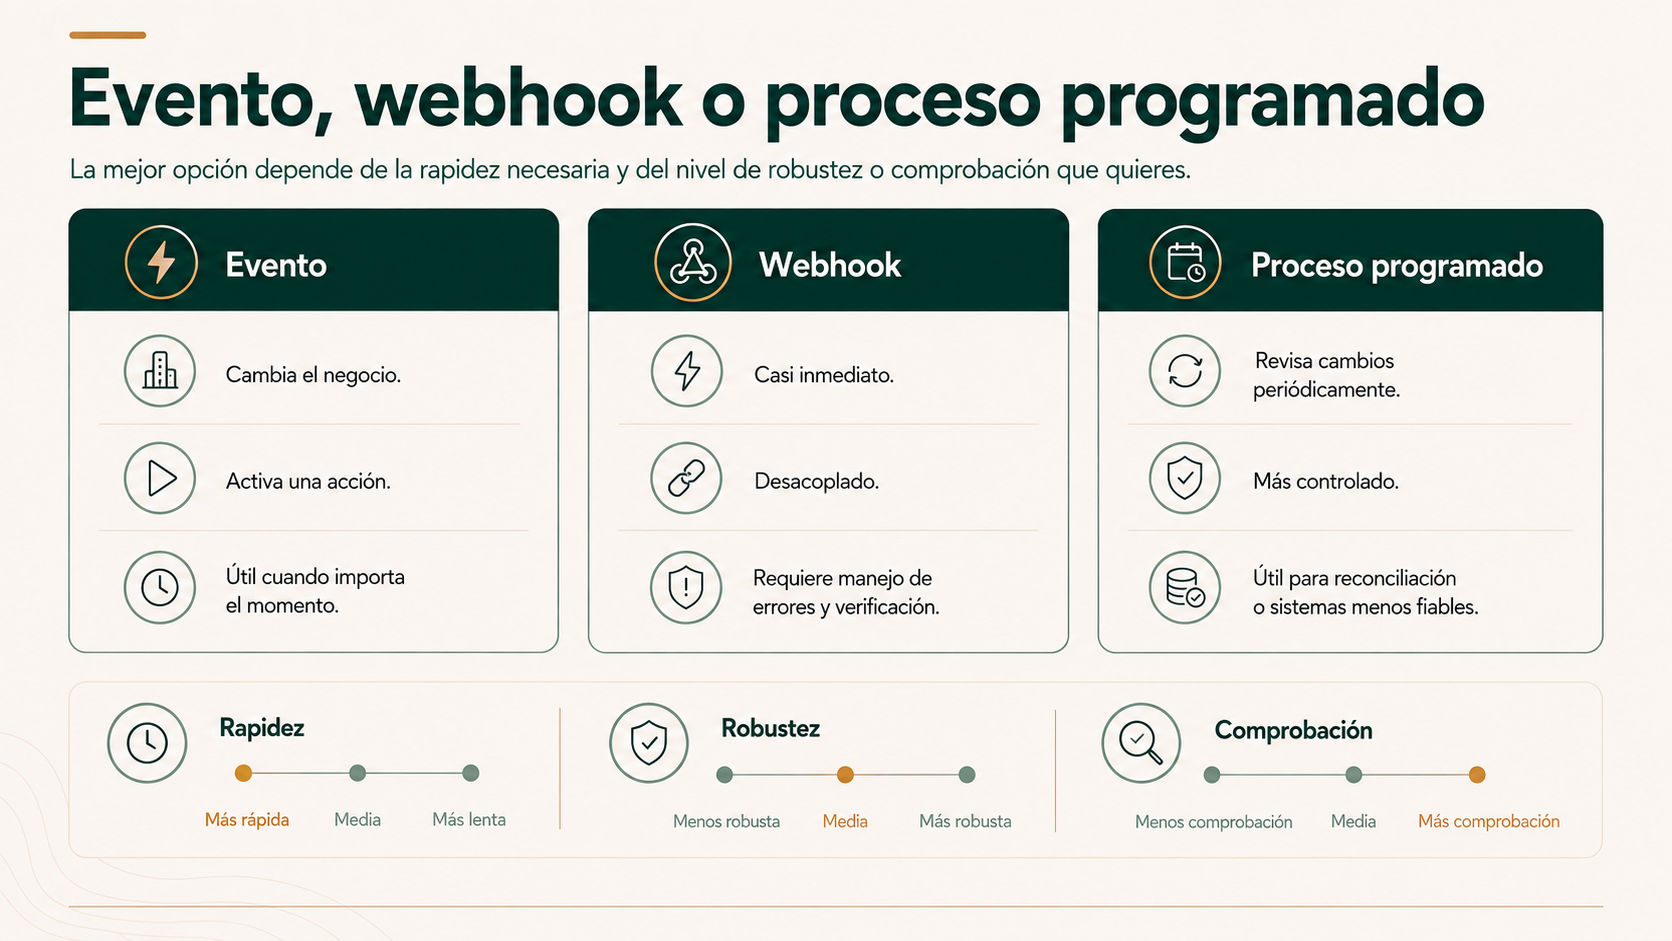
Webhook
Un webhook es un aviso que una aplicación envía a otra cuando ocurre un evento. Evita tener que preguntar continuamente si algo ha cambiado.
Evento
Un evento representa que algo relevante ha ocurrido: se creó una empresa, cambió un estado, se confirmó un pedido o se registró un pago. Un webhook es una posible forma de transportar ese aviso.
Sincronización programada
Un proceso consulta y actualiza datos cada cierto intervalo. Puede ser más que suficiente para catálogos, reporting o información que no necesita viajar inmediatamente.
Seguimiento de cambios
Algunas plataformas permiten pedir únicamente los registros que han cambiado desde la última sincronización. Microsoft Dataverse dispone de change tracking precisamente para detectar cambios de forma eficiente.
No existe un SLA universal. Tiempo real solo aporta valor cuando el proceso necesita realmente una respuesta inmediata.
Una factura emitida puede necesitar reflejarse rápidamente en CRM. Una descripción de producto quizá pueda actualizarse cada noche. Un catálogo de miles de referencias puede resultar más estable mediante lotes o seguimiento incremental que mediante cientos de operaciones individuales.
Errores, reintentos y resultado incierto: el caso que una demo casi nunca enseña
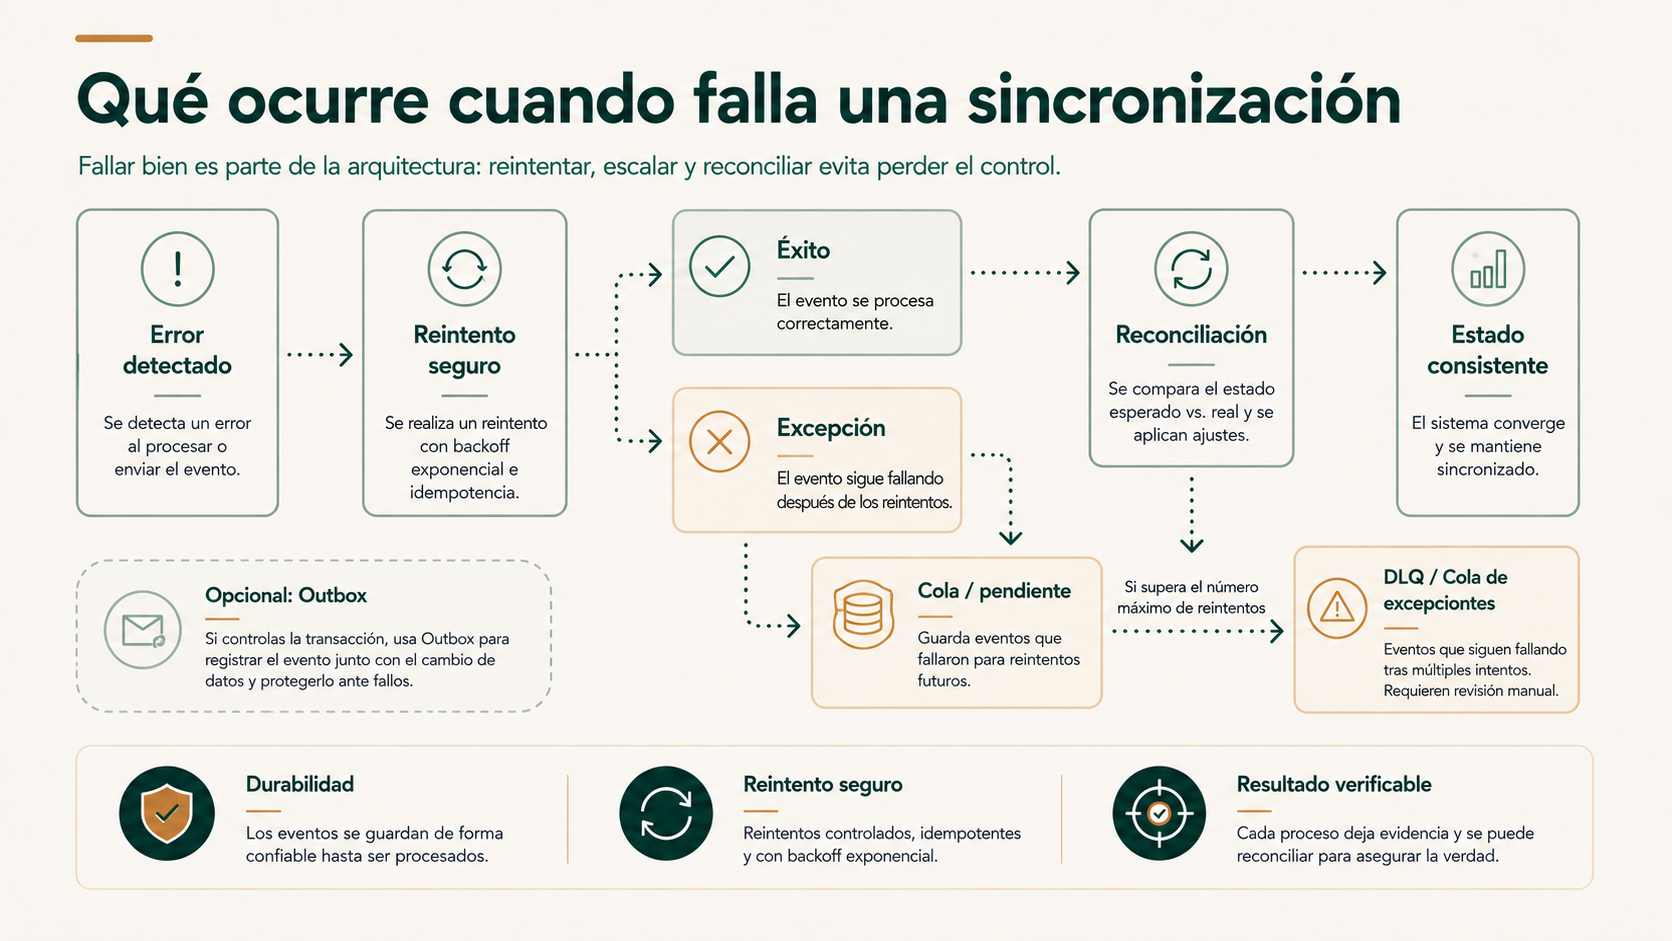
Una integración de producción no puede limitarse a «si hay error, vuelve a intentar». La guía sobre monitorización de automatizaciones en producción desarrolla cómo detectar, clasificar, recuperar y reconciliar este tipo de fallos más allá de una integración concreta.
Hay varios estados diferentes:
Error confirmado
El destino responde que la operación no se ejecutó. Puede corregirse la causa y reintentarse.
Éxito confirmado
El destino devuelve una respuesta que permite registrar que la operación terminó.
Resultado incierto
La conexión se corta o expira el tiempo de espera y no sabemos si el destino llegó a aplicar el cambio.
El tercer caso es el peligroso.
Antes de repetir una creación conviene poder preguntar al destino si la operación existe o utilizar una clave idempotente que permita repetirla con seguridad.
También hay operaciones compuestas. Odoo 19 documenta que cada llamada a su API JSON-2 funciona en su propia transacción y advierte del riesgo de encadenar varias llamadas independientes en operaciones relacionadas. Recomienda agrupar las operaciones relacionadas en un único método cuando se necesita consistencia transaccional.
La enseñanza general no es «usar Odoo de una forma concreta». Es entender que varias llamadas consecutivas no equivalen automáticamente a una única transacción de negocio.
Colas persistentes: que un fallo no haga desaparecer el trabajo pendiente
Cuando la integración no puede procesar inmediatamente un evento, una cola de mensajes persistente permite conservarlo para procesarlo después en lugar de depender de la memoria de una ejecución concreta.
Este patrón resulta especialmente útil cuando el destino está temporalmente caído, existe limitación de capacidad o necesitamos desacoplar el ritmo al que un sistema produce cambios del ritmo al que el otro puede recibirlos.
Muchas arquitecturas trabajan con entrega al menos una vez —at-least-once delivery—: se prioriza no perder el mensaje, aunque eso signifique que pueda entregarse más de una vez. Por eso la idempotencia del consumidor sigue siendo necesaria.
DLQ: apartar lo que sigue fallando
Una Dead Letter Queue (DLQ), o cola de mensajes no procesados, recibe eventos que han fallado repetidamente o no pueden procesarse con las reglas actuales.
No es un cementerio que se pueda ignorar. Necesita monitorización, motivo de error, capacidad de corrección y un mecanismo controlado para reintentar o descartar el evento.
Su valor es evitar que un mensaje defectuoso bloquee o sature continuamente el camino normal mientras conserva evidencia para investigar qué ocurrió.
Transactional Outbox: guardar el cambio y el evento como una misma decisión
Existe además un patrón llamado Transactional Outbox o bandeja de salida transaccional. Se utiliza cuando una aplicación necesita guardar un cambio en su base de datos y, además, publicar un evento para otros sistemas.
El riesgo clásico es que el dato se guarde pero el evento no llegue a publicarse, o que se publique un evento de una operación que finalmente se revierte.
Con Outbox, el cambio de negocio y el evento pendiente se registran dentro de la misma transacción local. Un proceso separado publica después los eventos confirmados hacia la cola o bus de mensajes.
Matiz importante: Transactional Outbox no es una receta obligatoria para toda integración CRM–ERP. Tiene sentido cuando controlamos la aplicación o la capa que realiza la escritura y podemos participar en su transacción. En un SaaS externo dependemos de las garantías que ofrezcan su API, webhooks y mecanismos de eventos.
Last write wins, conflictos y bucles de sincronización
“Gana la última modificación” puede sobrescribir el dato correcto
Last write wins significa que, ante dos versiones, prevalece la última que se escribió.
Es fácil de implementar, pero puede ser una mala regla de negocio.
Supongamos que administración corrige en ERP la razón social fiscal a las 12:01. A las 12:03 llega una actualización del CRM basada en una copia antigua que conserva el nombre comercial. Si la única regla es «gana lo último», el sistema acaba de sustituir un dato correcto por uno antiguo.
La alternativa es utilizar autoridad: ese campo se modifica desde ERP y el CRM recibe una copia de solo lectura. Para otros campos, la dirección puede ser la contraria.
El bucle clásico
CRM cambia teléfono.
Integración actualiza ERP.
ERP emite evento “teléfono actualizado”.
Integración vuelve a escribir CRM.
CRM interpreta la escritura como nuevo cambio y vuelve a emitir.
Una arquitectura debe distinguir cambios originados por usuarios, procesos internos e integraciones, o utilizar versiones, marcas de origen, hashes, identificadores de evento o reglas equivalentes.
No hace falta sincronizar un valor si la copia de destino ya contiene exactamente la misma versión.
Fusiones, archivados y borrados también forman parte del ciclo de vida
Los duplicados no solo se crean. También se fusionan. Los contactos se archivan. Los clientes cambian de estado. Algunos registros se eliminan o restauran.
HubSpot, por ejemplo, documenta eventos de webhooks para cambios, asociaciones, fusiones, eliminaciones y restauraciones en objetos CRM. Eso ilustra un principio general: una integración debe decidir qué hace con el ciclo de vida completo, no solo con altas y actualizaciones.
Si dos empresas se fusionan en CRM, ¿debe fusionarse también el ERP? Puede que no. Tal vez existan implicaciones contables que exijan mantener ambas entidades y solo actualizar la relación comercial.
Reconciliación: comprobar periódicamente que CRM y ERP siguen siendo coherentes
En integración se utiliza el término reconciliación. Aquí es más claro hablar de comprobación periódica de coherencia.
Aunque una integración sea event-driven —orientada a eventos—, pueden perderse mensajes, fallar reintentos, cambiar permisos o aparecer modificaciones manuales fuera del circuito esperado.
Por eso conviene disponer de un proceso que compare periódicamente aquello que debería coincidir.
No significa comparar toda la base de datos campo a campo.
Puede comprobar:
- Registros con identificador CRM pero sin equivalente ERP.
- Pedidos cuyo estado no coincide con el sistema que los gobierna.
- Clientes duplicados potenciales.
- Facturas emitidas que no llegaron como contexto al CRM.
- Eventos fallidos todavía pendientes.
- Copias operativas demasiado antiguas.
- Registros modificados en un sistema que no tenía autoridad para ese campo.
La comprobación periódica actúa como una red de seguridad. No sustituye el diseño correcto de eventos, pero detecta desviaciones que el flujo normal no capturó.
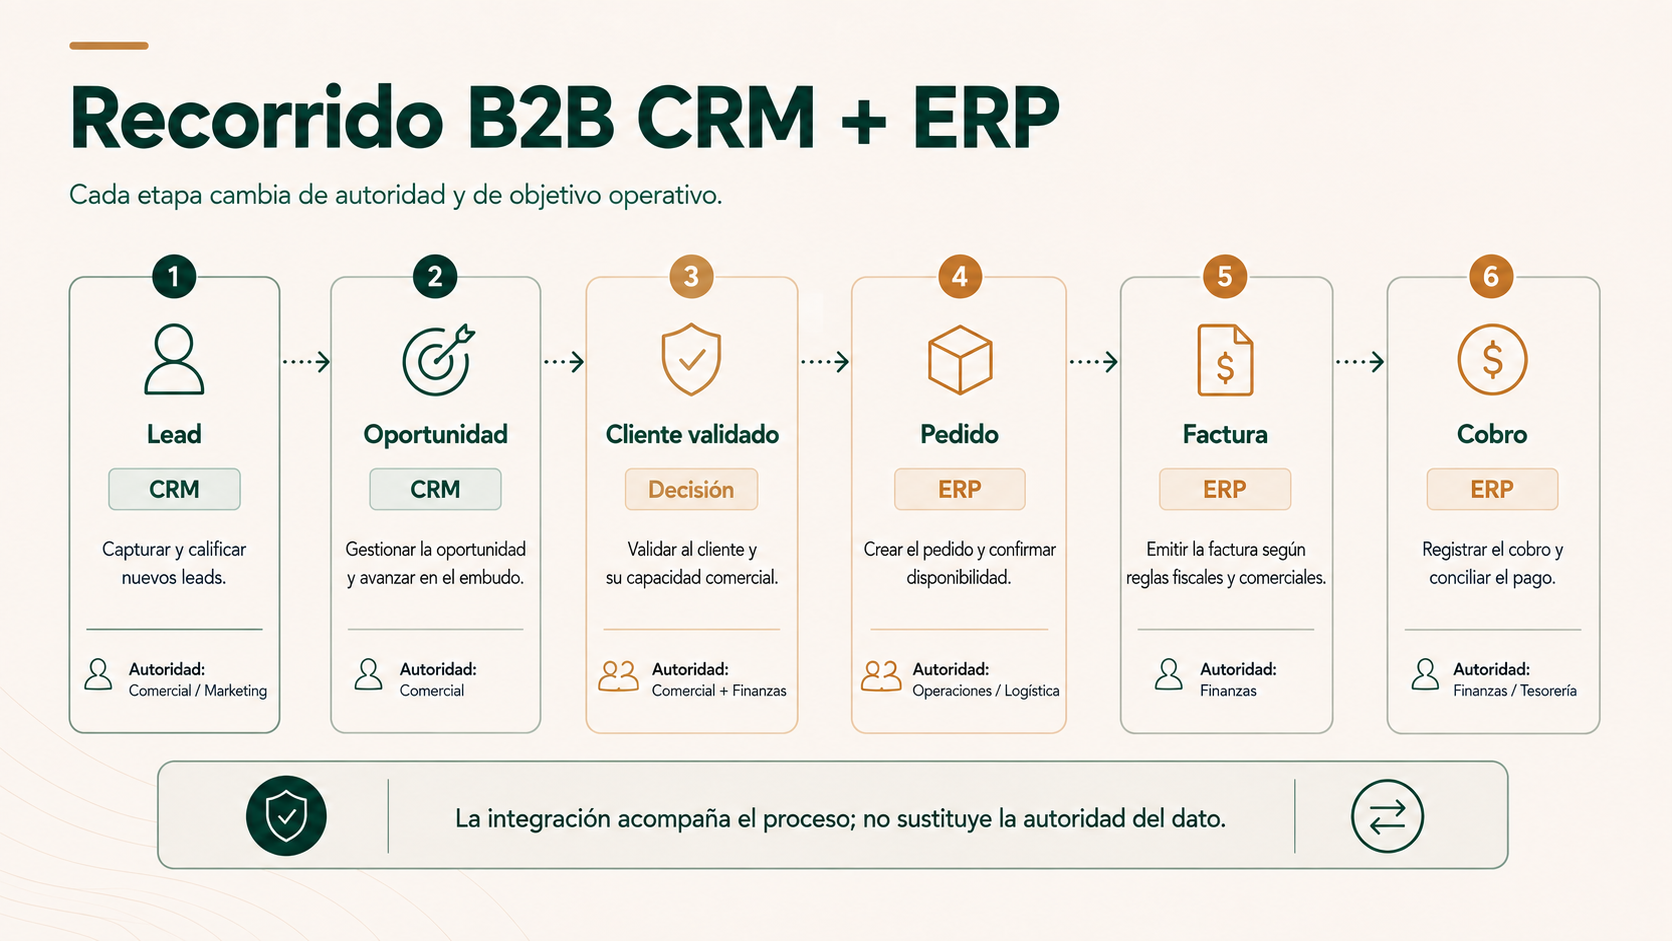
Ejemplo práctico: una empresa B2B con CRM comercial y ERP de gestión
Imaginemos una empresa ficticia de 35 empleados.
El equipo comercial trabaja en CRM. Administración y operaciones utilizan ERP para clientes transaccionales, catálogo, pedidos, facturación y cobros.
Un lead entra en CRM y permanece allí mientras se cualifica. Todavía no existe motivo para crear una ficha en ERP.
La oportunidad avanza y el cliente acepta un presupuesto. En ese momento el proceso administrativo valida los datos mínimos y se crea o actualiza el cliente en ERP utilizando un identificador externo estable.
El ERP devuelve su propio identificador. El CRM lo conserva para mantener la relación entre ambos registros.
El catálogo de productos y determinadas tarifas viajan del ERP al CRM porque operaciones gobierna esa información. El comercial puede consultar precio y disponibilidad relevantes, pero no altera el maestro desde CRM.
Cuando se confirma el pedido, el sistema utiliza un identificador de operación para que un timeout y posterior reintento no creen un segundo pedido.
El ERP gobierna la ejecución. El CRM recibe número de pedido, estado y fechas necesarias para que ventas tenga contexto.
Cuando se emite una factura, el CRM recibe una referencia y un resumen, no una segunda factura contable independiente.
Al registrarse el cobro en ERP, el estado viaja al CRM y puede activar una tarea comercial o desbloquear un proceso. El comercial ve «pagado», pero no puede convertir «pendiente» en «pagado» desde CRM.
Una noche falla un webhook. La factura se crea correctamente en ERP, pero la actualización no llega al CRM. La comprobación periódica de coherencia detecta al día siguiente una factura emitida sin copia operativa y repara la sincronización.
En otro momento, dos registros de empresa se fusionan en CRM. El proceso no fusiona automáticamente las entidades fiscales del ERP; abre una revisión porque la relación comercial y la entidad contable no tienen por qué ser equivalentes.
Lo importante del ejemplo no es el software concreto.
Es que cada paso tiene una autoridad, un identificador, una dirección, un evento y una respuesta prevista ante error o conflicto.
Trazabilidad de la integración y MDM: saber qué cambió y por qué
Cuando aparece una discrepancia, el equipo necesita poder reconstruir el recorrido del dato.
Un registro de auditoría o audit trail de integración debería permitir responder, con el nivel de detalle adecuado al riesgo, a preguntas como:
- Qué evento inició la operación.
- Qué identificador de correlación siguió la ejecución.
- Qué registro de origen y destino estaban implicados.
- Qué operación se intentó y con qué versión del dato.
- Cuándo se ejecutó, cuántos reintentos hubo y cuál fue el resultado.
- Qué regla, usuario o integración originó el cambio cuando sea relevante.
Un identificador de correlación es una referencia que acompaña a una operación a través de varios componentes. Permite relacionar un webhook, una transformación, una llamada al ERP, un reintento y una respuesta posterior como partes de la misma ejecución.
No siempre conviene guardar el payload completo —la carga de datos enviada por la API—. Puede contener información personal o sensible. Según el caso puede bastar con guardar identificadores, campos relevantes, hashes, metadatos y una representación minimizada que permita investigar sin duplicar innecesariamente la información.
Dónde encaja Master Data Management
Master Data Management (MDM), o gestión de datos maestros, es una disciplina más amplia para gobernar entidades críticas compartidas por distintos sistemas —por ejemplo clientes, proveedores o productos— y mantener definiciones, responsabilidades y calidad coherentes.
Una integración CRM–ERP no necesita necesariamente implantar una plataforma MDM. Pero el mapa de autoridad del dato aplica parte de esa lógica: identificar quién gobierna cada dato maestro, cómo se resuelven duplicados y qué reglas evitan que varias aplicaciones creen versiones incompatibles de la misma realidad.
Cuando el número de sistemas, países, unidades de negocio y catálogos crece mucho, el problema puede dejar de ser “una integración CRM–ERP” y convertirse en un problema formal de gobierno de datos maestros.
Sandbox y carga inicial: la primera sincronización no debería comportarse como un día normal
Hasta aquí hemos hablado sobre todo de cambios incrementales. Pero al conectar por primera vez dos sistemas aparece otro problema: la carga inicial, también llamada initial backfill.
Quizá el CRM tenga 80.000 empresas y el ERP 25.000 clientes históricos. Antes de activar la sincronización cotidiana hay que decidir cuáles representan la misma entidad, qué sistema conserva cada campo y qué registros no deben cruzar.
Cuando la plataforma lo permite, conviene ensayar primero en un sandbox o entorno de pruebas separado de producción. El objetivo no es únicamente comprobar que la API responde, sino probar con volúmenes y casos representativos qué ocurre con duplicados, campos incompatibles, reintentos y reglas de autoridad.
La carga inicial es un proyecto de migración, no un webhook gigantesco.
Debe tener alcance, reglas de matching, lotes, checkpoints, registro de errores, posibilidad de reanudar y una comprobación final de coherencia.
También hay que revisar las automatizaciones que rodean ambos sistemas. Según la plataforma y configuración, una importación o actualización masiva puede activar workflows, notificaciones, integraciones o eventos que estaban diseñados para cambios ordinarios.
Por eso puede ser necesario desactivar temporalmente determinadas automatizaciones, distinguir el tráfico de migración mediante una marca específica o impedir que los cambios del backfill regresen al sistema de origen y creen un bucle.
Una secuencia razonable puede ser: simulación sin escritura → lote pequeño controlado → revisión → ampliación progresiva → comprobación de coherencia → activación del flujo incremental.
No existe un tamaño universal de lote ni una estrategia única de corte. Depende del volumen, límites de API, capacidad de rollback y criticidad del proceso.
Seguridad y minimización: integrar no significa dar acceso total ni copiar todo
Cada integración abre una vía entre sistemas. Eso exige decidir qué credenciales utiliza, qué operaciones puede ejecutar y qué datos necesita realmente.
Una integración que solo consulta productos no necesita necesariamente permisos para modificar clientes. Un flujo que crea pedidos no tiene por qué poder borrar facturas.
El principio práctico es conceder el mínimo permiso suficiente para cada integración o componente y mantener trazabilidad sobre sus acciones.
La minimización afecta también al dato.
Si el CRM necesita saber que una factura está vencida, puede que no necesite replicar todas las líneas contables, adjuntos y metadatos del ERP. Si el ERP necesita una dirección fiscal, no implica que necesite todo el historial de interacción comercial del CRM.
Menos datos replicados significan también menos campos que gobernar, proteger, reconciliar y corregir.
Señales de una integración CRM–ERP que necesita revisión
- Los dos sistemas pueden editar los mismos campos sin reglas claras de precedencia.
- No existe un identificador estable que relacione registros entre plataformas.
- Se utiliza email, nombre o teléfono como clave universal sin analizar colisiones y cambios.
- Un timeout dispara automáticamente una nueva creación.
- Cualquier cambio técnico produce una sincronización completa.
- Se sincroniza en ambos sentidos “por si acaso”.
- Los usuarios corrigen continuamente en ambos sistemas porque no saben cuál manda.
- No existe cola visible de errores ni estado de reintentos.
- Un fallo puede permanecer semanas sin que exista una comprobación de coherencia.
- Las fusiones o borrados se propagan automáticamente sin analizar su significado en el otro sistema.
- La integración tiene permisos administrativos completos aunque solo use tres operaciones.
- Se replica información que ningún proceso del sistema receptor utiliza.
Una API disponible no convierte automáticamente una integración en sencilla. Los detalles de límites, autenticación, permisos, transacciones, eventos y modelos de datos terminan formando parte del mantenimiento.
Una integración fiable no consigue que dos sistemas sepan lo mismo
Consigue algo más útil: que cada sistema tenga los datos que necesita, que exista una autoridad clara para modificarlos y que los fallos no terminen convertidos en inconsistencias silenciosas.
El diseño empieza antes del conector.
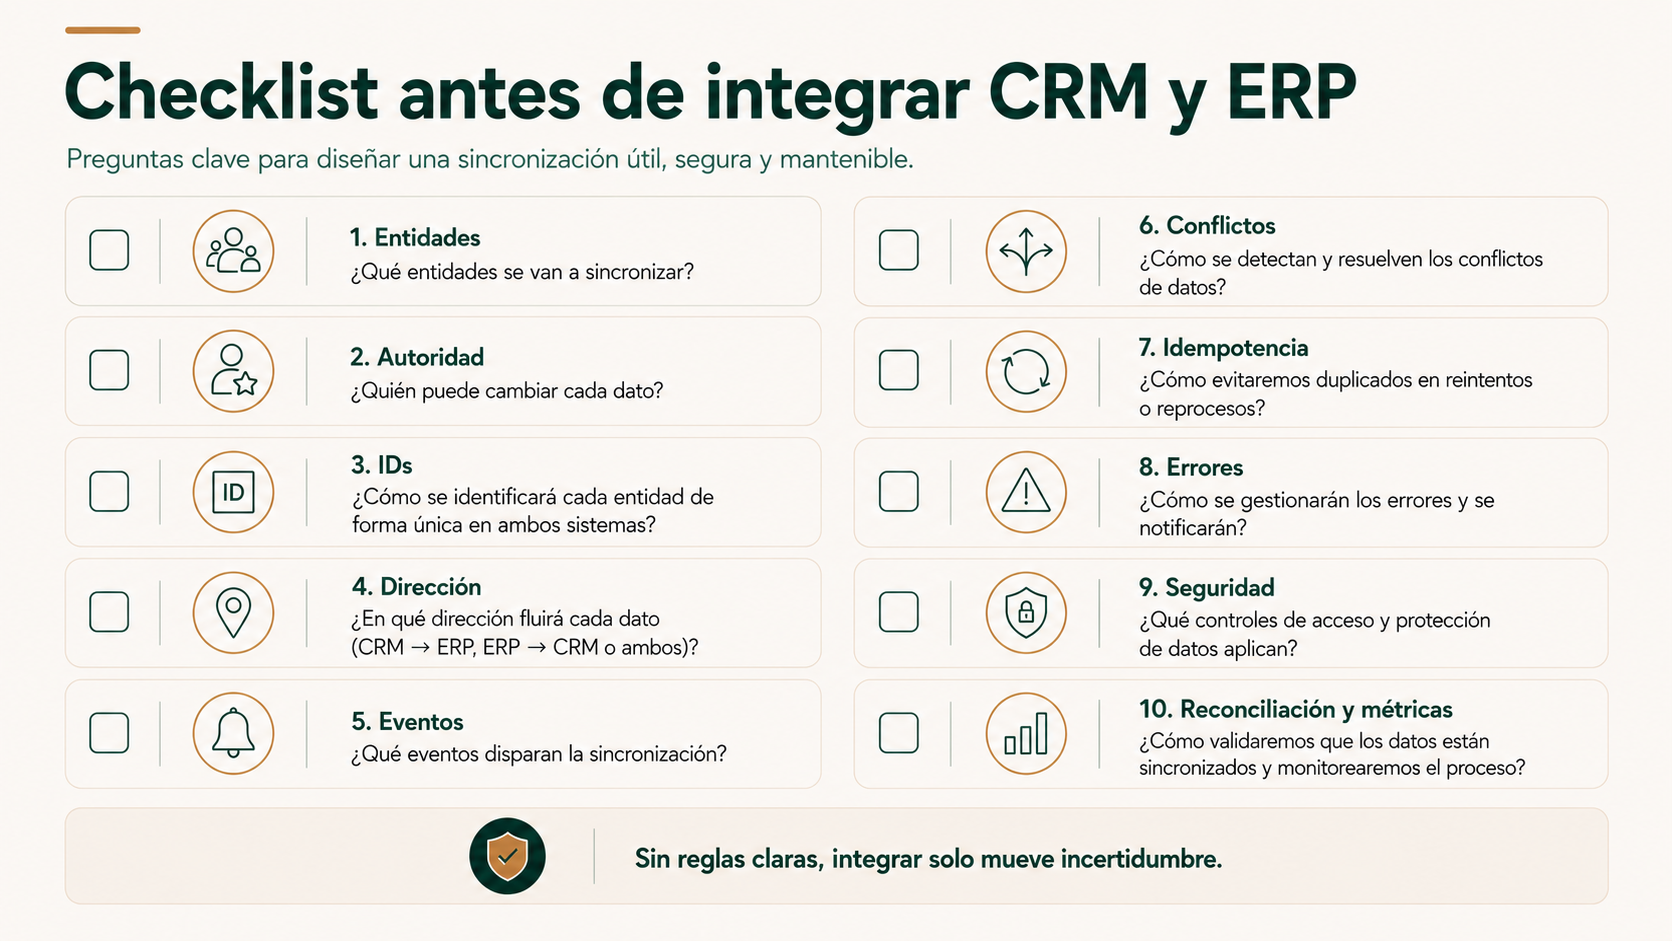
Qué entidad estamos moviendo. Qué significa. Dónde nace. Qué sistema la gobierna. Qué campos pueden cambiarse. Cómo identificamos al mismo registro. Qué evento dispara el intercambio. Qué ocurre si la operación se repite. Qué hacemos si no sabemos si terminó. Y cómo comprobamos después que la realidad sigue siendo coherente.
Cuando estas decisiones están definidas, API, webhook, middleware o plataforma de automatización se convierten en mecanismos de ejecución.
Cuando no lo están, la integración puede acelerar exactamente el problema que pretendíamos resolver.
Conectar sistemas es la parte visible. Decidir quién manda sobre cada dato es la arquitectura.
¿CRM y ERP duplican datos, estados o trabajo manual?
Podemos mapear entidades, autoridad, identificadores, eventos, errores y reglas de sincronización para diseñar una integración que mantenga el dato controlado sin obligarte a sustituir sistemas que ya cumplen bien su función.
Revisar la integración CRM–ERPFuentes
- Microsoft Learn — Data Synchronization (Microsoft Dataverse).
Documentación oficial sobre sincronización con sistemas externos, claves alternativas, upsert y seguimiento de cambios.
Consultar fuente - Microsoft Learn — Use Upsert to Create or Update a Record in Dataverse.
Referencia oficial sobre upsert y el uso habitual de claves alternativas para identificar registros en escenarios de integración.
Consultar fuente - Microsoft Learn — Use change tracking to synchronize data with external systems.
Referencia oficial sobre detección incremental de cambios desde la última sincronización.
Consultar fuente - Salesforce Architects — Integration Patterns.
Documentación oficial sobre patrones de integración, recuperación ante errores, reintentos, diseño idempotente, duplicados y upsert.
Consultar fuente - HubSpot Developers — CRM APIs y webhooks.
Documentación oficial sobre identificación de objetos, operaciones de actualización/creación y eventos de ciclo de vida en objetos CRM.
Consultar fuente - Odoo 19 — External JSON-2 API.
Documentación oficial sobre API externa, permisos y comportamiento transaccional de las llamadas JSON-2.
Consultar fuente - AWS Prescriptive Guidance — Transactional Outbox pattern.
Referencia oficial sobre el problema de doble escritura, persistencia del evento junto al cambio de negocio y necesidad de consumidores idempotentes cuando puede existir entrega repetida.
Consultar fuente - AWS Prescriptive Guidance — Amazon SQS / Dead-letter queues.
Referencia oficial sobre colas persistentes y uso de DLQ para aislar mensajes que no pueden procesarse correctamente tras reintentos.
Consultar fuente - Microsoft Azure Well-Architected Framework — Monitoring.
Referencia oficial sobre correlación y trazabilidad distribuida mediante identificadores propagados entre servicios, colas y dependencias.
Consultar fuente
Los patrones concretos dependen del CRM, ERP, versión, plan, API disponible, modelo de datos y proceso de negocio. Los ejemplos de esta guía son criterios de arquitectura, no configuraciones universales para un producto concreto.
