
AUTOMATIZACIÓN EN PRODUCCIÓN · MONITORIZACIÓN · ERRORES · IA
Cómo monitorizar una automatización en producción: errores, reintentos, alertas y trazabilidad
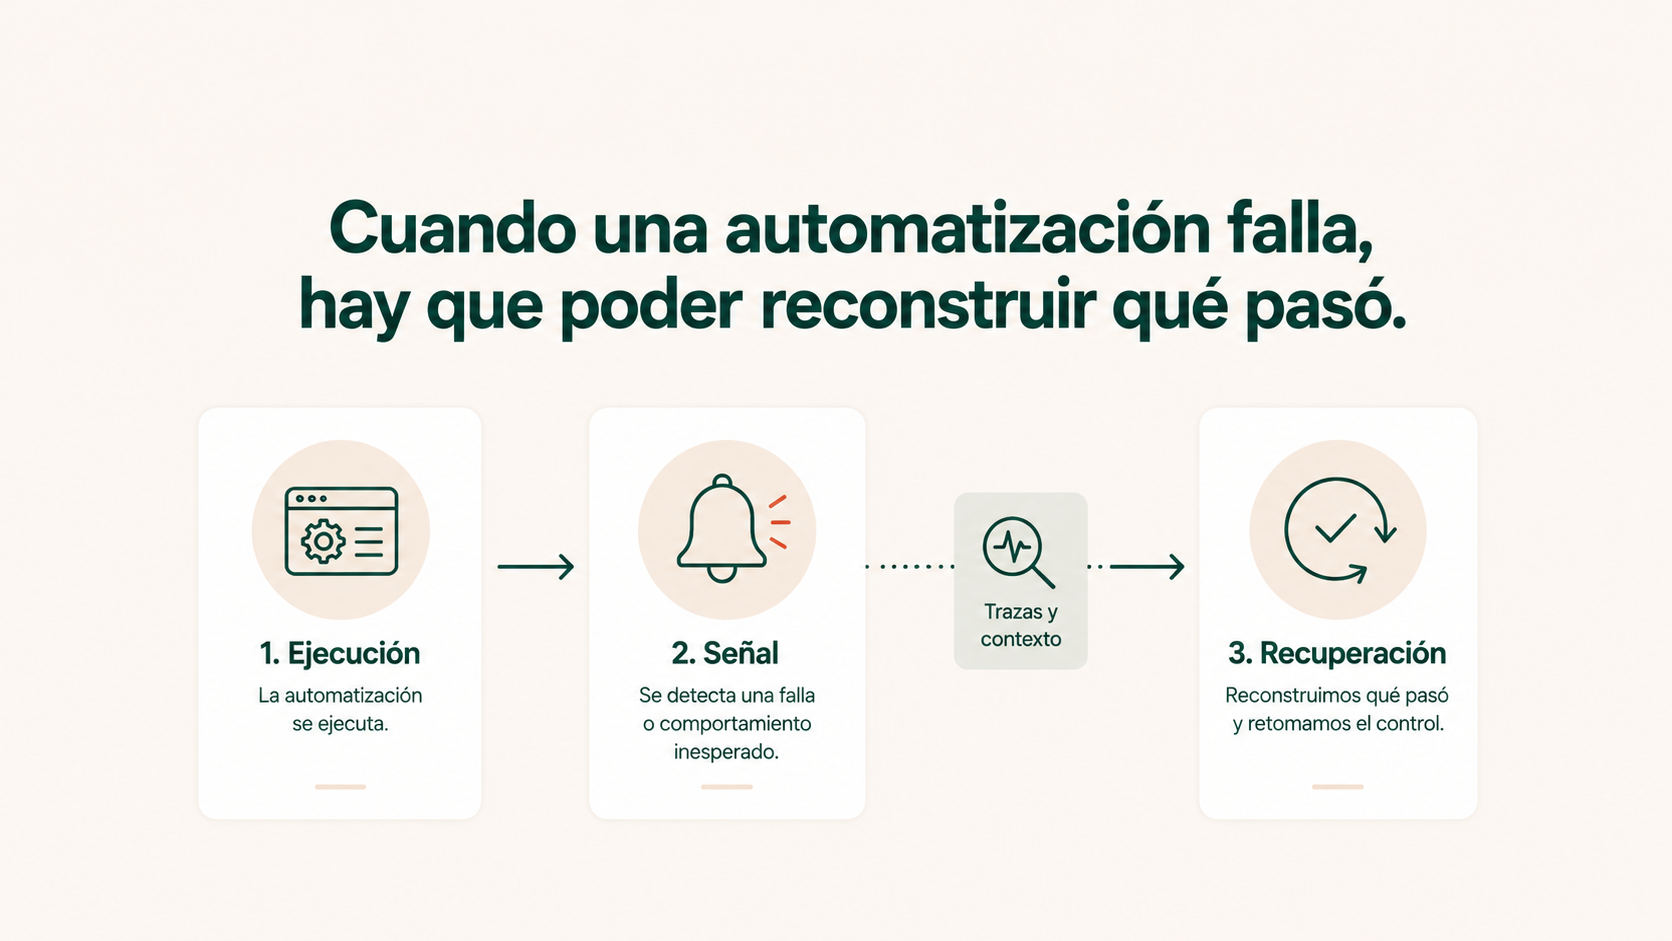
Una automatización puede aparecer como ejecutada correctamente y, aun así, haber dejado un pedido sin crear, un archivo vacío o un caso sin siguiente paso. La fiabilidad no consiste en evitar cualquier fallo, sino en detectar qué ha ocurrido, limitar su impacto, recuperar el proceso y poder reconstruir después toda la secuencia.
Un workflow en producción necesita algo más que un histórico de ejecuciones. Hay que poder distinguir si no arrancó, falló, quedó a medias, produjo un resultado incorrecto o terminó sin completar el efecto esperado en otro sistema.
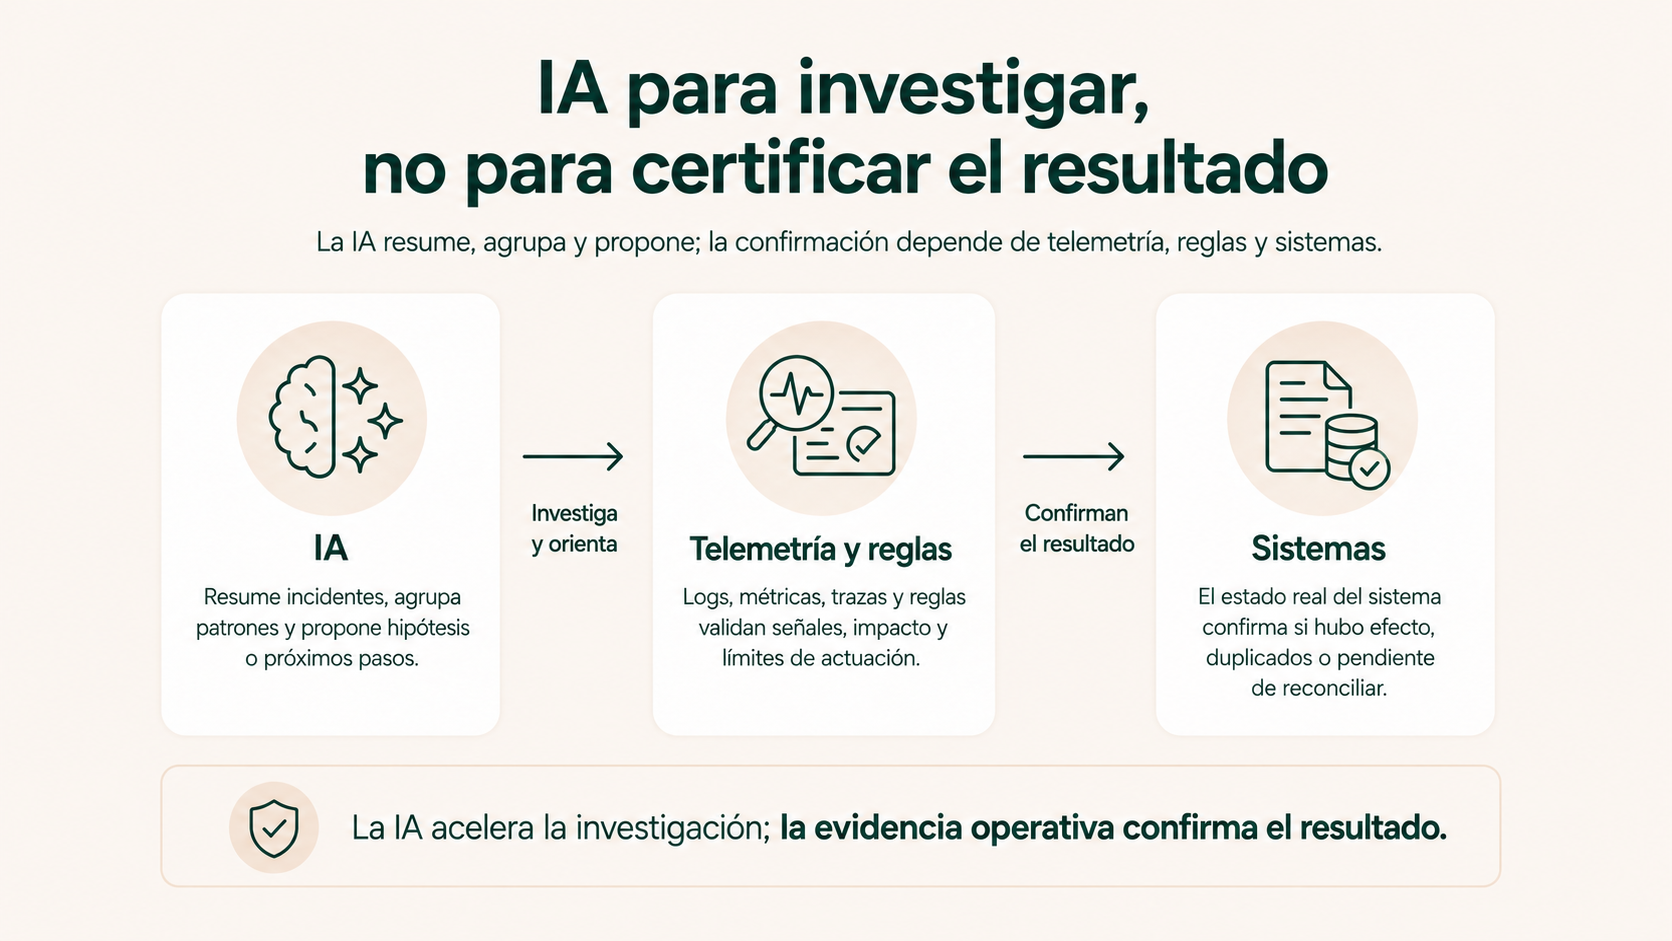
El sistema de monitorización debe permitir detectar, clasificar, recuperar, alertar y reconciliar. La IA puede acelerar mucho la investigación de incidentes, pero no debe declarar por sí sola una causa raíz, un éxito final ni ejecutar reintentos sensibles sin reglas y evidencias.
El workflow está en verde, pero el pedido no aparece en el ERP
El lunes por la mañana un cliente llama porque un pedido que envió el viernes no figura en el ERP. El equipo abre la plataforma de automatización y ve una ejecución marcada como correcta. No hay un error rojo, no hay una alerta y nadie recibió ninguna notificación durante el fin de semana.
Al revisar el recorrido aparece la explicación: el archivo llegó, se leyó correctamente y el workflow terminó. Sin embargo, una de las líneas del pedido no pudo relacionarse con un producto válido y el proceso siguió adelante sin crear el pedido. Técnicamente hubo una ejecución. Operativamente, el resultado esperado nunca existió.
Este tipo de incidente resume uno de los problemas más importantes cuando una automatización pasa del piloto a producción. Durante una demo basta con comprobar que el flujo se ejecuta. En producción importa algo más difícil: saber si el proceso realmente dejó el negocio en un estado coherente.
Por eso monitorizar una automatización no consiste únicamente en mirar si una ejecución terminó con éxito o error. También hay que saber qué se esperaba que ocurriera, qué ocurrió realmente, qué dependencias intervinieron y qué casos necesitan una actuación posterior.
Una automatización fiable no es la que nunca falla. Es la que permite detectar el fallo, limitar su impacto, recuperar el proceso y reconstruir qué ocurrió.
La fiabilidad empieza cuando aceptamos que los fallos van a ocurrir
Las automatizaciones dependen de APIs, credenciales, archivos, bases de datos, servicios externos, modelos de IA, redes y sistemas de terceros. Aunque el diseño sea correcto, cualquiera de esas piezas puede responder más tarde, rechazar una petición, cambiar un permiso o devolver un dato inesperado.
El objetivo no debería ser prometer “cero fallos”. Esa promesa empuja a ocultar el riesgo en lugar de gestionarlo. Una arquitectura madura parte de otra pregunta: cuando algo falle, ¿cómo nos enteramos y qué pasa con el caso afectado?
La respuesta obliga a separar varias capacidades:
- Detección: saber que ocurrió algo anómalo.
- Clasificación: entender qué tipo de fallo es y qué recuperación admite.
- Contención: impedir que el problema se multiplique.
- Recuperación: reintentar, corregir, derivar o continuar desde un punto seguro.
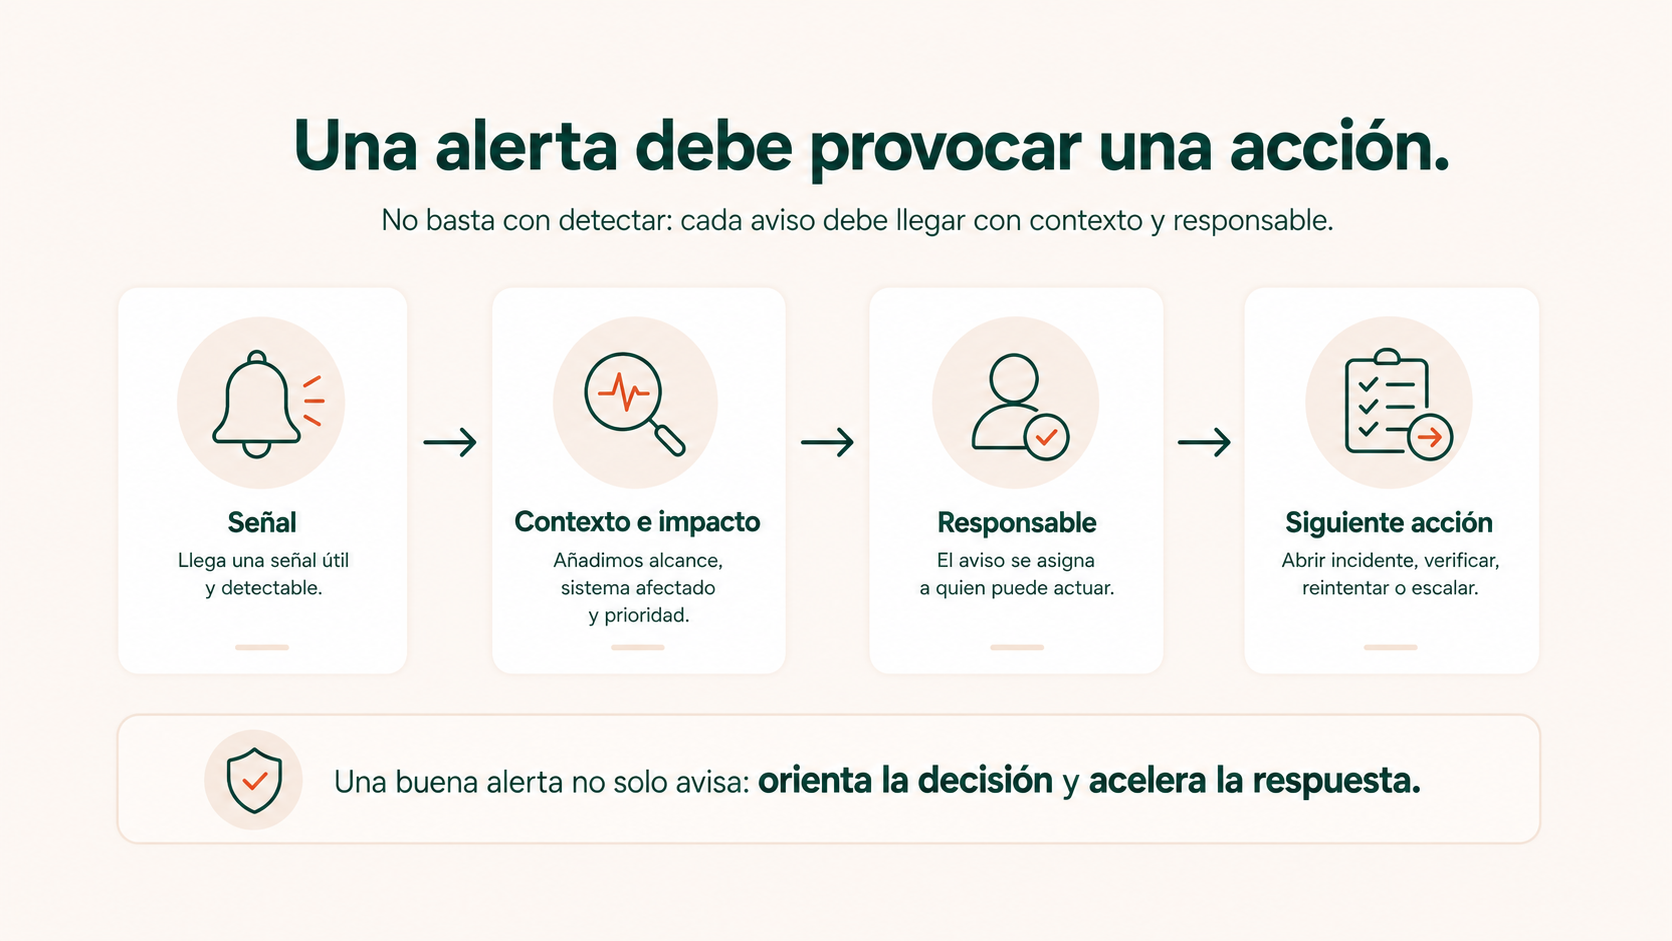
- Alerta: avisar a la persona adecuada solo cuando tiene una acción útil que realizar.
- Trazabilidad: conservar información suficiente para reconstruir la secuencia.
- Reconciliación: comprobar después que los sistemas han vuelto a quedar coherentes.
Esta entrada se ocupa de esa salud técnica y operativa. La pregunta de si la automatización ahorra tiempo, mejora el servicio o genera retorno económico pertenece a cómo medir una automatización con KPIs y línea base. Son dos niveles complementarios, pero no deberían mezclarse.
El recorrido de un fallo en producción
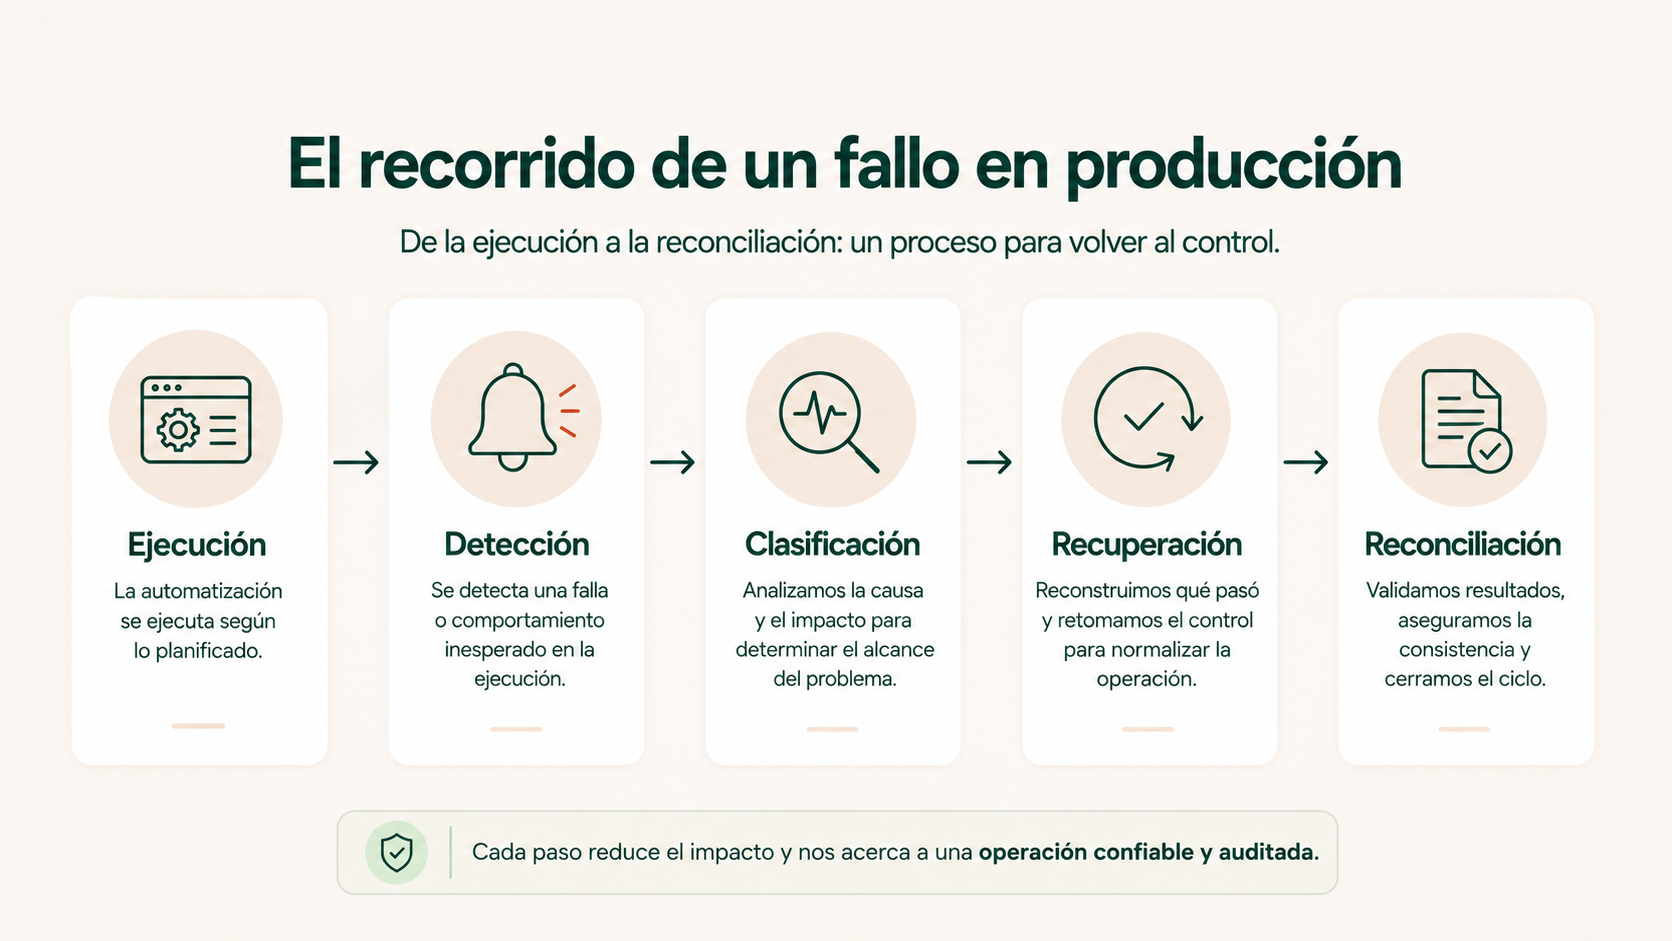
Para explicarlo sin convertir la monitorización en una disciplina reservada a ingenieros, resulta útil pensar en cinco etapas.
1. Ejecución
El proceso arranca por horario, evento, webhook, acción humana o cualquier disparador definido. Debemos saber qué caso estaba procesando y qué resultado esperaba conseguir.
2. Detección
Una señal indica que algo no encaja: error técnico, timeout, dato inválido, ausencia de resultado, duración anómala o diferencia entre sistemas.
3. Clasificación
Se determina si el fallo puede desaparecer con un reintento, necesita una corrección, exige comprobar el sistema destino o afecta a una dependencia completa.
4. Recuperación
El caso se reintenta de forma segura, espera, continúa desde un punto válido o pasa a una persona con el contexto necesario.
5. Reconciliación
Una vez recuperado el servicio se comprueba qué operaciones quedaron incompletas, duplicadas, pendientes o en un estado diferente al esperado.
Esta última etapa suele olvidarse. Se arregla la credencial, la API vuelve a responder y el equipo da el incidente por cerrado. Pero durante la caída puede haber veinte casos en estados diferentes. Recuperar el sistema no significa haber recuperado todos los casos afectados.
Seis tipos de fallo que requieren respuestas diferentes
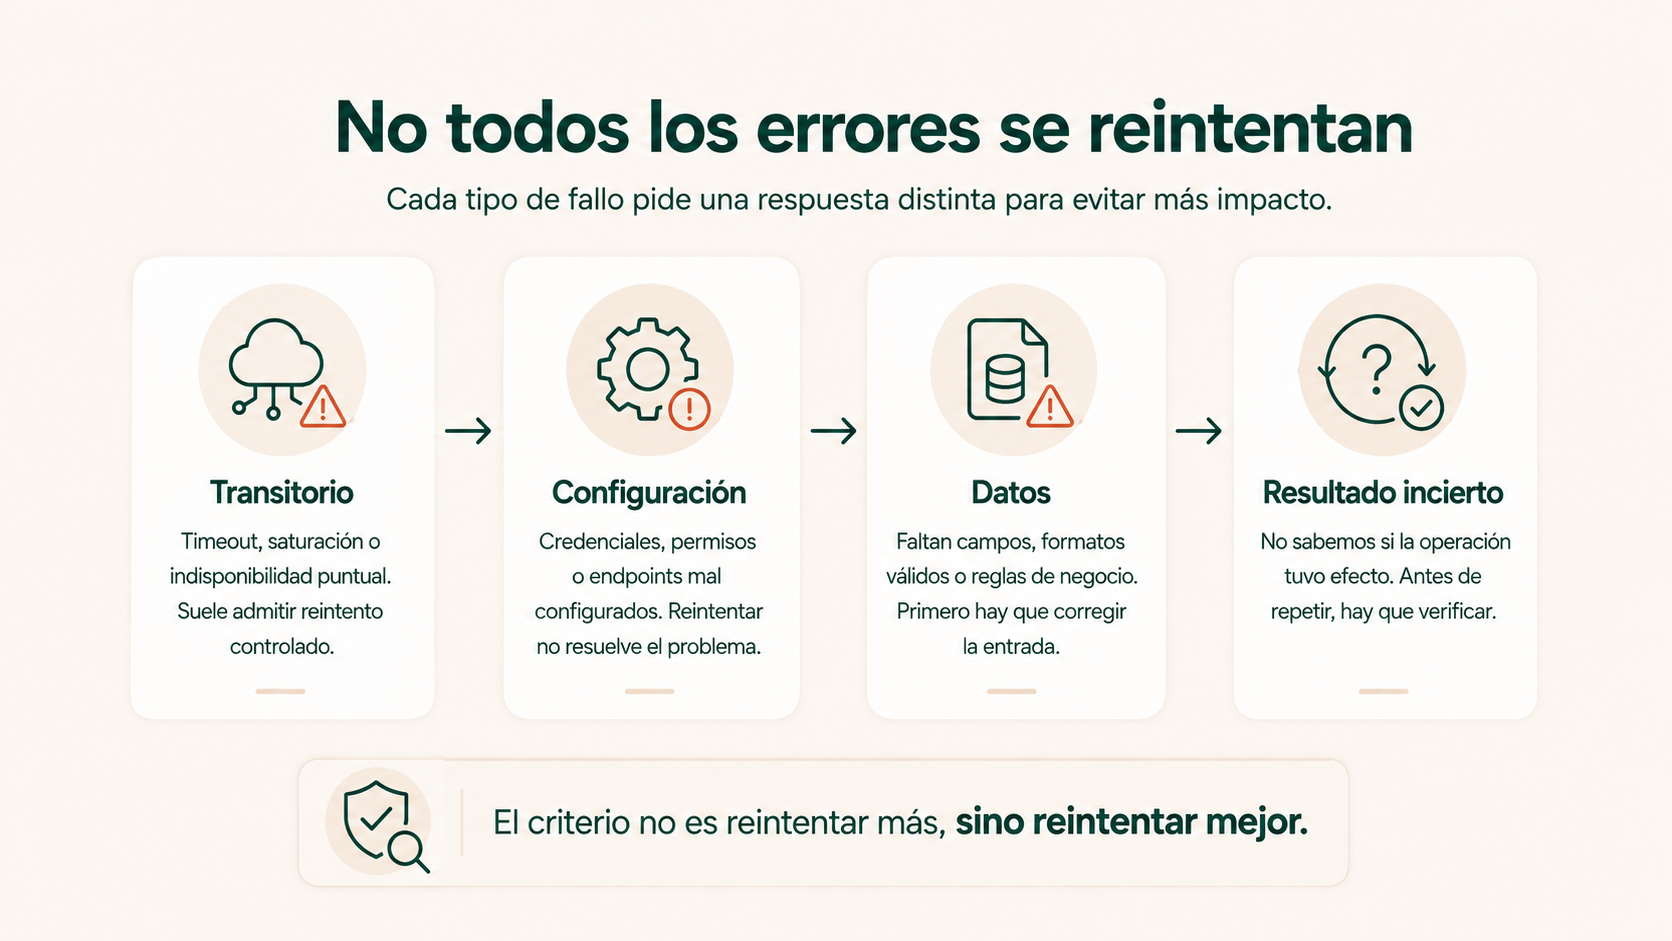
No todos los errores deberían activar el mismo tratamiento. Clasificarlos ayuda a evitar tanto reintentos inútiles como escalados innecesarios.
| Tipo | Ejemplo | Respuesta habitual |
|---|---|---|
| Transitorio | Una API devuelve temporalmente 429 o 503. | Esperar y reintentar bajo una política limitada. |
| Configuración o permanente | Credencial revocada o campo obligatorio inexistente. | Detener y corregir la causa; repetir sin cambios no ayuda. |
| Datos o negocio | El cliente o producto no puede identificarse con suficiente seguridad. | Crear excepción o solicitar información; no inventar el dato. |
| Resultado incierto | Timeout después de enviar una orden de creación. | Comprobar el sistema destino antes de repetir. |
| Silencioso | El workflow termina, pero el archivo generado está vacío. | Validar el resultado esperado y alertar si no cumple condiciones. |
| Sistémico | Una dependencia común falla para muchos procesos. | Contener, reducir carga, agrupar alertas y gestionar el incidente de forma global. |
El error más costoso es tratar todos estos escenarios como “algo falló, vuelve a intentarlo”. Un problema de permisos no mejora por repetir diez veces. Un timeout después de crear una factura puede empeorar si cada reintento crea otra. Y un fallo silencioso ni siquiera entrará en la lógica de reintentos si nadie ha definido cómo comprobar el resultado.
Reintentar puede recuperar un proceso o multiplicar el problema
Los reintentos son útiles cuando el fallo es temporal. También son una fuente habitual de incidencias cuando se aplican sin distinguir la causa.
Hay tres conceptos técnicos que merece la pena entender, aunque el decisor no vaya a configurarlos personalmente.
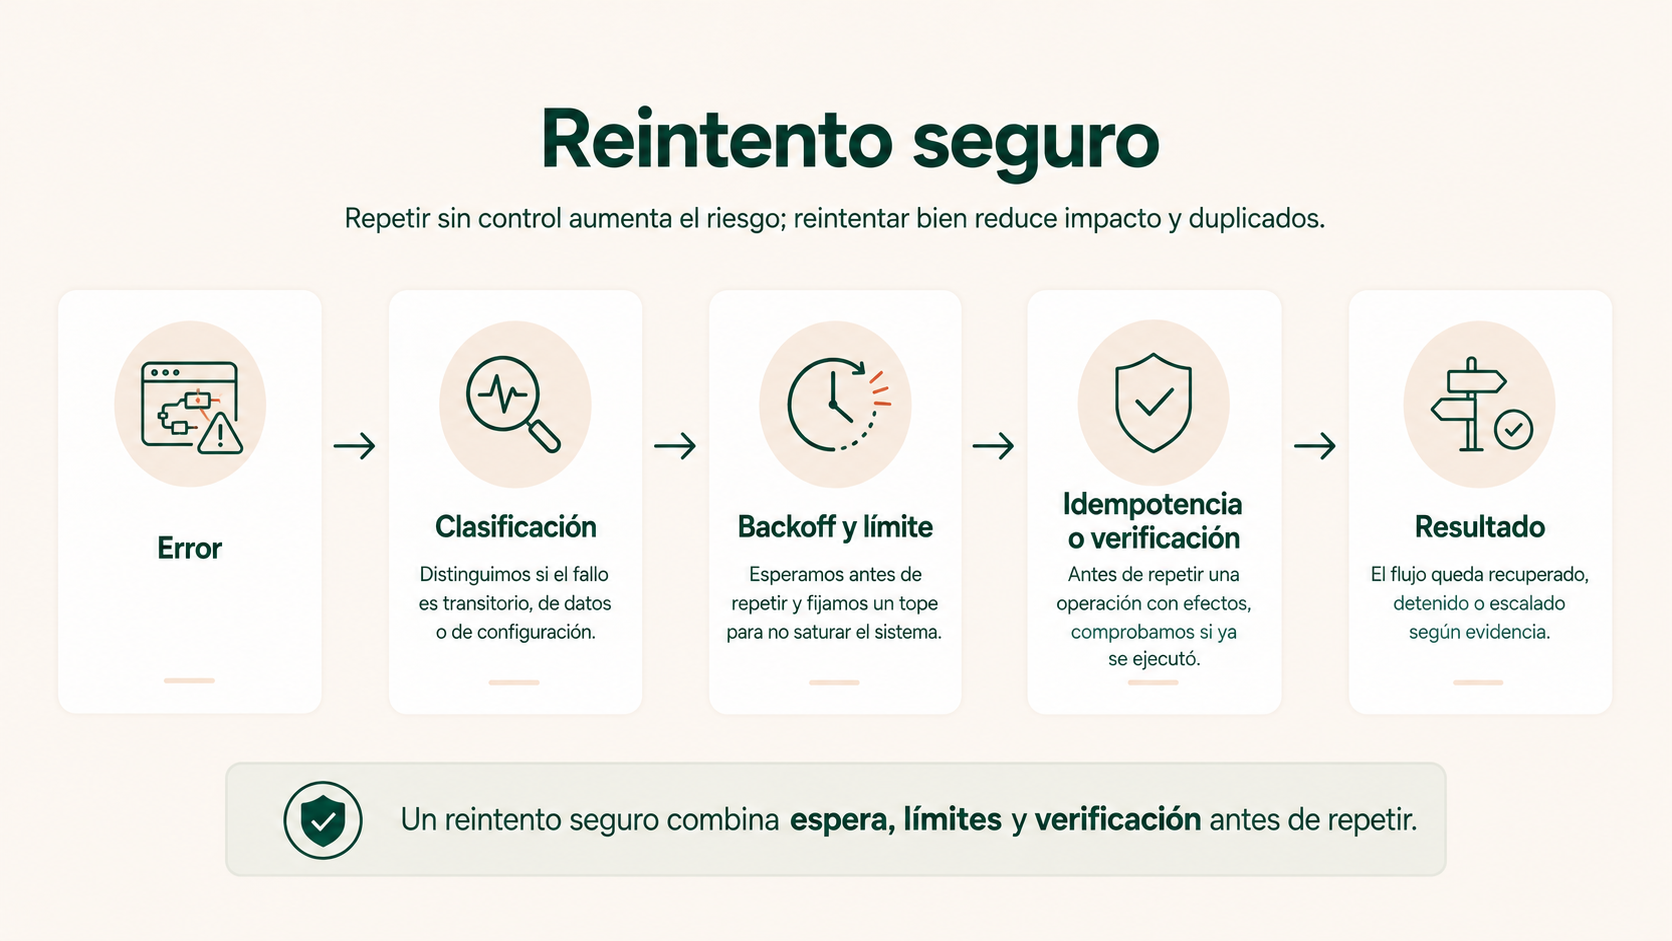
Backoff: dejar más tiempo entre intentos
Si un servicio está saturado, repetir la misma petición inmediatamente puede aumentar la saturación. Un backoff hace que los siguientes intentos esperen progresivamente más tiempo. En lenguaje sencillo: en vez de llamar una y otra vez a una puerta que no responde, cada intento deja más margen antes del siguiente.
Jitter: evitar que todos vuelvan a intentarlo a la vez
Si cientos de procesos fallan al mismo tiempo y todos esperan exactamente el mismo intervalo, también volverán a llamar al mismo tiempo. El jitter introduce una pequeña variación aleatoria en esa espera para repartir los reintentos y evitar nuevos picos coordinados.
Idempotencia: repetir sin duplicar el efecto
La idempotencia busca que procesar de nuevo la misma operación no provoque un segundo efecto no deseado. Por ejemplo, si un pedido con el mismo identificador vuelve a procesarse, el sistema debería poder reconocerlo o aplicar una protección equivalente antes de crear un duplicado.
No existe un número universal de reintentos, segundos de espera o timeout correcto. Depende del servicio, del efecto de la operación, del volumen y de cuánto tiempo siga siendo útil completar el caso. Lo importante es que la política de reintentos sea explícita y comprobada, no una reacción automática ante cualquier error.
El resultado incierto: cuando no sabemos si la operación llegó a completarse
Este caso merece un tratamiento separado porque puede generar los incidentes más difíciles de detectar.
Imaginemos que una automatización envía a un ERP la petición para crear un pedido. El ERP tarda en responder y la conexión termina por timeout. Desde la automatización parece un fallo. Pero hay dos posibilidades:
- El ERP nunca recibió o ejecutó la petición.
- El ERP creó el pedido y únicamente se perdió la respuesta.
Reintentar a ciegas puede ser correcto en el primer caso y crear un duplicado en el segundo.
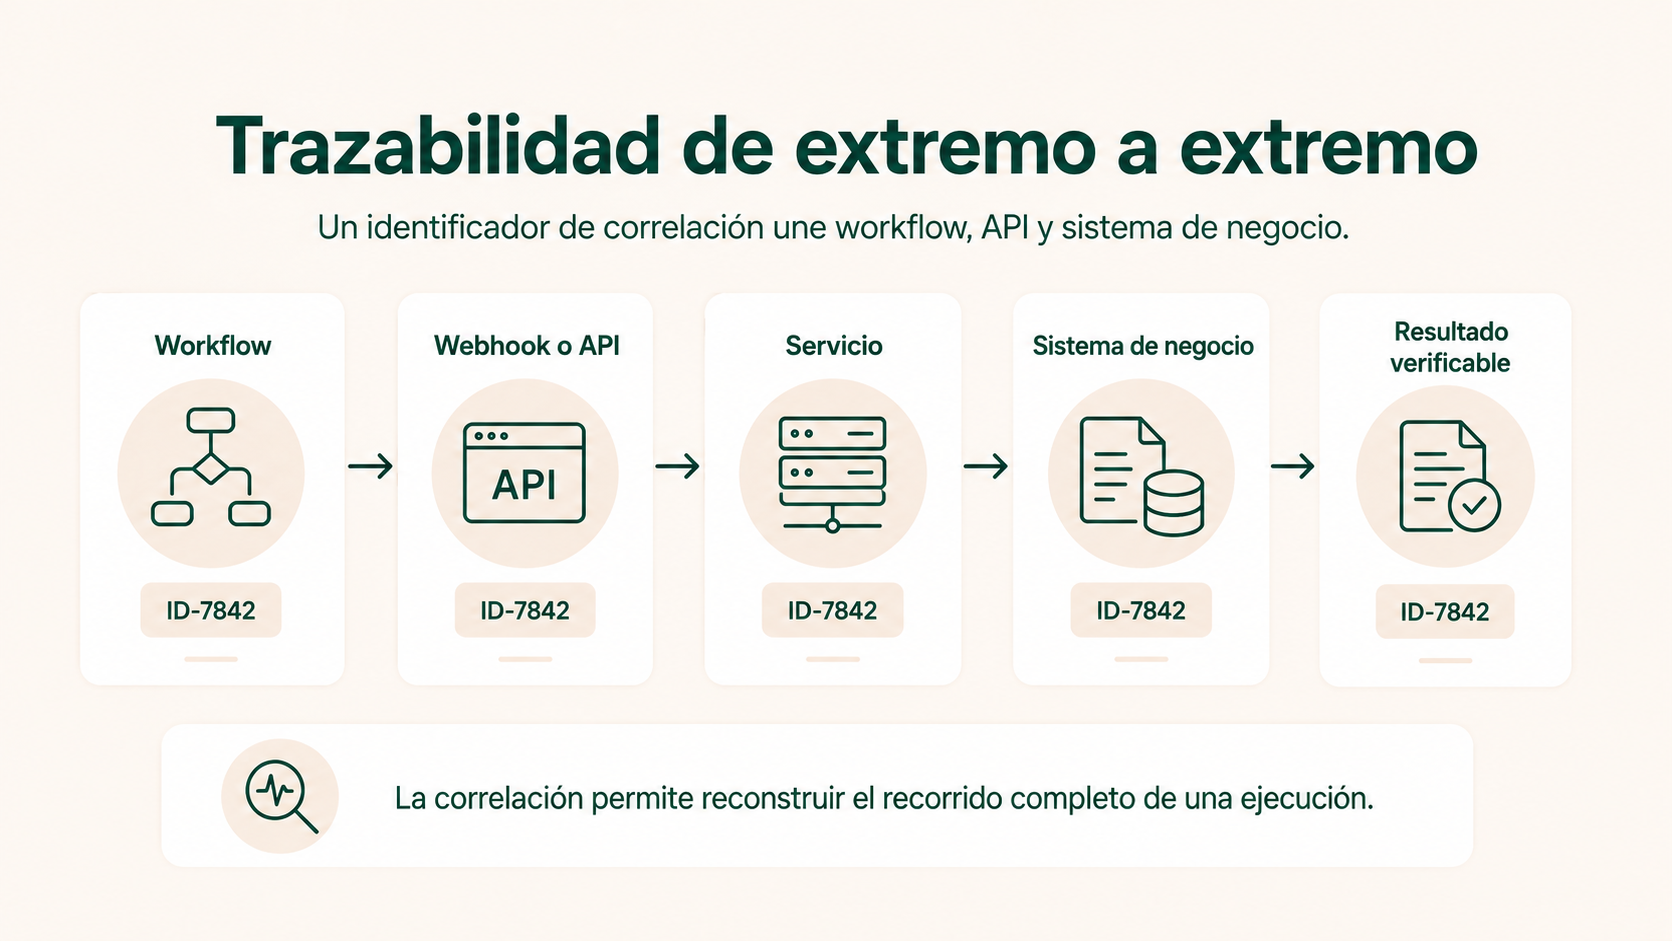
Por eso, cuando una operación produce efectos —crear un pedido, emitir una factura, registrar un pago, enviar una comunicación sensible— conviene poder verificar primero el estado del sistema destino. Un identificador de correlación, una referencia externa o una clave idempotente pueden facilitar esa comprobación. La misma protección resulta útil para evitar registros duplicados cuando un webhook se reprocesa después de un timeout o de una entrega repetida.
La misma lógica apareció en la integración entre CRM y ERP: cuando no sabemos si una escritura terminó, verificar es más seguro que repetir por reflejo.
Logs, métricas y trazas: tres formas de mirar lo que está ocurriendo
La palabra observabilidad puede sonar más compleja de lo necesario. En este contexto significa tener información suficiente para entender el estado de una automatización sin tener que adivinarlo.
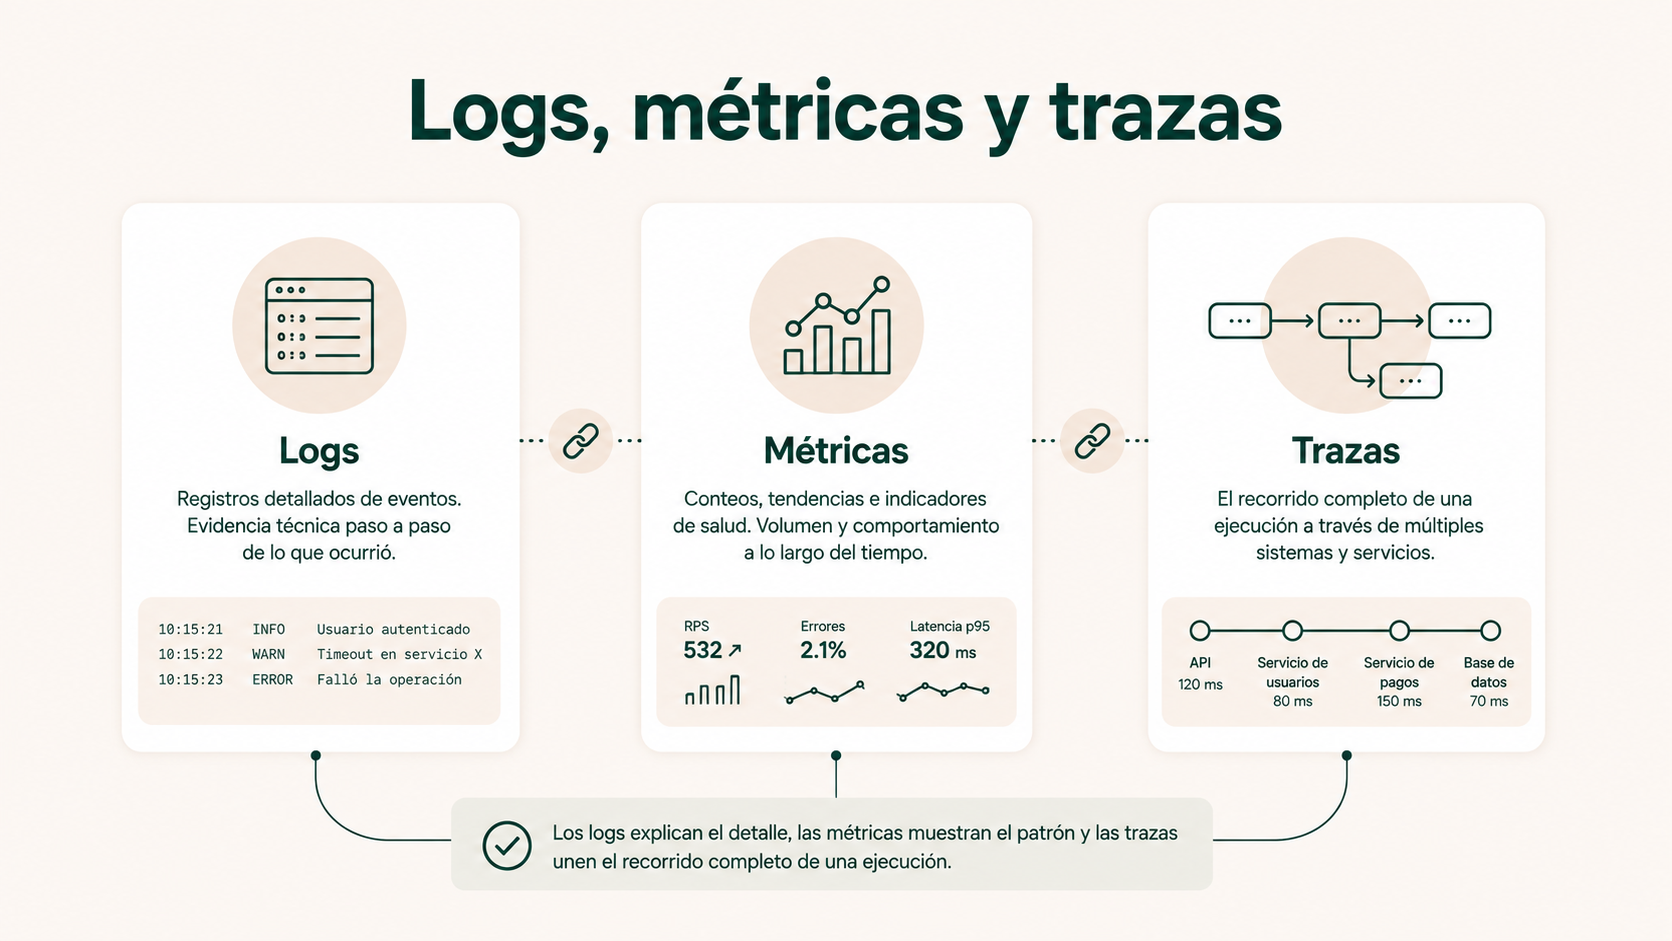
Logs
Son registros de eventos: comenzó la ejecución, respondió una API, faltó un campo, se creó un pedido o se produjo un error. Ayudan a investigar qué ocurrió.
Métricas
Son medidas agregadas: número de ejecuciones, porcentaje de errores, duración, reintentos, cola pendiente o volumen por periodo. Ayudan a detectar tendencias y anomalías.
Trazas
Permiten seguir un caso a través de varios componentes: entrada, automatización, API, servicio intermedio y sistema destino. Son especialmente útiles cuando el recorrido cruza varios sistemas.
Un identificador de correlación ayuda a unir esas piezas. Es una referencia que acompaña al mismo caso durante el recorrido para poder buscar después sus eventos en distintos componentes. No hace falta que la dirección conozca cómo se implementa; sí conviene que pregunte si existe una forma fiable de seguir un caso de principio a fin.
OpenTelemetry puede ser útil cuando la arquitectura necesita una forma estándar de generar y exportar señales como logs, métricas y trazas. No es un requisito para cualquier automatización. En un flujo sencillo puede bastar con el histórico de ejecuciones, una base de incidencias y alertas bien diseñadas. La complejidad de la monitorización debe guardar proporción con el riesgo y la arquitectura real.
Los fallos silenciosos exigen comprobar resultados, no solo errores
Una automatización puede terminar sin lanzar ninguna excepción y, aun así, no haber cumplido su propósito.
Ejemplos habituales:
- Se genera un Excel, pero contiene cero filas cuando debería contener datos.
- Se procesa un email, pero ninguna línea termina creando el pedido esperado.
- Se marca una tarea como enviada, pero la integración nunca genera el identificador del sistema destino.
- Un agente de IA devuelve una respuesta sintácticamente válida, pero sin la estructura mínima que el siguiente paso necesita.
- Un proceso diario termina correctamente, aunque ese día ni siquiera llegó la entrada que normalmente lo activa.
La solución es incorporar comprobaciones de resultado. No tienen que ser complejas: “el archivo contiene al menos una fila”, “el pedido tiene identificador del ERP”, “el número de casos procesados cuadra con el origen”, “el estado final pertenece al conjunto permitido”.
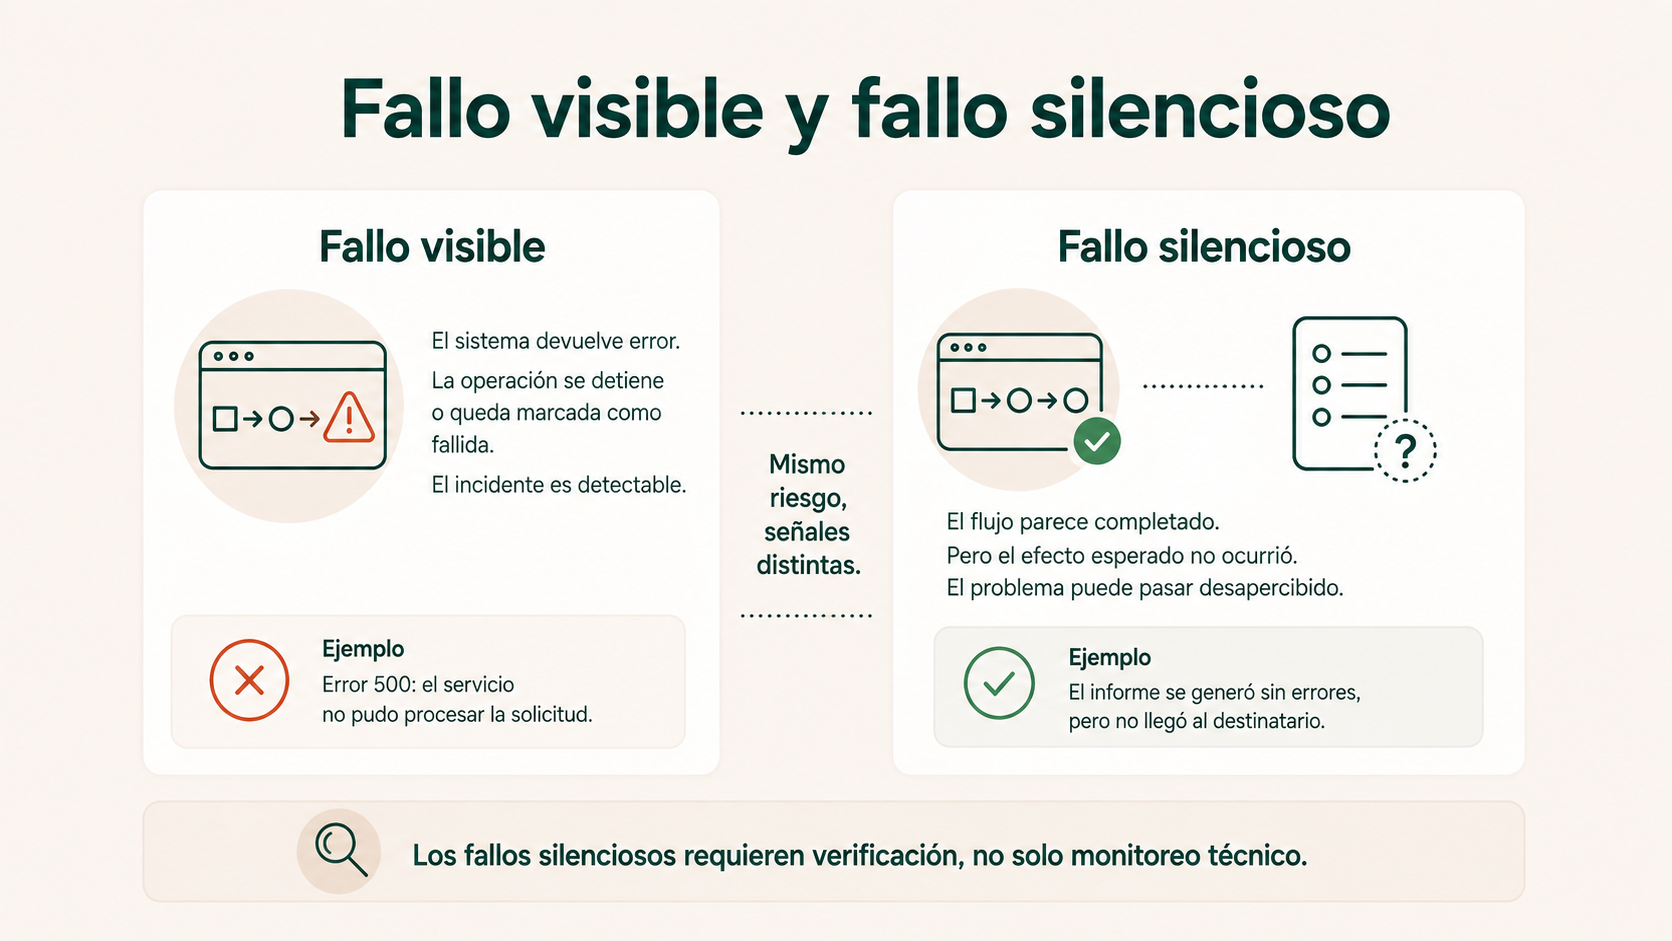
Estas validaciones deben representar condiciones reales del proceso. No conviene inventar reglas técnicas que no tengan significado empresarial. El objetivo es responder: ¿cómo sabemos que esta ejecución dejó el caso en el estado que esperábamos?
Una buena alerta debe ayudar a decidir qué hacer, no limitarse a decir “algo falló”
Cuando cualquier error envía un email, un Slack y un WhatsApp, el sistema parece muy vigilado durante la primera semana. Un mes después nadie lee los avisos.
La saturación de alertas aparece cuando hay demasiado ruido, duplicados o mensajes sin contexto. Para evitarla, una alerta debería responder, cuando sea posible, a cuatro preguntas:
- ¿Qué ha ocurrido?
- ¿A qué proceso o casos afecta?
- ¿Qué impacto puede tener?
- ¿Qué acción se espera de quien la recibe?
También conviene agrupar incidencias relacionadas. Si una API externa está caída, recibir 300 alertas —una por cada caso— puede ocultar el verdadero problema. Tiene más sentido una alerta del incidente sistémico y una cola de casos afectados para reconciliar después.
Los umbrales tampoco deberían copiarse de otra empresa. Un aumento de errores del 1 % puede ser crítico en un proceso y normal en otro. La alerta se diseña alrededor de condiciones operativas relevantes, experiencia histórica y capacidad real de respuesta.
Dónde puede ayudar la IA en la monitorización y resolución de incidentes
La monitorización produce mucha información técnica que una persona debe convertir en hipótesis y decisiones. Ahí la IA puede aportar bastante valor, especialmente cuando existen logs extensos, mensajes heterogéneos y varias fuentes que relacionar.
Resumir incidentes
Convertir decenas de mensajes técnicos y eventos en un resumen comprensible: qué empezó a fallar, cuándo, qué componentes aparecen implicados y cuántos casos pueden estar afectados.
Agrupar errores similares
Detectar que cien ejecuciones contienen variantes del mismo problema en lugar de tratarlas como cien incidentes independientes.
Interpretar mensajes técnicos
Traducir respuestas de APIs, stack traces o errores de proveedores a lenguaje operativo para que el equipo pueda entender qué parte del proceso está afectada.
Buscar patrones
Relacionar aumentos de errores con un despliegue, un tipo de documento, una versión de API, un proveedor o una franja temporal.
Preparar hipótesis
Proponer posibles causas y comprobaciones siguientes a partir de la evidencia disponible, dejando claro que son hipótesis y no conclusiones.
Preparar el informe del incidente
Ordenar cronología, impacto, actuaciones, recuperación y pendientes de reconciliación para facilitar el cierre y el aprendizaje posterior.
La IA puede acelerar la investigación; no debe convertirse en la fuente que confirma por sí sola qué ocurrió. La causa raíz exige evidencias. El éxito final debe comprobarse en los sistemas implicados. Y un reintento sensible necesita reglas explícitas sobre cuándo es seguro ejecutarlo.
En arquitecturas con agentes, esta precaución es todavía más importante. Dar acceso a logs y herramientas no debería permitir que un agente reinicie procesos, repita pagos, reenvíe comunicaciones o modifique sistemas sin los límites definidos en permisos y credenciales para agentes de IA.
La monitorización tampoco sustituye la validación previa: antes de ampliar capacidades conviene evaluar el agente con casos repetibles, límites y regresiones, y después observar en producción los fallos y comportamientos que el entorno controlado no había anticipado.
Reconciliar es comprobar qué quedó pendiente después de recuperar el sistema
Supongamos que una credencial caducó a las 10:00 y se corrige a las 11:20. El workflow vuelve a funcionar. El incidente técnico parece resuelto. Pero todavía falta responder una pregunta: ¿qué ocurrió con los casos que llegaron durante esos ochenta minutos?
Algunos pueden haber fallado antes de escribir. Otros pueden haber escrito parcialmente. Otros quizá se procesaron por un canal alternativo. Por eso la reconciliación compara lo que debería existir con lo que realmente existe.
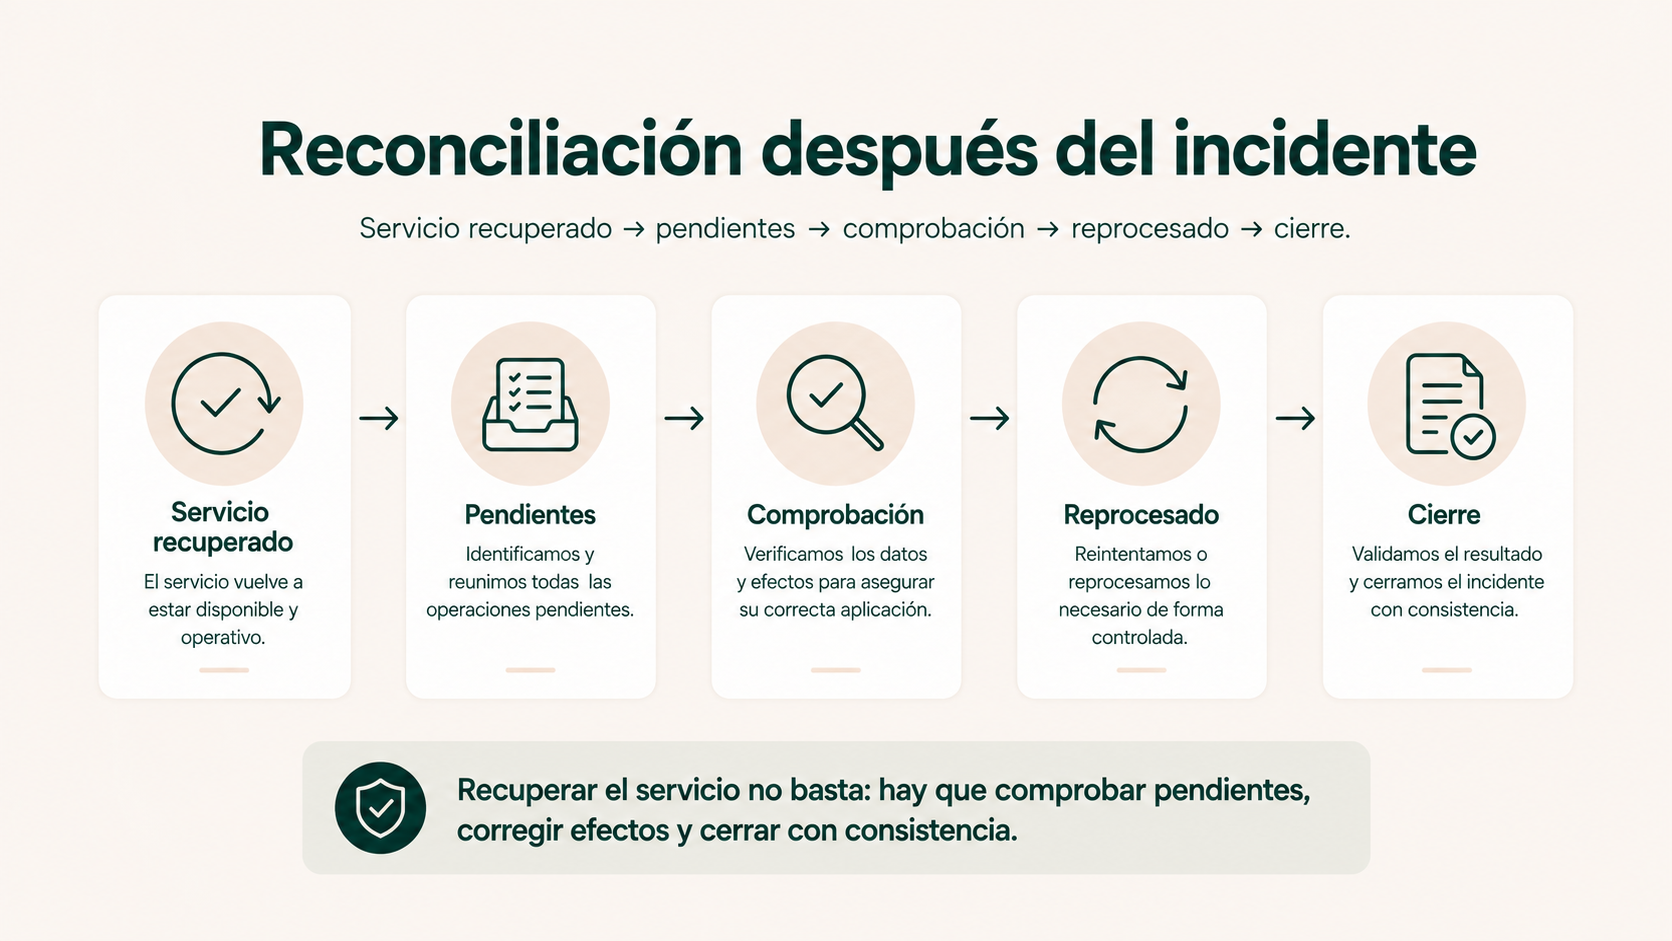
Dependiendo del proceso, puede consistir en:
- Comparar pedidos recibidos con pedidos creados.
- Buscar ejecuciones fallidas que no tengan una posterior ejecución correcta.
- Detectar duplicados después de reintentos.
- Comprobar registros creados sin todos sus campos o relaciones.
- Revisar casos enviados a una cola manual que nunca se cerraron.
- Confirmar que una recuperación masiva no volvió a generar comunicaciones ya enviadas.
Esta capa convierte la recuperación técnica en recuperación operativa. Si no existe, una incidencia puede quedar “cerrada” en el panel técnico mientras sus consecuencias siguen abiertas durante días.
Qué piezas necesita una arquitectura de monitorización útil
No existe una única herramienta obligatoria. Lo importante es cubrir las funciones necesarias con el nivel de complejidad que el proceso justifique.
1. Automatización y sistemas implicados
Workflow, APIs, ERP/CRM, almacenamiento, servicios externos, modelos de IA y cualquier dependencia que pueda afectar al resultado.
2. Registro de ejecuciones y eventos
Información suficiente para saber qué caso se procesó, cuándo, con qué versión, qué pasos se ejecutaron y qué resultado se obtuvo.
3. Métricas y condiciones de salud
Volumen, errores, duración, colas, reintentos, casos atascados y otras señales que permitan detectar cambios relevantes.
4. Alertas y gestión de incidencias
Avisos agrupados y accionables, con responsable y contexto suficiente para actuar.
5. Investigación asistida por IA
Resumen, clasificación, agrupación y análisis de patrones, siempre sobre telemetría autorizada y con resultados tratados como apoyo a la investigación.
6. Recuperación y reconciliación
Reintentos seguros, colas, intervención manual, verificación del destino y controles para cerrar los casos afectados.
En sistemas distribuidos puede ser útil una capa común de telemetría y correlación. En procesos sencillos, una arquitectura mucho más ligera puede ser suficiente. Monitorizar mejor no significa instalar más herramientas; significa reducir los puntos en los que un fallo puede permanecer invisible.
n8n como ejemplo: el histórico de ejecuciones es un punto de partida, no toda la estrategia
Cuando se trabaja con automatización de procesos en n8n y gestión de errores, el histórico de ejecuciones es uno de los primeros puntos de diagnóstico. n8n permite consultar ejecuciones y filtrarlas por estados como fallo, ejecución en curso, éxito o espera. También permite reintentar ejecuciones fallidas y elegir entre ejecutarlas con el workflow guardado actualmente o con la versión original de esa ejecución.
Estas capacidades resultan útiles para investigar y recuperar casos, pero no eliminan la necesidad de diseñar el proceso. La plataforma puede mostrar que una ejecución terminó correctamente; la empresa sigue necesitando definir qué resultado demuestra que el proceso quedó realmente completado.
Además, algunas capacidades concretas de ejecución o filtrado dependen del despliegue o plan. Por eso conviene comprobar la documentación de la versión y modalidad utilizadas antes de convertir una función de interfaz en parte obligatoria del diseño.
La misma filosofía se aplica a Make, Zapier o desarrollos propios. La herramienta ejecuta y registra; la arquitectura decide qué observar, qué validar, qué reintentar y qué escalar.
Los logs también pueden contener información sensible
Un error frecuente es tratar la telemetría como si fuera información puramente técnica. En realidad, un log puede contener nombres, emails, identificadores, contenido de documentos, prompts completos, respuestas de modelos, tokens, URLs firmadas o payloads con datos personales.
Por eso la monitorización necesita criterios de minimización y acceso. En automatizaciones con agentes o credenciales técnicas, este control se relaciona directamente con cómo limitar permisos y credenciales en automatizaciones con IA:
- No registrar credenciales, secretos o tokens en texto legible.
- Evitar guardar payloads completos cuando bastan identificadores, estados y metadatos.
- No copiar prompts o respuestas que contienen información sensible si no son necesarios para investigar.
- Separar logs técnicos, auditoría y contenido de negocio cuando tengan necesidades de acceso diferentes.
- Definir conservación y borrado de la telemetría en función de su finalidad.
- Limitar el acceso a los registros según función y necesidad real.
Más detalle no siempre significa mejor observabilidad. Puede significar más coste, más ruido y más exposición de información. La calidad está en capturar el contexto necesario para investigar sin convertir los logs en una copia indiscriminada de los sistemas de negocio.
Qué medir para conocer la salud técnica sin convertirlo en un cuadro de ROI
Estas métricas no sustituyen las de negocio de la entrada 32. Sirven para saber si la automatización está operando de forma controlada.
- Ejecuciones esperadas frente a ejecuciones realmente iniciadas.
- Ejecuciones correctas, fallidas, en espera o atascadas.
- Errores por tipo, dependencia o versión.
- Reintentos iniciados y resultado de esos reintentos.
- Duración y cambios relevantes respecto al comportamiento habitual.
- Casos que entran en revisión manual.
- Backlog o cola de excepciones sin resolver.
- Casos pendientes de reconciliación.
- Diferencias detectadas entre origen y destino.
- Incidentes repetidos después de una corrección.
No hay un valor universal correcto para ninguna de ellas. Un proceso que maneja excepciones complejas puede tener más intervención humana y ser perfectamente sano. Lo relevante es detectar cambios, acumulaciones y patrones que exijan una decisión.
Checklist para auditar una automatización que ya está en producción
Antes de añadir más lógica o más IA, conviene comprobar si la automatización actual puede responder a estas preguntas:
- ¿Sabemos cuántas ejecuciones esperamos? Un proceso que no arranca también puede ser un incidente.
- ¿Cada caso tiene una referencia que permita seguirlo?
- ¿Distinguimos fallo transitorio, permanente, de datos, incierto, silencioso y sistémico?
- ¿Los reintentos están limitados y solo se aplican donde son seguros?
- ¿Podemos comprobar el sistema destino antes de repetir una operación con efectos?
- ¿Existe alguna comprobación de resultado para detectar ejecuciones técnicamente correctas pero operativamente incompletas?
- ¿Las alertas indican responsable y siguiente acción?
- ¿Podemos agrupar un fallo común sin generar cientos de avisos?
- ¿Sabemos qué casos quedaron afectados después de recuperar un servicio?
- ¿Tenemos un proceso de reconciliación?
- ¿Los logs evitan credenciales y datos sensibles innecesarios?
- ¿La IA puede ayudar a investigar sin tener permiso para ejecutar acciones sensibles por su cuenta?
- ¿Los cambios de workflow o versiones permiten relacionar un aumento de errores con un despliegue concreto?
- ¿Después de un incidente queda registrado qué ocurrió, cómo se recuperó y qué debe cambiar?
Si varias respuestas son “no”, la automatización puede estar funcionando hoy y seguir siendo difícil de operar mañana. Es precisamente ahí donde una auditoría de automatizaciones existentes suele aportar más valor que añadir otra capa de automatización sobre un sistema que todavía no puede explicar sus propios fallos.
Preguntas frecuentes sobre monitorización de automatizaciones
¿Qué diferencia hay entre monitorización y observabilidad?
En la práctica empresarial pueden utilizarse de forma cercana. Monitorizar consiste en recoger y analizar señales sobre el estado del sistema. Observabilidad pone el énfasis en disponer de suficiente información —logs, métricas, trazas y contexto— para poder entender qué está ocurriendo incluso ante problemas no previstos.
¿Cada error de una automatización debería generar una alerta?
No. Algunos errores pueden recuperarse automáticamente y otros pertenecen al mismo incidente sistémico. Las alertas deberían priorizar situaciones accionables y evitar duplicados que terminen saturando al equipo.
¿Cuántas veces debe reintentarse una automatización?
No existe un número universal. Depende del tipo de fallo, la dependencia, el efecto de la operación, el tiempo durante el que siga siendo útil y la seguridad del reintento. Debe existir un límite y una política probada.
¿Qué es el backoff en un sistema de reintentos?
Es una estrategia que aumenta progresivamente el tiempo entre intentos para no seguir presionando a un servicio que está fallando o saturado. Suele combinarse con una pequeña variación aleatoria —jitter— para que muchos procesos no vuelvan a intentarlo exactamente al mismo tiempo.
¿Qué significa que una operación sea idempotente?
Significa, de forma simplificada, que repetir la misma operación no provoca efectos duplicados no deseados. Es especialmente importante cuando existe la posibilidad de reintentar creaciones, pagos, pedidos o comunicaciones.
¿Puede una IA detectar la causa raíz de un incidente?
Puede analizar logs, agrupar errores y proponer hipótesis muy útiles, pero la causa raíz debe confirmarse con evidencias. La IA no debería declarar un incidente resuelto ni ejecutar acciones sensibles únicamente a partir de una estimación.
¿OpenTelemetry es obligatorio para monitorizar automatizaciones?
No. Es un estándar abierto útil para trabajar con señales como trazas, métricas y logs en arquitecturas donde esa normalización aporta valor. Una automatización sencilla puede monitorizarse adecuadamente con una solución mucho más ligera.
¿Cómo se detecta un fallo silencioso?
Comprobando el resultado esperado, no solo el estado técnico de la ejecución. Por ejemplo, validar que el archivo generado contiene datos, que el ERP devolvió un identificador válido o que el número de casos procesados coincide con el origen.
Cuando una automatización falla, el problema no debería empezar con “¿qué ha pasado?”
Podemos revisar cómo se registran las ejecuciones, qué fallos pueden recuperarse, qué alertas necesitan contexto y qué casos quedan pendientes después de una incidencia.
Revisar cómo se detectan y resuelven fallosFuentes
- AWS Well-Architected Framework. Buenas prácticas sobre clasificación de errores, reintentos limitados, backoff, jitter e idempotencia. Consultar fuente
- Microsoft Azure Well-Architected Framework. Referencia para observabilidad, telemetría, correlación, alertas accionables y diseño de monitorización. Consultar fuente
- OpenTelemetry. Estándar abierto utilizado como referencia para explicar logs, métricas, trazas y contexto de telemetría. Consultar fuente
- n8n Docs. Documentación oficial sobre listado, filtrado y reintento de ejecuciones. Consultar fuente
Las capacidades concretas de una plataforma pueden variar por versión, modalidad de despliegue o plan. Deben verificarse en la documentación vigente del entorno utilizado antes de diseñar una dependencia operativa alrededor de ellas.
