
SUPERVISIÓN HUMANA · IA · AUTOMATIZACIÓN · AGENTES
Human-in-the-loop en IA: qué significa y dónde debe intervenir una persona
Poner un botón de «Aprobar» no convierte automáticamente una automatización en un sistema bien supervisado. El control humano funciona cuando sabemos qué debe revisar una persona, cuándo tiene que intervenir, qué información necesita y qué capacidad real tiene para cambiar el resultado.
No necesitas una persona mirando cada paso. Necesitas una persona en los pasos donde su criterio puede cambiar el resultado.
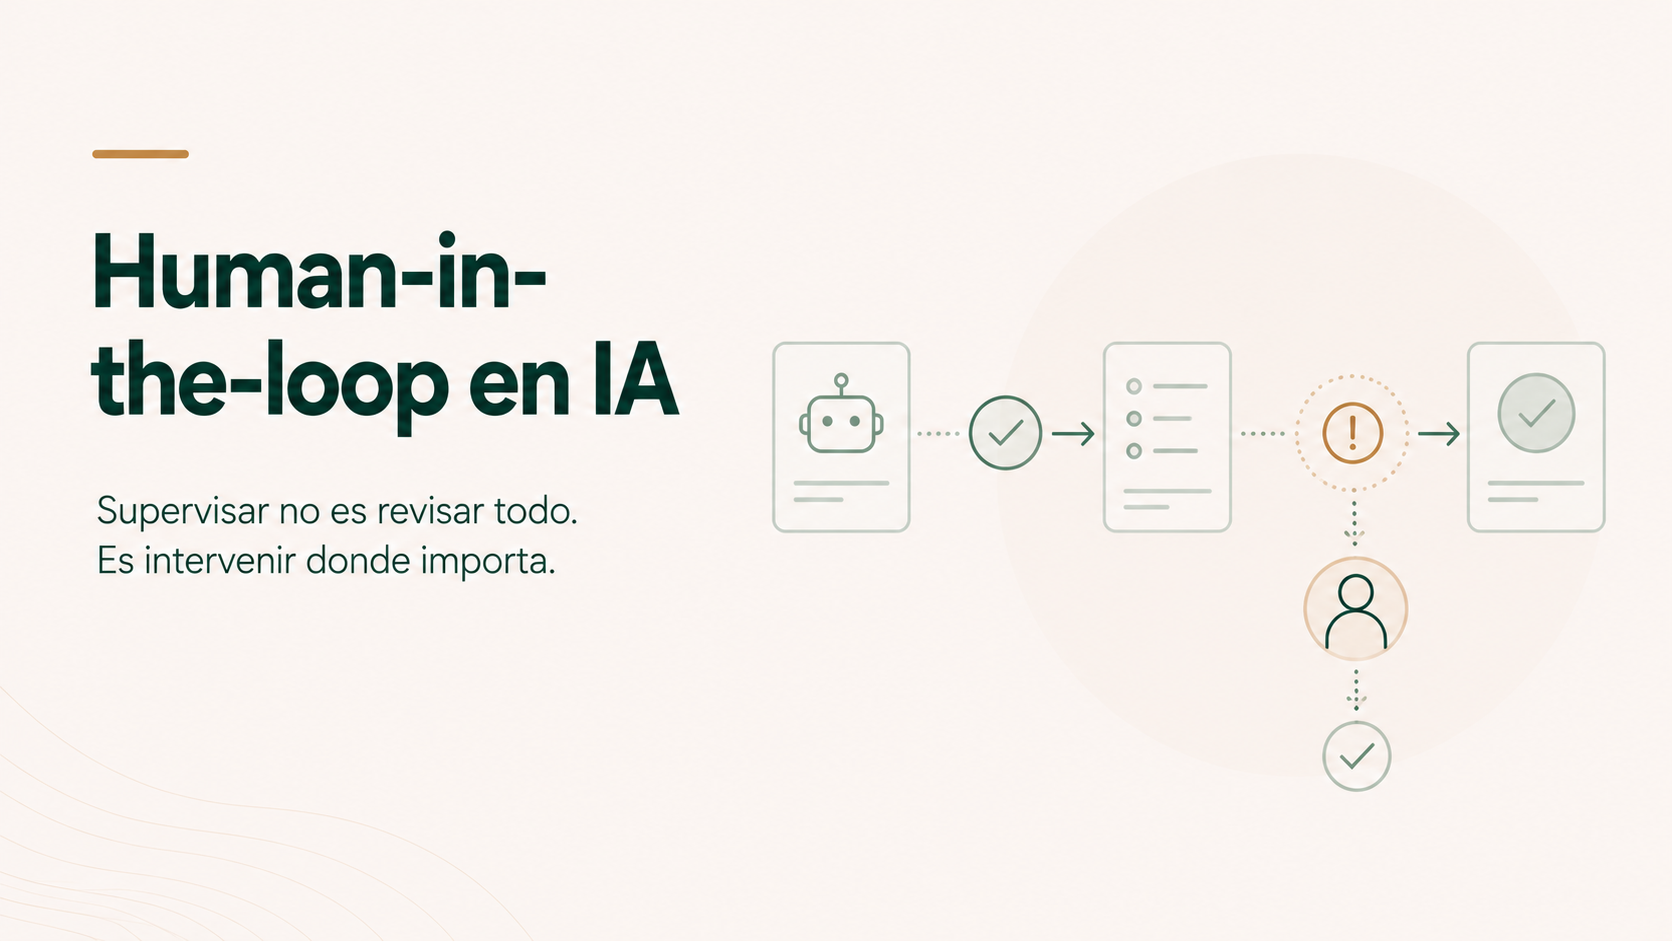
Human-in-the-loop no significa revisar manualmente todo lo que hace la IA. Significa diseñar puntos concretos donde una persona revisa, aprueba, resuelve una excepción o toma el control.
La intervención humana debe responder al riesgo de la acción, su reversibilidad, la posibilidad de verificar el resultado y la información que necesita quien decide.
Si la persona solo añade un clic y no puede cambiar el resultado de forma informada, el control es mucho menos útil de lo que parece.
La IA propone cancelar un pedido. Hay una persona delante de la pantalla. ¿Eso ya es human-in-the-loop?
No necesariamente.
Imaginemos que el sistema muestra: «Cancelar pedido 28471» y dos botones: Aprobar o Rechazar.
La persona no ve por qué se propone la cancelación. No sabe qué regla se ha aplicado. No ve el mensaje original del cliente. No puede consultar el estado del pedido. Y, además, el procedimiento interno prácticamente le obliga a aceptar lo que aparece en pantalla.
Hay una persona en el proceso, pero su capacidad de supervisar es muy limitada.
Human-in-the-loop (HITL) significa literalmente «humano en el circuito». En la práctica, describe una arquitectura donde una persona interviene deliberadamente en uno o varios puntos de un proceso automatizado para revisar, corregir, aprobar, resolver una excepción o recuperar el control.
HITL no es una persona mirando la automatización. Es una intervención diseñada con un propósito, información y capacidad real de decisión.
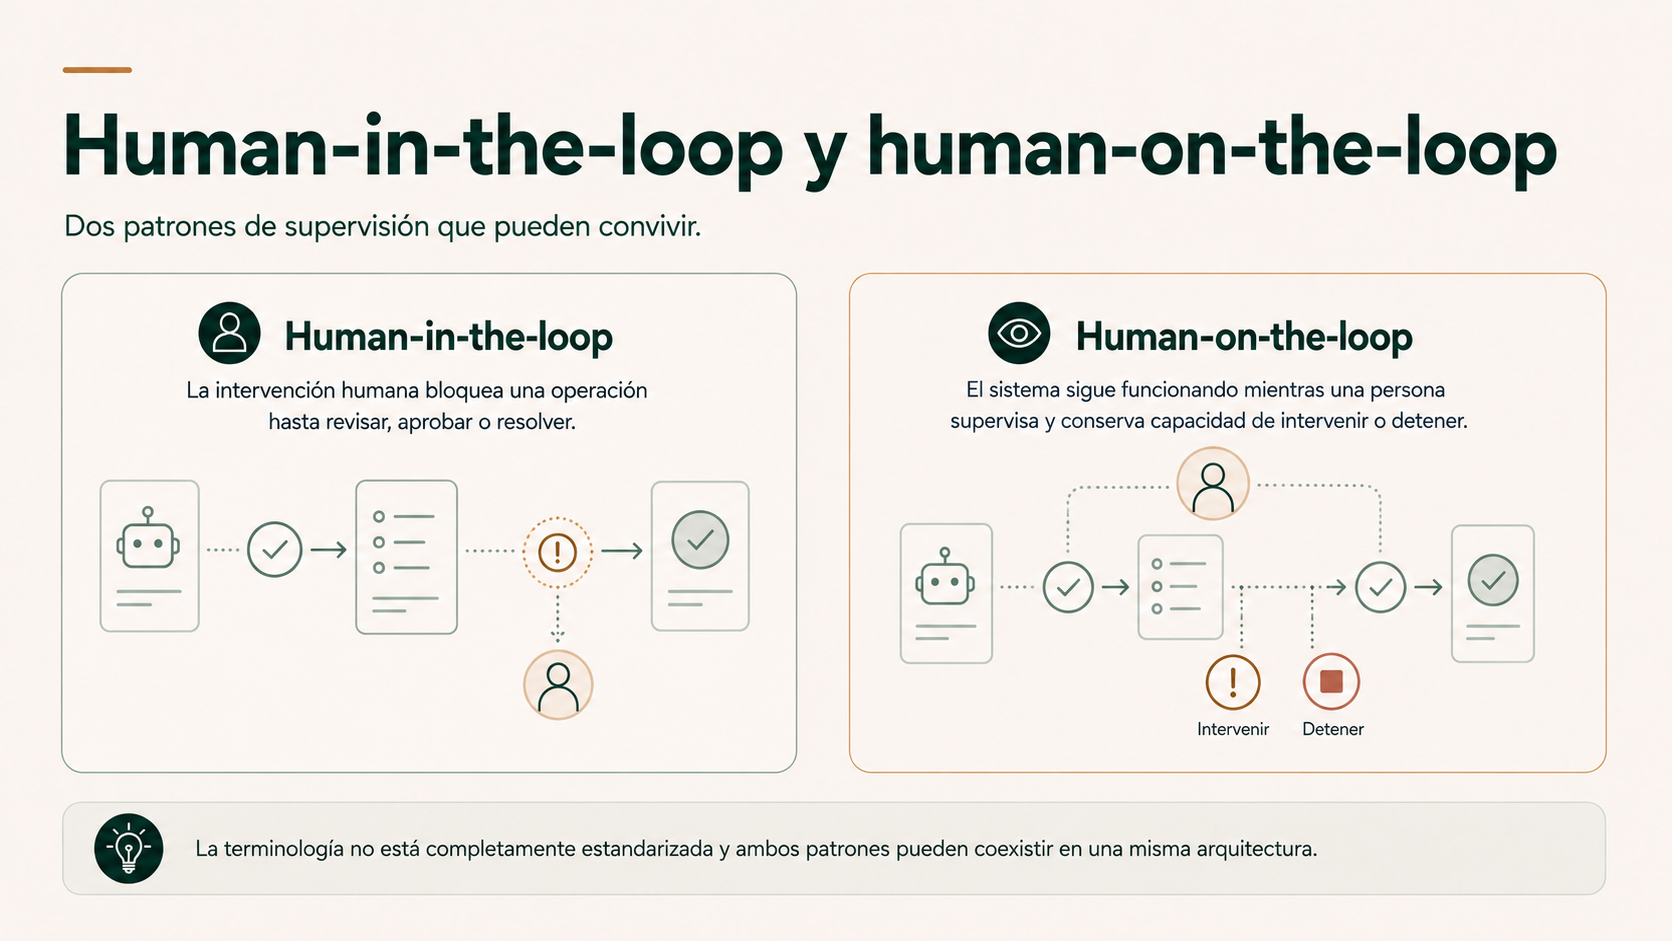
Human-in-the-loop y human-on-the-loop no describen exactamente el mismo control
En arquitectura de IA también aparece la expresión human-on-the-loop —y, con menor uniformidad terminológica, human-over-the-loop— para describir un sistema que puede seguir ejecutándose mientras una persona lo supervisa y conserva capacidad de intervenir, detener o corregir.
La distinción práctica es útil:
- Human-in-the-loop: la intervención humana forma parte del recorrido de una operación concreta. En ciertos puntos, el proceso se detiene hasta recibir una revisión, resolución o aprobación.
- Human-on-the-loop: el sistema puede continuar dentro de límites definidos mientras una persona o equipo supervisa su comportamiento y conserva mecanismos para intervenir si detecta un problema.
No son categorías cerradas ni una nomenclatura utilizada de forma idéntica por todos los proveedores. Un mismo sistema puede combinar ambas: aprobación previa para determinadas acciones y supervisión operativa continua sobre el conjunto.
La diferencia es importante porque la arquitectura workflow vs. agente responde a cuánta autonomía necesita el sistema. Aquí damos el siguiente paso: una vez concedida esa autonomía, ¿dónde debe participar una persona y para hacer exactamente qué?
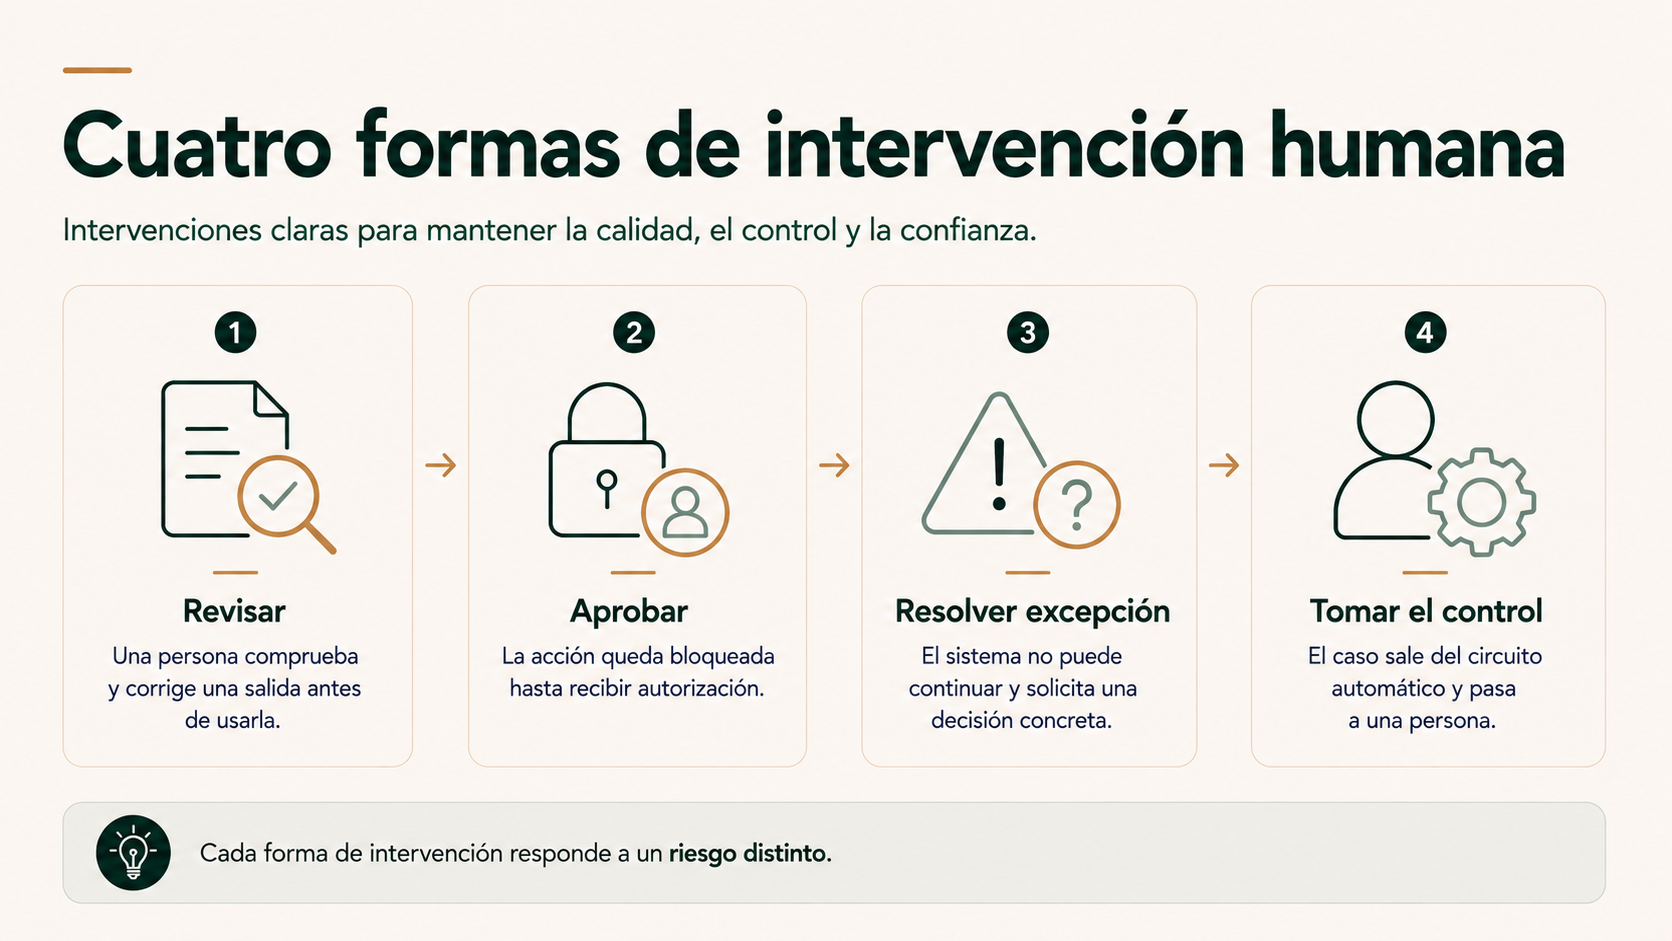
Cuatro formas de intervención humana que conviene no mezclar
En muchas conversaciones se utiliza «revisión humana» para todo. Eso oculta diferencias operativas importantes.
1. Revisar o corregir
El sistema ya ha generado una salida y una persona comprueba si puede utilizarse.
Ejemplo: validar un dato extraído de una factura o corregir una clasificación dudosa.
2. Aprobar o rechazar
La acción todavía no se ha ejecutado. El sistema se detiene hasta recibir autorización.
Ejemplo: aprobar una cancelación o una modificación sensible antes de enviarla al sistema.
3. Resolver una excepción
El camino automático no puede continuar porque falta información o existe una contradicción.
Ejemplo: decidir qué proveedor corresponde cuando aparecen dos coincidencias válidas.
4. Tomar el control
La ejecución deja de estar en manos del sistema y pasa a una persona.
Ejemplo: transferir una conversación cuando entra en un ámbito sensible o fuera de alcance.
Los cuatro mecanismos pueden convivir en un mismo proceso. Lo importante es que cada uno responda a una necesidad concreta.
Revisar una salida después de generarla no ofrece el mismo control que impedir que una acción se ejecute. Resolver una excepción tampoco es lo mismo que sustituir por completo al sistema durante el resto de la operación.
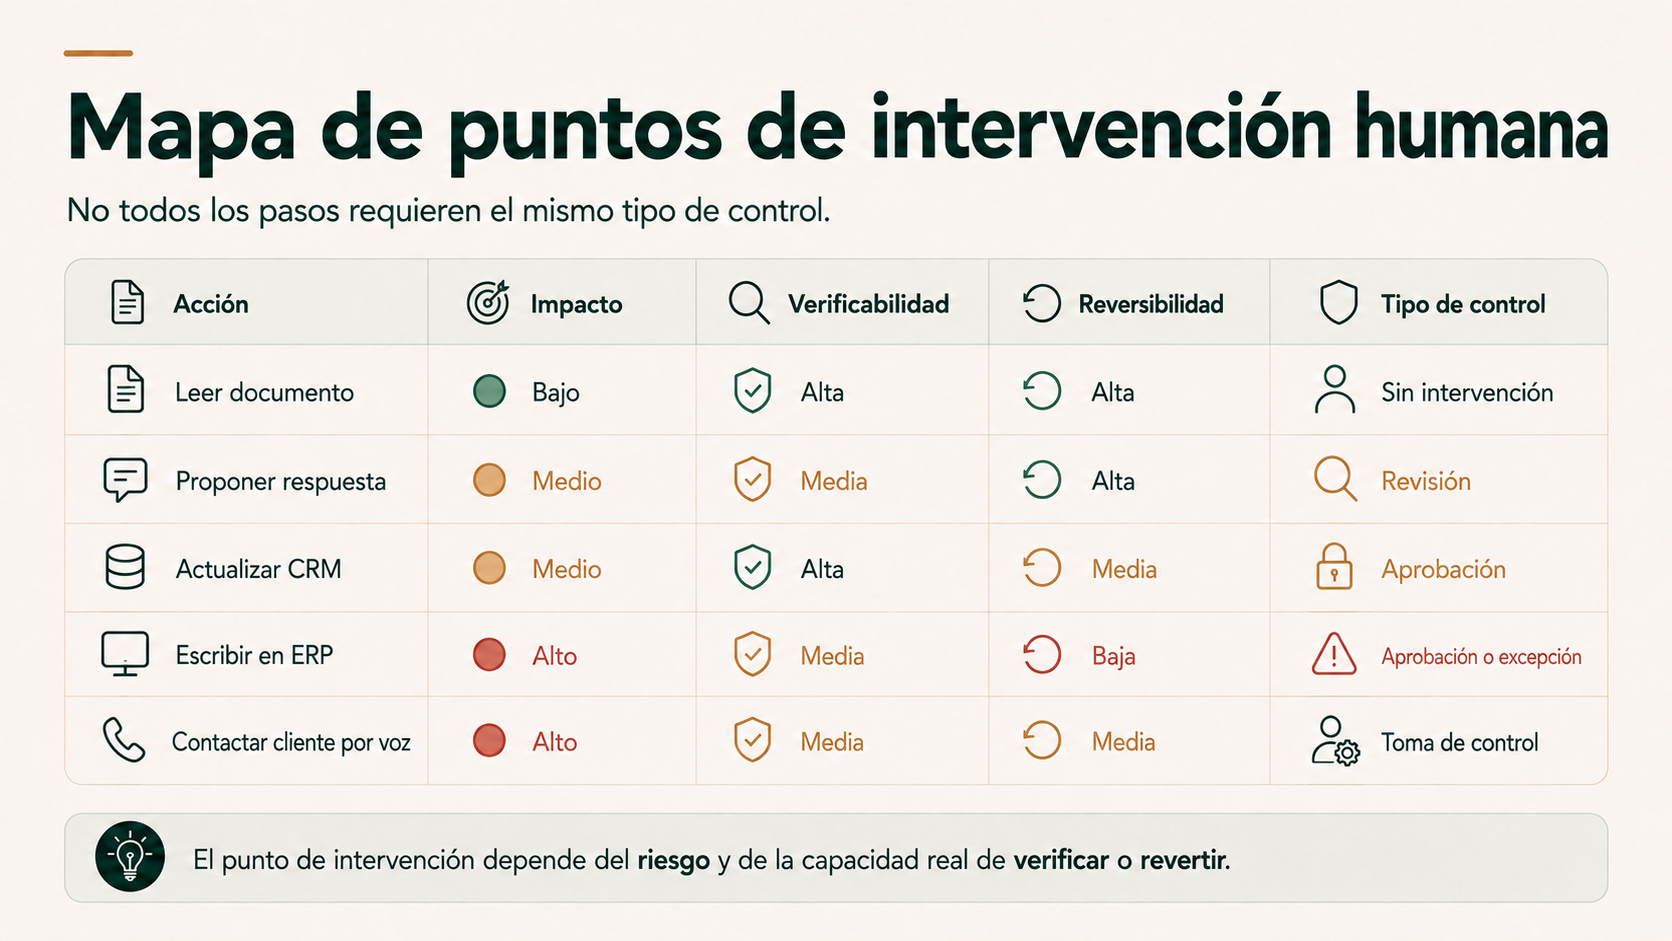
Mapa de puntos de intervención humana: decidir dónde aporta criterio una persona
En Yarvia utilizamos mapa de puntos de intervención humana como recurso de diseño. No es un estándar del sector ni una metodología normativa.
La idea es recorrer las acciones relevantes de un proceso y no preguntar simplemente «¿ponemos revisión humana?». Preguntamos qué podría ocurrir si esa acción fuese incorrecta y qué tipo de control tiene sentido.
Este mapa no devuelve una puntuación automática. Dos acciones con el mismo riesgo económico pueden necesitar controles distintos si una es fácilmente reversible y la otra no.
Alto impacto
Tiende a justificar controles más fuertes.
Baja reversibilidad
Conviene frenar antes de ejecutar.
Alta verificabilidad
Permite automatizar más con controles objetivos.
Alta ambigüedad
Aumenta el valor del criterio humano o de una escalada.
Confidence score: una señal útil que no debe decidir sola cuándo revisar
Algunos modelos o sistemas proporcionan un confidence score, que podemos traducir como puntuación o señal de confianza.
Expresa cuánto respaldo asigna el sistema a una predicción, clasificación o extracción según el mecanismo concreto que utilice el proveedor o modelo.
Lo importante es no interpretarlo como una afirmación universal del tipo: «0,92 significa que existe un 92 % de probabilidad de que este resultado sea correcto».
El significado exacto del score depende del sistema. Puede estar calibrado de manera diferente, referirse a una tarea concreta o no representar directamente el riesgo real de negocio.
Un confidence score puede ayudar a detectar casos dudosos. No sustituye una regla de riesgo.
Una predicción con confianza alta puede ser incompatible con un contrato, un dato maestro o una condición operativa. Una predicción con confianza menor puede afectar a un campo irrelevante que no justifica revisión.
Por eso no tiene sentido publicar una regla universal como «todo lo que esté por debajo del 90 % va a una persona».
El escalado puede combinar incertidumbre técnica + importancia del dato + reglas de negocio + contradicciones + impacto de la acción.
Este enfoque ya aparece aplicado a documentos en la automatización documental con IA, pero en HITL lo generalizamos a cualquier proceso.
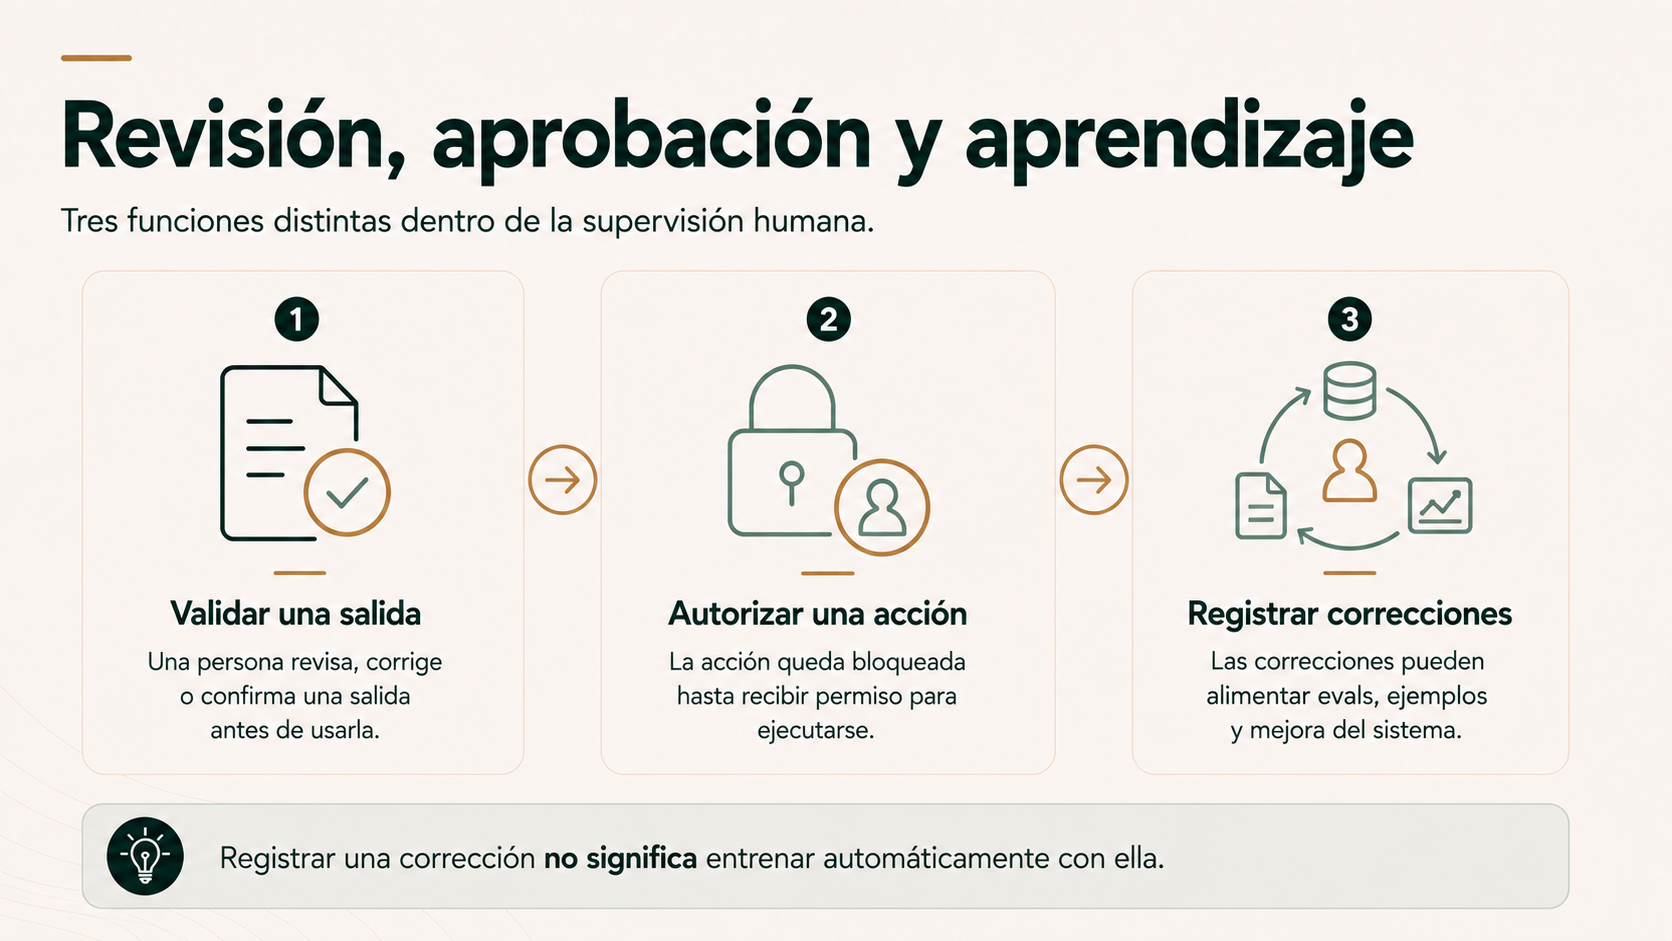
Revisar una salida y aprobar una acción son controles distintos
Revisión: comprobar algo que el sistema ya produjo
La revisión encaja cuando necesitamos validar una salida antes de utilizarla o incorporarla a otro sistema.
Por ejemplo, la IA extrae un número de factura y una persona lo compara con el documento original. O clasifica un caso como reclamación contractual y un responsable corrige la categoría.
Para que la revisión sea real, la persona necesita evidencia suficiente. Mostrar únicamente el dato propuesto y dos botones puede obligarla a decidir a ciegas.
Aprobación previa: impedir que la acción ocurra hasta recibir autorización
En una aprobación, el riesgo no está únicamente en la calidad del texto o de la predicción. Está en que la acción produzca efectos.
Una compra, una cancelación, un reembolso fuera de política o una modificación contractual pueden configurarse para que el sistema prepare la operación pero no la ejecute hasta que una persona autorice.
Este patrón existe técnicamente en herramientas actuales. OpenAI Agents SDK, por ejemplo, permite marcar determinadas llamadas a herramientas como sujetas a aprobación: la ejecución se pausa, la persona aprueba o rechaza y después puede reanudarse desde el estado conservado.
Eso no significa que toda herramienta deba pedir aprobación siempre. Una misma función puede requerirla solo bajo determinadas condiciones de riesgo.
La corrección humana también puede mejorar el sistema, si se registra bien
Cuando una persona corrige una clasificación, resuelve una excepción o rechaza una propuesta, esa decisión puede tener un segundo valor además de resolver el caso actual: crear evidencia para la evaluación de agentes de IA y mejorar el sistema.
Conviene guardar de forma estructurada, cuando sea apropiado, qué propuso el sistema, qué decidió la persona, cuál fue el resultado correcto y por qué se produjo la diferencia.
Esos ejemplos pueden alimentar evals —conjuntos de pruebas para medir si una versión del sistema funciona mejor o peor—, convertirse en ejemplos de referencia para el prompt, revelar nuevas reglas de negocio o ayudar a construir un dataset para un ajuste posterior del modelo.
El fine-tuning o ajuste fino consiste en entrenar adicionalmente un modelo con ejemplos específicos para modificar su comportamiento en una tarea determinada. No es el destino automático de toda corrección humana: muchas mejoras se resuelven antes corrigiendo instrucciones, reglas, herramientas, datos o evaluaciones.
Regla práctica: guardar la corrección no significa entrenar automáticamente con ella. Primero debe convertirse en un ejemplo fiable, correctamente etiquetado y adecuado para la finalidad de evaluación o mejora.
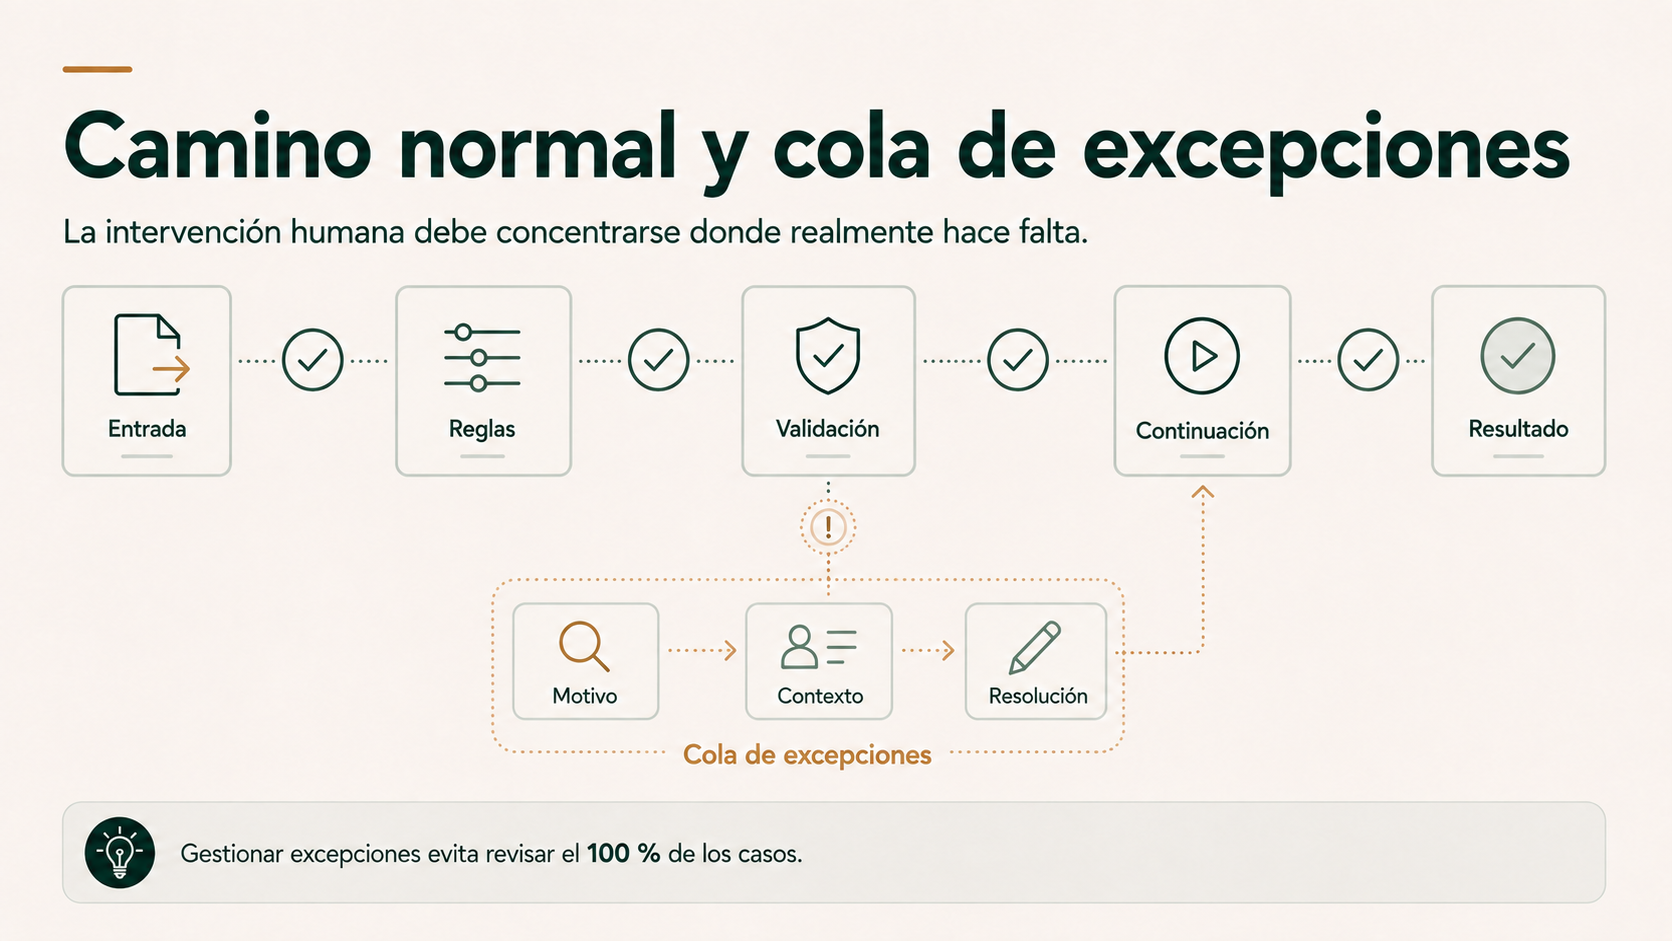
El patrón más útil suele ser automatizar el camino normal y enviar a personas las excepciones
Revisar el 100 % de los casos puede eliminar gran parte del valor de la automatización.
En muchos procesos es más útil definir qué significa un caso suficientemente controlado para continuar y derivar únicamente aquello que se sale de esas condiciones.
Caso normal. Datos completos, reglas satisfechas y resultado verificable → continuar automáticamente.
Excepción. Aparece una contradicción, falta información o una regla no puede resolverse → pausar y derivar.
Intervención. La persona recibe motivo, contexto y decisión esperada.
Resolución. Corrige, aprueba, rechaza o completa.
Continuación. El proceso reanuda desde el punto adecuado sin empezar de cero.
Una buena cola de excepciones no debería limitarse a mostrar «Revisar caso 3487».
Debería explicar, por ejemplo: «Dos proveedores coinciden con el NIF parcial. Selecciona la entidad correcta antes de crear el borrador».
El humano aporta criterio exactamente donde el sistema reconoce que no debe cerrar el caso solo.
Automation bias: cuando la persona confía demasiado en la propuesta automática
Automation bias puede traducirse como sesgo de automatización: la tendencia a confiar demasiado en una recomendación o salida porque procede de un sistema automático.
Es relevante porque añadir una persona no elimina automáticamente los errores de la IA.
Si la interfaz destaca «Aprobar recomendación» como opción principal, oculta la evidencia y exige varios pasos para rechazar, estamos condicionando la decisión.
También puede ocurrir que el equipo lleve meses viendo resultados correctos y empiece a aceptar por costumbre, justo hasta que aparece un caso diferente.
El artículo 14 del AI Act menciona expresamente, para los sistemas de alto riesgo a los que aplica, la necesidad de que quienes realizan supervisión permanezcan atentos a la tendencia a confiar automáticamente o en exceso en la salida del sistema.
Diseñar supervisión también significa diseñar la interfaz de decisión: qué evidencia se enseña, qué alternativas existen, qué explica el motivo de escalado y cómo puede la persona rechazar o corregir.
Contexto, competencia y autoridad: tres condiciones para que el humano pueda supervisar de verdad
No basta con asignar la revisión a «alguien del equipo».
Contexto suficiente
La persona necesita entender qué ha ocurrido y qué se espera de ella.
Puede necesitar la solicitud original, la salida de la IA, la fuente consultada, la regla que falló, la acción propuesta y las consecuencias de aprobarla.
El reto no consiste en mostrar todo el log técnico. Consiste en mostrar la información mínima necesaria para tomar una decisión informada.
El contenido externo también puede intentar manipular al modelo o al supervisor
Si un agente procesa emails, documentos o páginas externas, ese contenido puede contener instrucciones maliciosas. Cuando intentan que el modelo ignore sus reglas o utilice herramientas de forma indebida hablamos de indirect prompt injection, o inyección indirecta de instrucciones.
Si ese mismo contenido termina visible en la interfaz y trata de convencer a la persona para que apruebe, revele información o realice una acción, el problema se acerca más a la ingeniería social.
La interfaz de supervisión debe distinguir claramente entre datos no confiables que el sistema está mostrando e instrucciones legítimas de la aplicación. Resumir contenido externo no lo convierte automáticamente en contenido confiable.
Competencia
Quien revisa tiene que entender el tipo de decisión.
Un administrativo puede resolver qué cliente corresponde a un documento si ese es su ámbito. No debería decidir una cuestión clínica, jurídica o técnica especializada únicamente porque el sistema haya creado una tarea.
Autoridad real
El supervisor debe poder hacer algo con la información.
Rechazar. Corregir. Bloquear. Pedir más datos. Cambiar la ruta. Detener la ejecución.
En los sistemas de alto riesgo regulados, el AI Act insiste precisamente en que las personas encargadas de supervisión puedan comprender limitaciones, interpretar resultados y decidir no utilizar, ignorar o revertir una salida cuando corresponda.
La persona no siempre responde al instante: diseñar espera, caducidad y reasignación
Un proceso human-in-the-loop puede quedarse pausado durante segundos, horas o días.
Por eso el diseño debe responder también a una pregunta muy poco espectacular pero fundamental: ¿qué ocurre mientras esperamos?
- Pausa: ¿la ejecución queda completamente detenida o puede continuar por otras ramas?
- Estado: ¿se conserva el contexto necesario para reanudar después?
- Caducidad: ¿la aprobación sigue siendo válida dentro de dos días si los datos han cambiado?
- Reasignación: ¿qué ocurre si el responsable está ausente?
- Escalado: ¿a quién pasa el caso cuando se acerca un plazo crítico?
- Cancelación: ¿qué ocurre si el contexto deja de ser válido mientras esperamos?
No existe un SLA universal de aprobación. Un SLA —Service Level Agreement u objetivo/compromiso de nivel de servicio— puede definir cuánto tiempo debería tardar determinada intervención, pero el plazo razonable depende del proceso.
Una llamada en curso no puede esperar dos horas. Una revisión contractual quizá sí pueda permanecer en cola hasta el siguiente turno.
La tecnología puede ayudar a conservar el estado. OpenAI Agents SDK, por ejemplo, documenta ejecuciones pausables y serializables para aprobaciones de larga duración. El principio es más general: una espera humana debe formar parte de la arquitectura, no ser un agujero negro fuera del workflow.
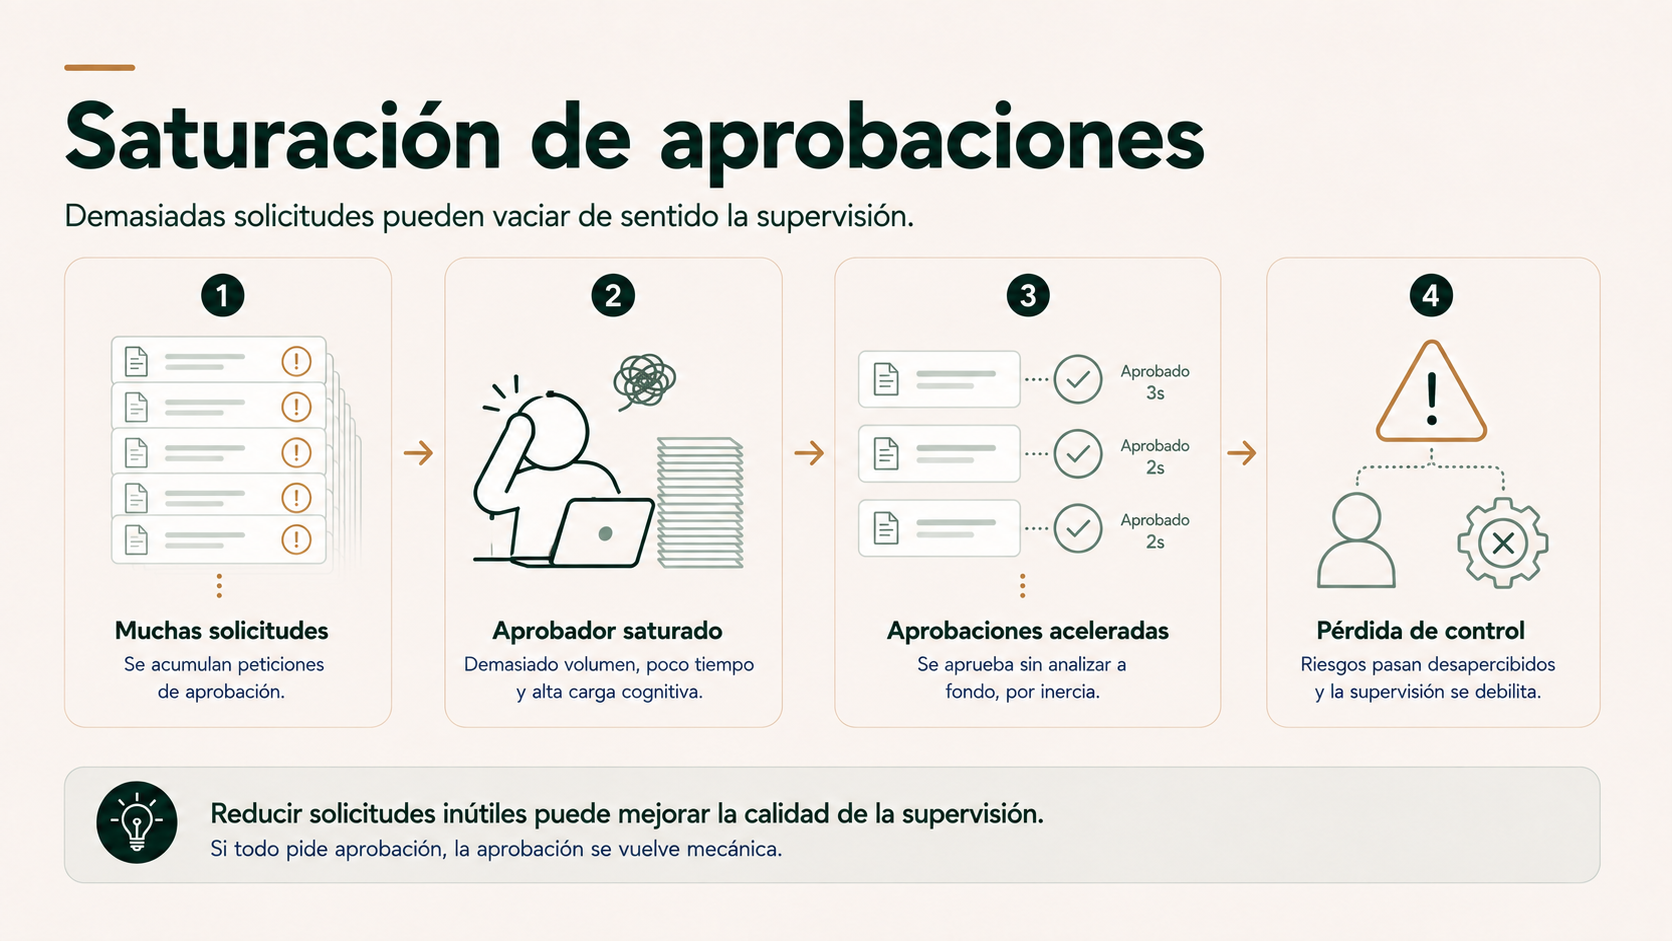
Saturación de aprobaciones: cuando el control termina convertido en un clic rutinario
El término técnico habitual es fatiga de aprobación o approval fatigue. En lenguaje más natural, podemos hablar de saturación de aprobaciones o aprobación por inercia.
Ocurre cuando una persona recibe tantas solicitudes parecidas que deja de analizarlas con la atención que justificó introducir el control.
La señal más clara no es un número concreto de aprobaciones al día. Es el comportamiento.
Si prácticamente todo se aprueba, nadie consulta la evidencia, las colas crecen y el equipo percibe el paso como burocracia, hay que revisar la arquitectura.
Un control que nunca cambia ninguna decisión puede estar mal situado.
Quizá esas operaciones podrían resolverse mediante reglas claras y reservar la intervención humana para casos realmente excepcionales.
El objetivo no es eliminar controles para ganar velocidad. Es evitar controles que consumen atención sin reducir de forma significativa el riesgo.
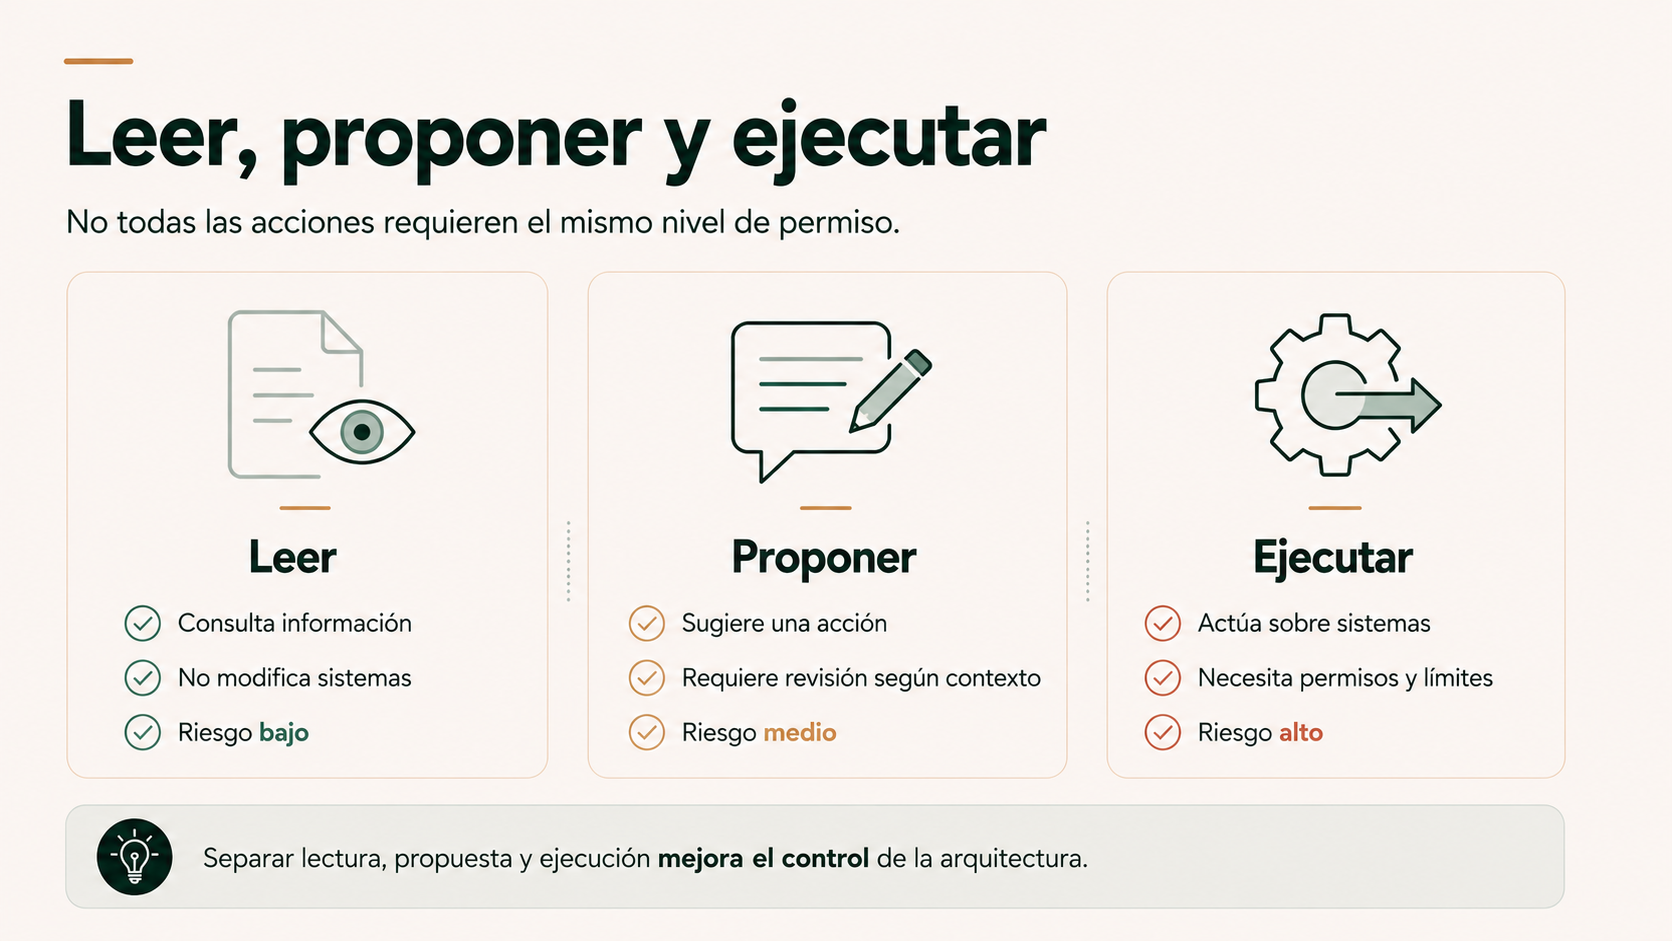
Leer, proponer y ejecutar: tres niveles que no deberían tener siempre los mismos permisos
La entrada anterior ya introdujo esta separación. En human-in-the-loop resulta especialmente útil porque permite situar el control justo antes de la acción que realmente importa.
Leer
Consultar CRM, documentos, historial, inventario o estados.
Puede tener riesgo de acceso y privacidad, pero no modifica todavía el sistema.
Proponer
Preparar una respuesta, recomendación, clasificación o acción futura.
Permite utilizar capacidad de IA sin ejecutar automáticamente la consecuencia.
Ejecutar
Modificar un registro, enviar una comunicación, cancelar, pagar, borrar o crear una operación.
Es donde reversibilidad, permisos y credenciales y aprobación cobran más peso.
Verificar
Comprobar que la acción realmente terminó como se esperaba.
Evita confundir “solicitud enviada” con “operación completada”.
Un agente puede disponer de libertad para leer varias fuentes y preparar una recomendación, pero necesitar aprobación para la escritura definitiva.
Eso permite conservar la ventaja de la investigación automática sin conceder al mismo componente todos los permisos.
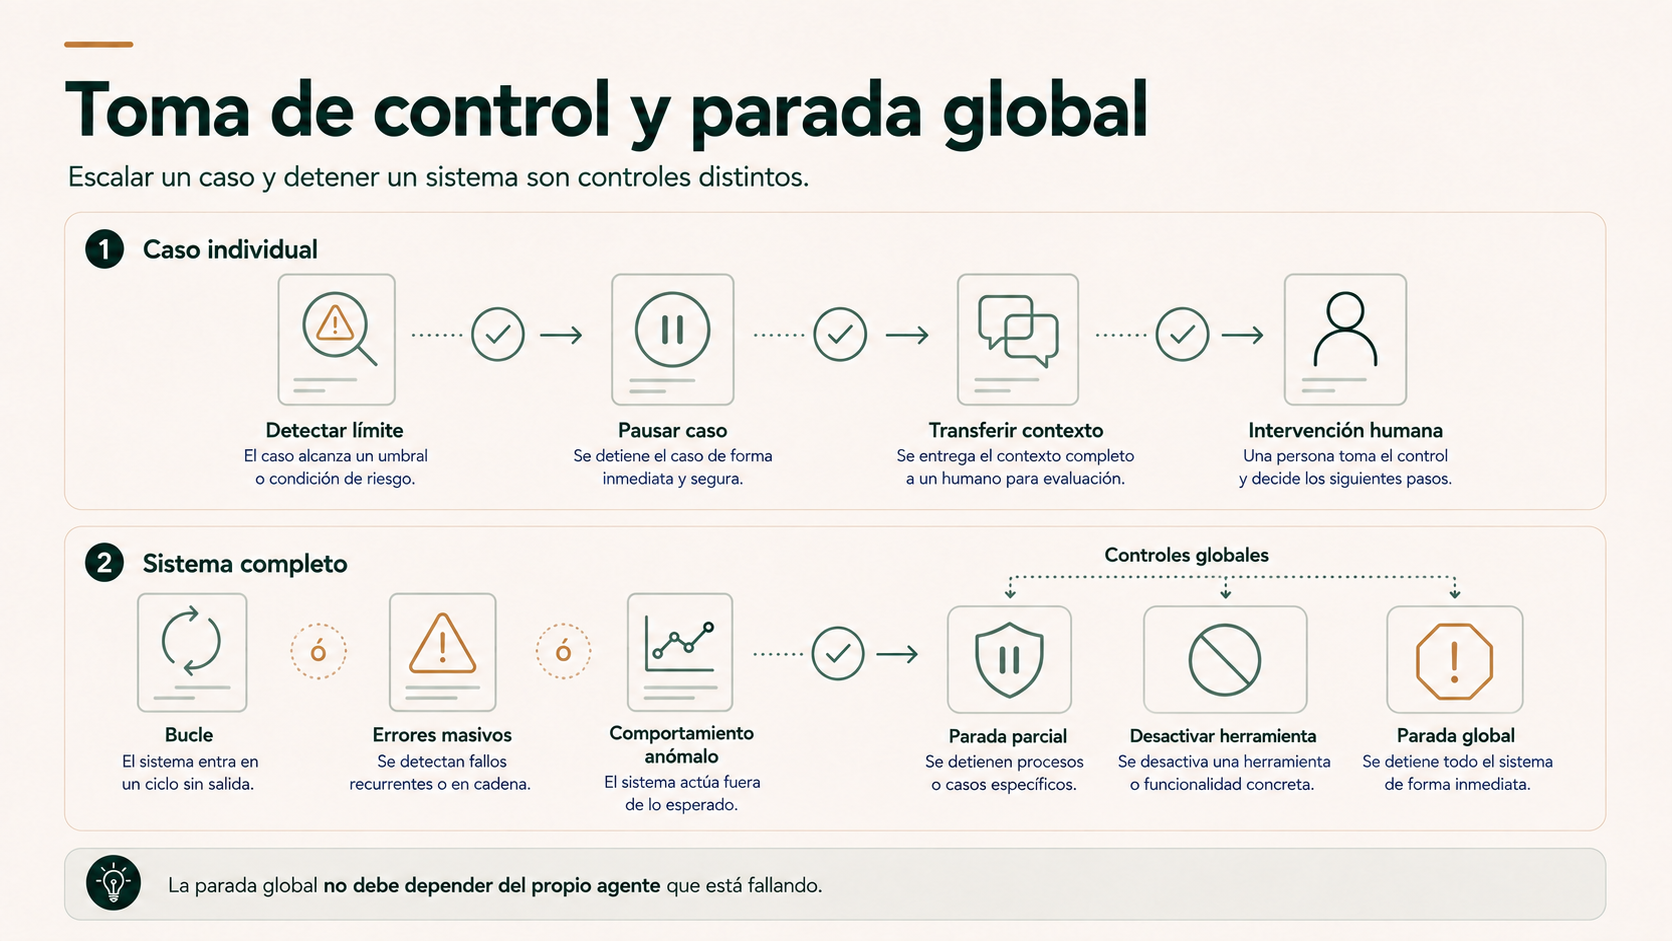
Toma de control: cuando una persona debe continuar el proceso
Hay situaciones donde no basta con aprobar una acción puntual.
El sistema debe dejar de actuar y transferir el caso.
Podemos llamarlo toma de control; en documentación técnica también aparece como takeover o handoff cuando se produce una transferencia.
Puede ocurrir porque el caso está fuera del alcance definido, porque existe un riesgo nuevo, porque las herramientas fallan repetidamente o porque la responsabilidad requiere intervención profesional.
Detectar límite. La automatización identifica una condición que no debe resolver sola.
Pausar. Evita seguir ejecutando acciones.
Transferir contexto. Resume qué ocurrió, qué se intentó y qué información existe.
Intervención humana. La persona continúa, corrige o cierra.
Reanudar o finalizar. El sistema recupera el estado solo cuando corresponde.
La transferencia de contexto es especialmente importante. En atención telefónica o chat, pedir al usuario que repita toda la historia después de una escalada reduce mucho la calidad del proceso. Las guías sobre agentes de voz para empresas profundizan en esa arquitectura aplicada a llamadas.
Parada global de emergencia: cuando el problema ya no es un caso individual
La toma de control caso a caso no cubre todos los escenarios. También conviene diseñar qué ocurre si el problema afecta al sistema completo: un agente entra en un bucle, una integración empieza a producir errores en cadena, aparecen cientos de aprobaciones inesperadas o una herramienta externa devuelve resultados anómalos.
En esos casos puede ser necesario un mecanismo de parada global —a veces llamado kill-switch— capaz de pausar una automatización, deshabilitar temporalmente una herramienta, impedir escrituras o detener un conjunto de agentes hasta revisar la causa.
Este control no debería depender del propio agente que está fallando. Debe existir fuera de su circuito normal de decisión y quedar accesible para responsables operativos con la autoridad adecuada.
En sistemas complejos, también puede ser más seguro aplicar una parada parcial: desactivar solo las acciones de escritura mientras se mantienen consultas de lectura, bloquear una integración concreta o reducir temporalmente el alcance de herramientas.
Cuatro ejemplos donde cambia el papel de la persona
Documento y ERP
La IA extrae datos de una factura. Si proveedor, pedido, suma y reglas coinciden, el flujo puede continuar automáticamente.
Si aparecen dos proveedores posibles, una persona resuelve la entidad.
Y si la operación posterior tiene consecuencias económicas específicas, puede existir un control adicional antes de registrarla o pagarla.
La revisión humana no está en «leer la factura». Está en los puntos donde el sistema no puede verificar de forma suficiente qué debe hacer.
Atención al cliente
Las consultas rutinarias pueden resolverse con información verificada.
Una solicitud fuera de política puede abrir una excepción. Un reembolso por encima de determinados límites puede necesitar aprobación. Una conversación sensible puede transferirse por completo a una persona.
Tenemos tres patrones humanos diferentes dentro del mismo servicio.
Agente de investigación
El agente consulta CRM, contratos y documentación para preparar una recomendación.
Puede investigar con herramientas de lectura sin pedir autorización en cada consulta. La intervención aparece cuando la recomendación afecta a una decisión relevante o cuando la acción propuesta tiene efectos que el agente no debe ejecutar solo.
Así evitamos poner un humano en cada llamada a herramienta y lo situamos donde realmente existe una decisión.
Voz y transferencia
Un agente atiende una petición administrativa. Detecta que el usuario introduce una cuestión fuera del ámbito permitido.
En lugar de improvisar, transfiere la llamada con contexto a un profesional adecuado.
La supervisión no consiste en escuchar todas las llamadas en tiempo real, sino en disponer de criterios y mecanismos de transferencia cuando la situación lo exige.
Ejemplo práctico recurrente: email, CRM y ERP
Imaginemos una empresa B2B ficticia donde llegan solicitudes por email y un agente consulta CRM y documentación antes de proponer acciones sobre ERP.
Los casos normales cumplen reglas y continúan.
Una solicitud llega con un identificador incompleto y dos clientes posibles. El proceso crea una excepción con las dos coincidencias, el mensaje original y la decisión requerida. Una persona selecciona el cliente correcto.
Después, el agente consulta el contrato y propone modificar una condición comercial. Como la modificación produce efectos relevantes, el sistema no la ejecuta: solicita aprobación previa.
El responsable rechaza la propuesta y aporta un motivo. La ejecución se reanuda con una alternativa.
En otro caso, el sistema detecta información contradictoria y no dispone de evidencia suficiente para seguir. Se pausa y pasa a operación manual.
La misma solución contiene automatización completa, excepción, aprobación y toma de control. HITL no es una capa única; es un diseño distribuido por el proceso.
AI Act y NIST AI RMF: dos referencias distintas que no conviene mezclar
AI Act: supervisión humana en sistemas de alto riesgo
El Reglamento europeo de IA —AI Act— contiene obligaciones específicas de supervisión humana para determinados sistemas de IA de alto riesgo.
Su artículo 14 exige que esos sistemas puedan ser supervisados de forma efectiva por personas durante su uso y que las medidas sean proporcionales al riesgo, nivel de autonomía y contexto.
También contempla que las personas encargadas puedan comprender capacidades y limitaciones, detectar anomalías, interpretar correctamente salidas, decidir no utilizar o revertir resultados e interrumpir el sistema cuando corresponda.
Esto no significa que cualquier chatbot, automatización o uso empresarial de IA esté obligado por ese artículo a tener una persona aprobando cada operación.
Además, el calendario de las reglas de alto riesgo está actualmente en transición. A 10 de agosto de 2026, la Comisión Europea informa de la extensión de su aplicación a diciembre de 2027 para determinados sistemas independientes de alto riesgo y a agosto de 2028 para IA integrada en productos, tras el acuerdo político sobre el AI Omnibus. Este calendario debe volver a verificarse cuando se evalúe un caso real.
NIST AI RMF: un marco voluntario para gestionar riesgos de IA
NIST AI RMF significa Artificial Intelligence Risk Management Framework, o Marco de Gestión de Riesgos de Inteligencia Artificial, desarrollado por el National Institute of Standards and Technology de Estados Unidos.
No es una ley ni una obligación regulatoria general.
Es un marco voluntario para que organizaciones que diseñan, desarrollan, despliegan o utilizan IA puedan gobernar, mapear, medir y gestionar riesgos.
Entre otras cuestiones, el AI RMF propone definir y diferenciar responsabilidades en configuraciones humano-IA y documentar procesos de supervisión humana.
Su utilidad para esta pieza es metodológica: refuerza que HITL necesita roles, responsabilidades, procedimientos y evaluación; no basta con añadir una intervención informal.
Regulación y arquitectura no son lo mismo. El AI Act determina obligaciones dentro de su ámbito. NIST ofrece un marco voluntario. Yarvia utiliza además criterios operativos para diseñar controles adecuados al proceso concreto.
Qué medir para saber si la supervisión humana funciona
El porcentaje de tareas automatizadas no basta.
Un sistema puede automatizar menos y funcionar mejor porque las intervenciones están mejor situadas. O automatizar mucho y generar una cola inmanejable de excepciones.
| Métrica | Qué ayuda a detectar | Qué pregunta abre |
|---|---|---|
| Tasa de revisión | Cuántos casos necesitan comprobación humana. | ¿Estamos revisando demasiado o demasiado poco? |
| Aprobaciones y rechazos | Si el control cambia decisiones. | ¿Una aprobación casi siempre aceptada podría convertirse en regla? |
| Tiempo de excepción | Cuánto bloquean los casos anómalos. | ¿La cola tiene responsable y prioridad? |
| Errores detectados por humanos | Valor real de la revisión. | ¿En qué tipo de caso aporta más? |
| Errores tras revisión | Limitaciones del propio control humano. | ¿Falta contexto, formación o mejor interfaz? |
| Caducidades y reasignaciones | Fallos operativos en las esperas. | ¿Qué ocurre cuando nadie responde? |
| Tomas de control | Cuándo el sistema sale de su alcance. | ¿Son límites esperados o fallos de diseño? |
| Aprobaciones repetitivas | Posible saturación o burocracia. | ¿Podemos convertir casos estables en reglas? |
La métrica más interesante puede ser incluso qué porcentaje de intervenciones modifica realmente la salida o la acción propuesta. No para eliminar automáticamente las demás, sino para localizar controles que quizá ya no están aportando el valor esperado.
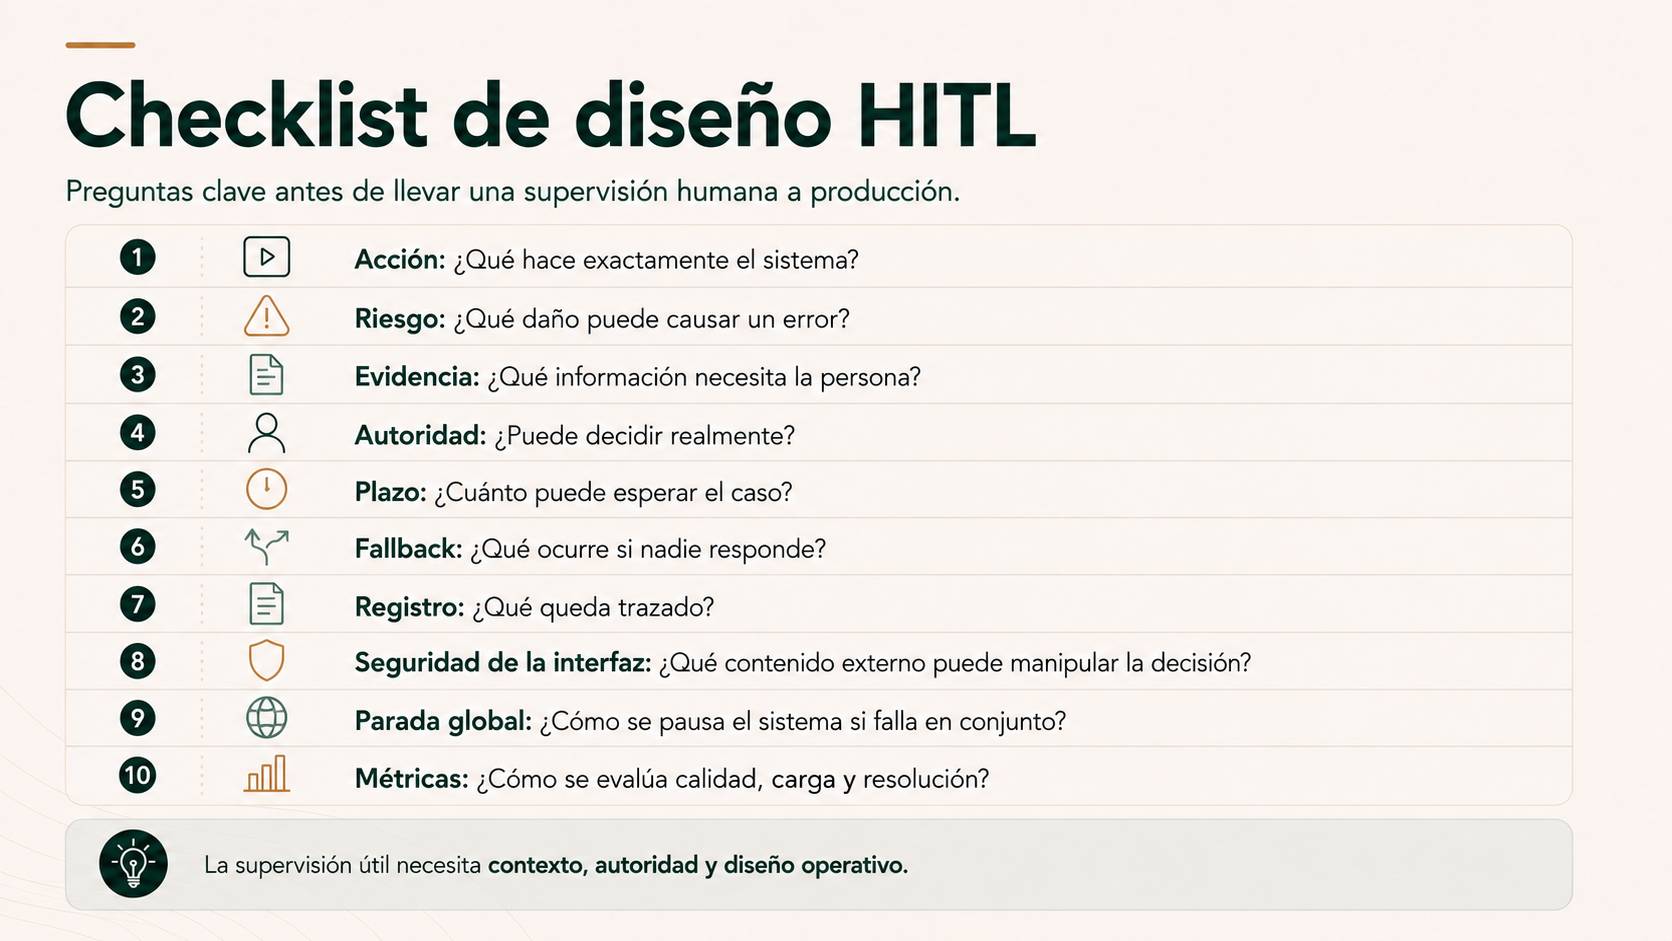
Señales de que el human-in-the-loop está mal diseñado
- Una persona revisa el 100 % de los casos aunque casi todos sean triviales.
- El sistema no explica por qué ha escalado un caso.
- El supervisor no puede consultar la fuente o la evidencia relevante.
- Solo existe el botón de aprobar, pero corregir o rechazar resulta difícil.
- La persona no tiene autoridad real para detener la acción.
- No existe una ruta cuando la aprobación caduca o nadie responde.
- Las excepciones obligan a empezar manualmente desde cero.
- Una herramienta pide aprobación siempre aunque existan escenarios claramente seguros.
- El equipo empieza a aprobar en bloque o por costumbre.
- La supervisión se añadió al final del proyecto únicamente para poder decir que “hay un humano”.
También existe el error contrario: eliminar intervención humana porque «el modelo funciona bien» sin analizar qué ocurre cuando aparece un caso de alto impacto, una contradicción o una acción difícil de revertir.
La supervisión no se diseña desde una posición ideológica a favor o en contra de la autonomía. Se diseña desde el proceso.
El humano debe estar donde puede cambiar el resultado, no donde simplemente añade un clic
Human-in-the-loop es útil precisamente porque no obliga a elegir entre dos extremos: automatizarlo todo o revisar todo manualmente.
Podemos dejar que un sistema procese casos normales, utilice IA para interpretar información y opere con herramientas, mientras reservamos determinados puntos para criterio humano.
Pero esos puntos tienen que estar diseñados.
Qué revisa la persona. Qué evidencia recibe. Qué puede modificar. Qué acción permanece bloqueada. Cuánto tiempo puede esperar el proceso. Qué ocurre si nadie responde. Y cómo vuelve la decisión al flujo.
Cuando estas preguntas no tienen respuesta, «poner un humano» suele significar trasladar la incertidumbre a una bandeja de tareas.
Cuando sí la tienen, la intervención humana se convierte en una parte real de la arquitectura.
Una supervisión útil no se mide por cuántas veces interviene una persona. Se mide por si interviene con información y autoridad justo donde su criterio importa.
¿Tu automatización necesita revisión, aprobación, excepciones o toma de control?
Podemos mapear acciones, riesgo, reversibilidad, verificabilidad, permisos y responsabilidades para diseñar los puntos de intervención humana sin convertir todo el proceso en una revisión manual.
Diseñar los puntos de intervenciónFuentes
- EUR-Lex — Reglamento (UE) 2024/1689, artículo 14: supervisión humana.
Fuente jurídica primaria sobre supervisión humana de sistemas de IA de alto riesgo, proporcionalidad al riesgo y autonomía, capacidad de interpretación, intervención y prevención de confianza excesiva en las salidas.
Consultar fuente - Comisión Europea — AI Act: aplicación y calendario.
Referencia oficial para el calendario de aplicación del Reglamento y los cambios comunicados en 2026 para determinadas reglas de sistemas de alto riesgo.
Consultar fuente - NIST — Artificial Intelligence Risk Management Framework (AI RMF).
Marco voluntario para gobernar, mapear, medir y gestionar riesgos de IA. Incluye definición de roles en configuraciones humano-IA y procesos de supervisión definidos, evaluados y documentados.
Consultar fuente - NIST AI RMF Playbook — Govern y Map.
Orientaciones voluntarias sobre responsabilidades, formación, supervisión y evaluación de configuraciones humano-IA.
Consultar fuente - OpenAI Agents SDK — Human-in-the-loop.
Ejemplo técnico de aprobación humana sobre llamadas sensibles a herramientas mediante pausa, aprobación/rechazo y reanudación de la ejecución.
Consultar fuente - OpenAI Agents SDK — Tracing.
Referencia técnica sobre trazabilidad de ejecuciones, llamadas a herramientas, handoffs y guardrails, útil para distinguir observabilidad de intervención humana.
Consultar fuente - OpenAI Agents SDK — Guardrails.
Referencia técnica para distinguir controles automáticos de validación y bloqueo de la aprobación humana.
Consultar fuente - Anthropic — Demystifying evals for AI agents.
Referencia técnica sobre evaluaciones de agentes y uso sistemático de casos para medir comportamientos y detectar regresiones antes de producción.
Consultar fuente - Anthropic — How we contain Claude across products.
Referencia sobre los límites de supervisión basada en aprobaciones, saturación de prompts de permiso y controles de contención para limitar el alcance de acciones autónomas.
Consultar fuente
La necesidad y forma de supervisión humana depende del sistema, su finalidad, riesgo, contexto y marco jurídico aplicable. Este artículo explica criterios de arquitectura y no sustituye asesoramiento jurídico o de cumplimiento.
