
RAG · BÚSQUEDA DOCUMENTAL · APIs · AUTOMATIZACIÓN · IA
RAG en empresas: cuándo necesitas búsqueda documental y cuándo basta con reglas, APIs o un workflow
RAG puede ser una arquitectura muy útil para trabajar con conocimiento empresarial. También puede ser una capa innecesaria cuando la respuesta ya existe como regla, vive como dato actual en un CRM o ERP, o está en un conjunto pequeño de documentos que el sistema puede consultar directamente.
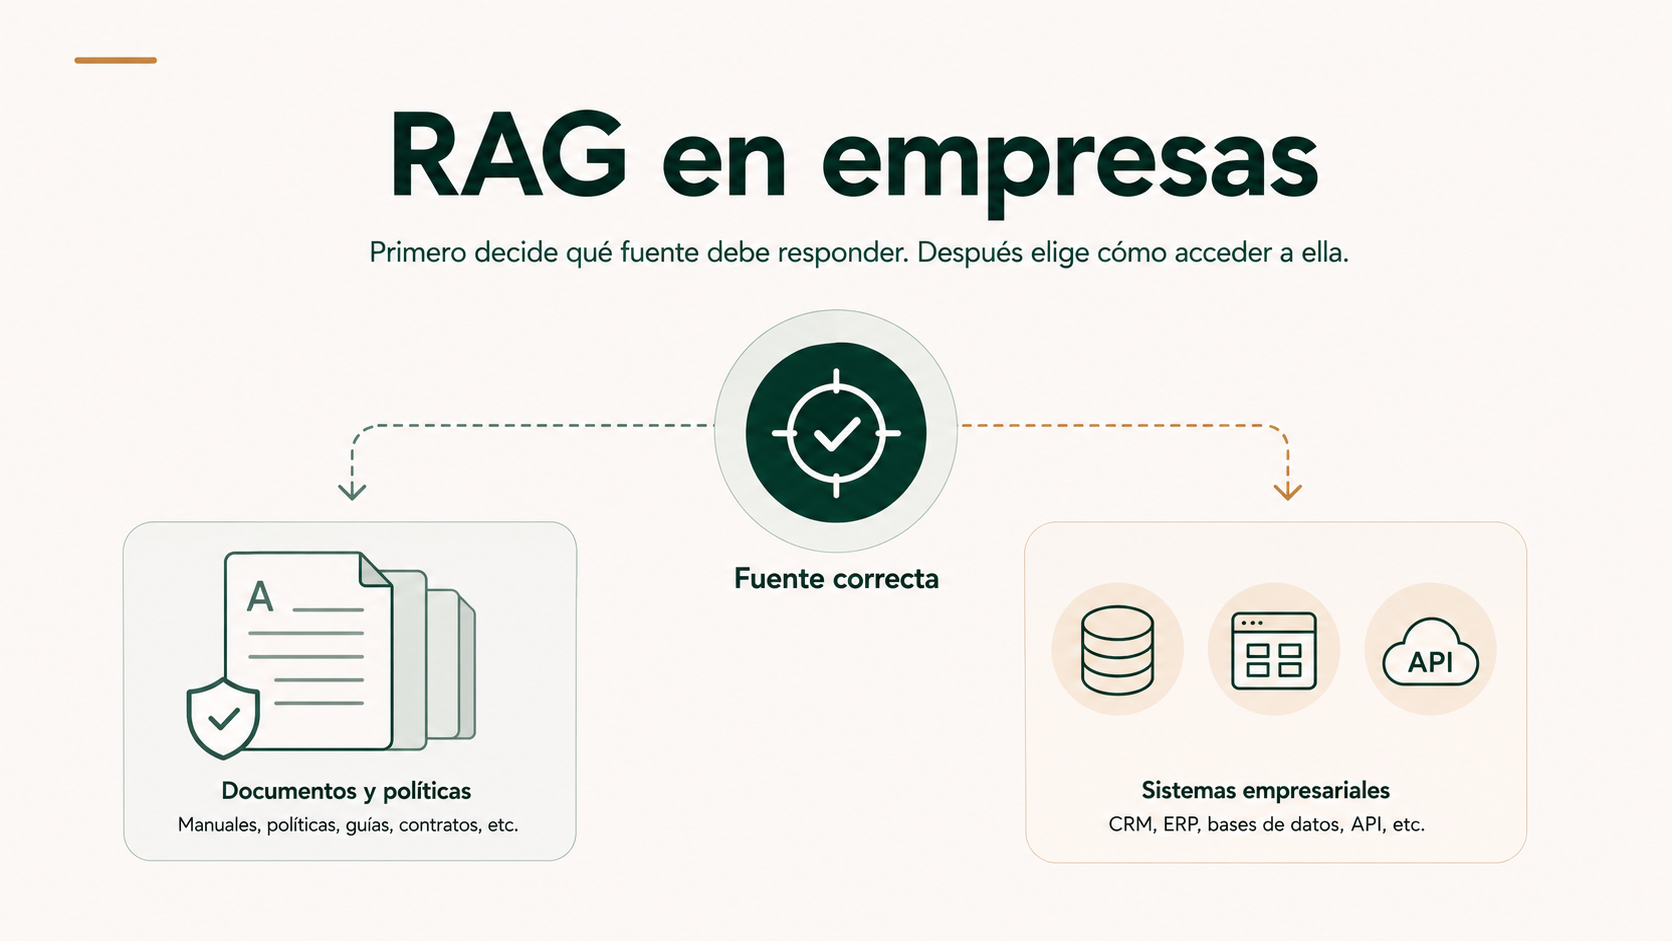
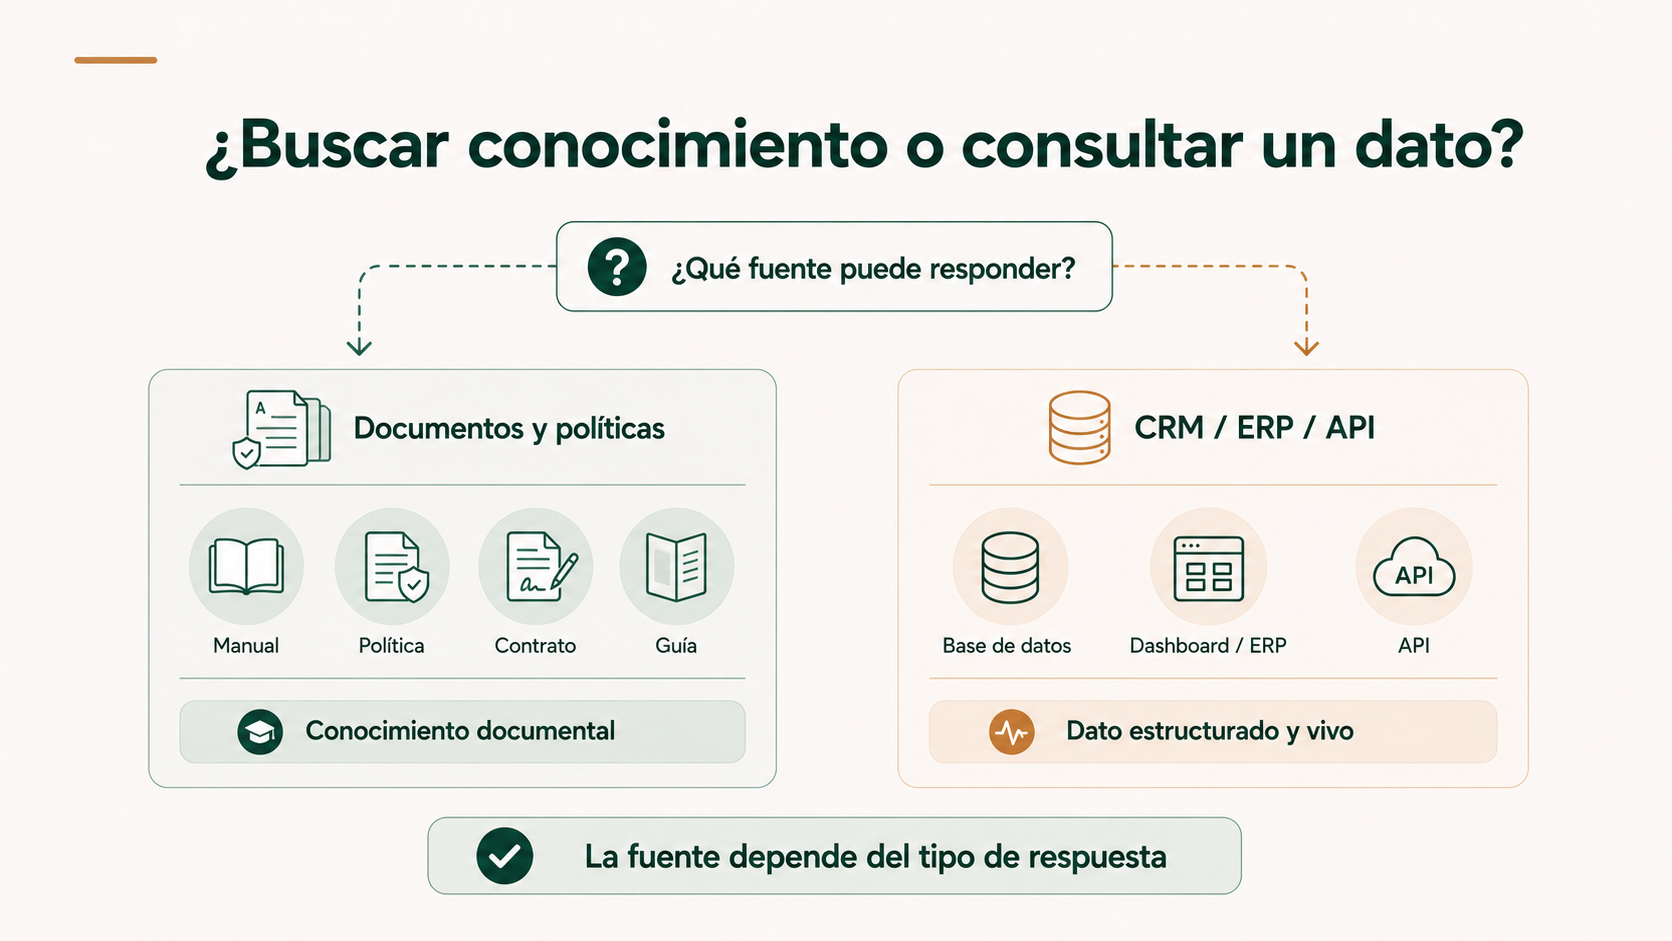
Antes de construir un RAG, decide si necesitas buscar conocimiento o consultar un dato.
La diferencia parece pequeña, pero cambia por completo la arquitectura. Una política de devoluciones, un manual técnico o un contrato son conocimiento documental: información expresada en texto que puede requerir localizar el fragmento adecuado. El stock de un producto, el estado de un pedido o el saldo de una factura son datos estructurados y vivos: valores que cambian y cuyo lugar natural suele ser el sistema que los gestiona.
RAG —Retrieval-Augmented Generation, o generación aumentada por recuperación— sirve para recuperar información relevante y utilizarla como contexto antes de que un modelo genere una respuesta. No es una fase superior de madurez. Es simplemente uno de varios mecanismos posibles.
Una buena arquitectura no intenta resolver todas las preguntas con la misma tecnología. Hace que cada pregunta llegue a la fuente que realmente puede responderla.
La pregunta es sencilla. El ERP ya tiene la respuesta.
Un equipo quiere crear un asistente interno. Una de las consultas previstas es: «¿Cuál es el precio vigente de este producto y cuántas unidades quedan?» La primera propuesta técnica es cargar catálogos, fichas y documentos en una base de conocimiento y construir un RAG.
El problema es que el ERP ya mantiene precio y stock actualizados.
Si el asistente consulta una copia indexada de esos datos, introduce una pregunta nueva que antes no existía: ¿cuánto tiempo puede estar desactualizada esa copia? Además, aparecen duplicidad, sincronización, versiones y conflictos entre fuentes.
Ahora cambia la pregunta: «¿Qué condiciones de garantía tiene este producto y qué procedimiento debe seguir soporte?» La respuesta ya no es un único campo de una base de datos. Puede estar repartida entre manuales, política comercial y documentación técnica. Aquí una capa de recuperación documental empieza a tener mucho más sentido.
El primer diseño no es elegir RAG, API o vector database. Es identificar la fuente autorizada de cada respuesta.
Qué es RAG sin convertirlo en una clase de ingeniería
RAG son las siglas de Retrieval-Augmented Generation. En español puede entenderse como generación aumentada por recuperación. La idea es sencilla: antes de pedir al modelo que responda, el sistema busca información relevante en una fuente externa y añade esa información al contexto de la consulta.
La palabra importante es recuperación. El modelo no necesita recibir toda la biblioteca documental de la empresa. El sistema intenta localizar primero las partes que pueden ayudar a responder.
Por ejemplo, si una empresa tiene cientos de manuales, procedimientos y políticas internas, una pregunta como «¿qué pasos debe seguir un proveedor para modificar su cuenta bancaria?» puede activar una búsqueda sobre ese corpus. Los fragmentos más relevantes se incorporan después al contexto del modelo para construir una respuesta apoyada en esas fuentes.
Esta explicación también ayuda a separar RAG de otros conceptos:
| Concepto | Qué hace principalmente | Qué no significa |
|---|---|---|
| RAG | Recupera conocimiento relevante y lo aporta al modelo para responder. | No convierte automáticamente el sistema en un agente. |
| OCR / extracción documental | Lee documentos y extrae texto o campos. | No decide por sí solo qué conocimiento recuperar para una pregunta. |
| Fine-tuning | Ajusta comportamiento o patrones del modelo mediante entrenamiento adicional. | No es un mecanismo para consultar documentos actualizados en cada pregunta. |
| Agente | Puede decidir dinámicamente acciones o herramientas dentro de límites. | No necesita RAG necesariamente, y usar RAG no lo convierte en agente. |
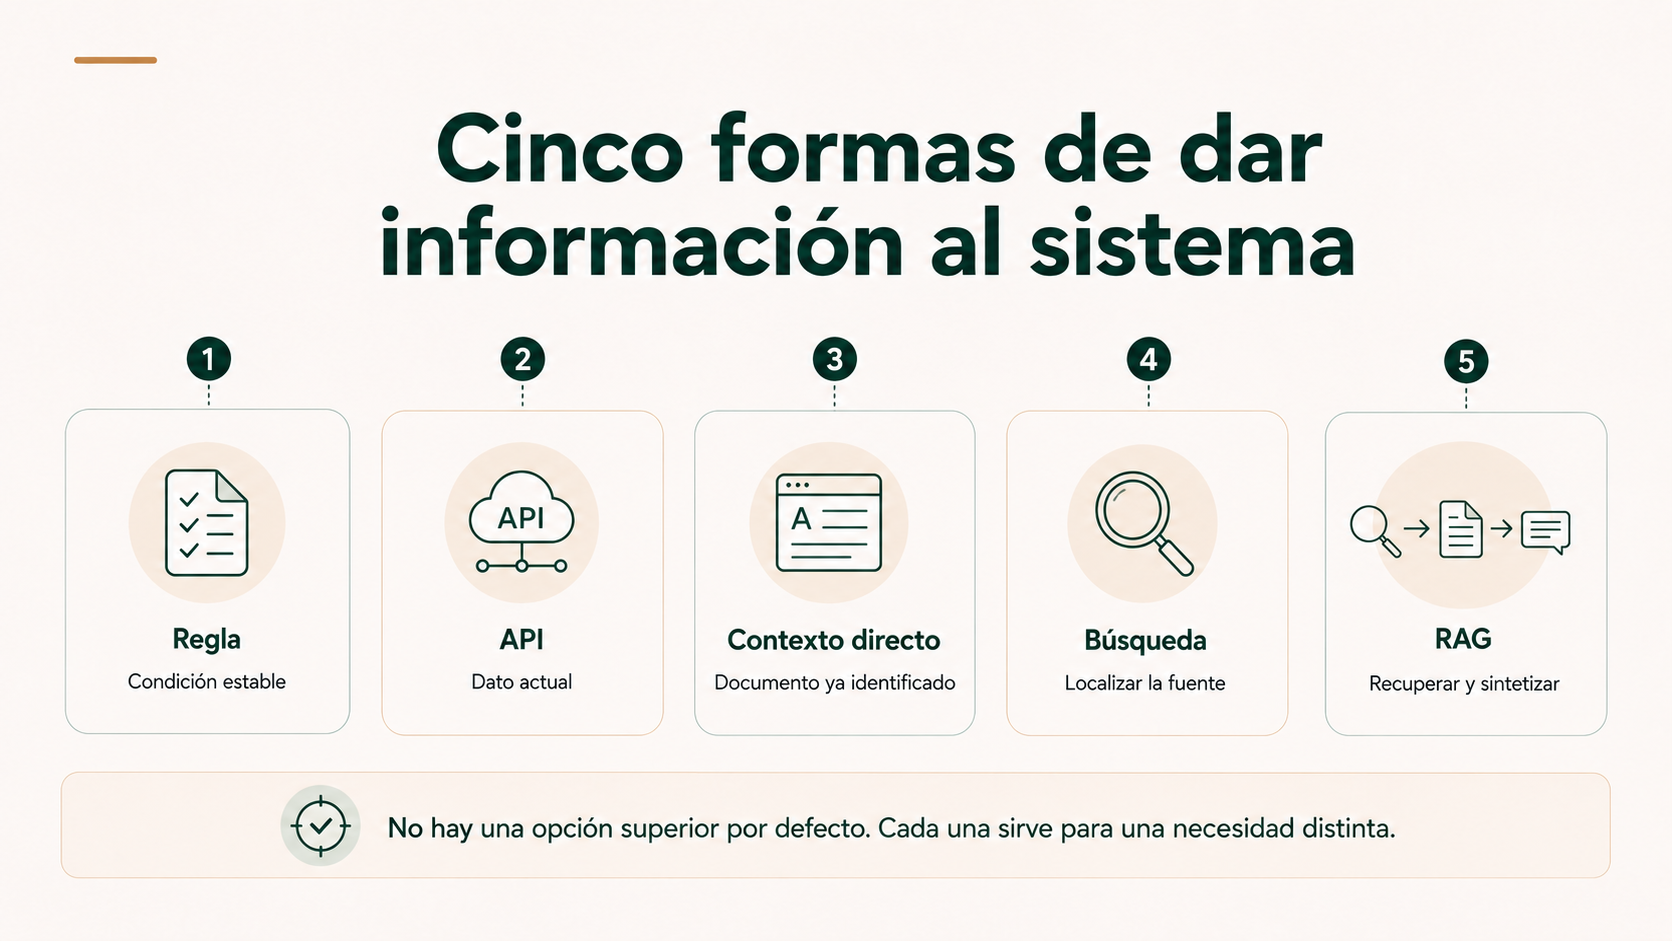
Cinco formas de dar información a un sistema: ninguna es «más madura» que otra
Hablar de «madurez» puede inducir a pensar que una empresa empieza con reglas, después evoluciona a APIs, luego a búsqueda y termina en RAG. Ese enfoque es incorrecto. Cada mecanismo resuelve una clase distinta de necesidad.
Una regla puede ser la mejor solución en una organización muy avanzada si el criterio de negocio es estable. Una API puede ser más adecuada que un RAG aunque el proyecto utilice IA generativa. Y una búsqueda tradicional puede ofrecer mejor experiencia que un chatbot si el usuario solo quiere encontrar el documento correcto.
| Mecanismo | Cuándo encaja | Ejemplo | Riesgo si se usa mal |
|---|---|---|---|
| Regla | La condición es estable y formalizable. | Pedidos superiores a cierto importe requieren aprobación. | Usar IA para reinterpretar una política ya convertida en lógica exacta. |
| API / consulta estructurada | La respuesta depende de un dato actual y existe un sistema que lo gobierna. | Stock, saldo, estado de pedido, disponibilidad. | Responder desde una copia obsoleta. |
| Contexto directo | El contenido relevante es pequeño, conocido y ya está identificado. | Un contrato concreto o una política breve. | Construir infraestructura de recuperación sin necesidad. |
| Búsqueda | El objetivo principal es localizar la fuente correcta. | Encontrar el procedimiento de vacaciones. | Generar una respuesta cuando bastaba con abrir el documento. |
| RAG | Hay que recuperar partes relevantes de un corpus amplio o disperso y utilizarlas para sintetizar una respuesta. | Asistente sobre manuales, contratos y procedimientos. | Indexar todo sin estrategia de permisos, versiones o evaluación. |
Cuándo una regla es mejor que recuperar documentos
Imagina que la política de compras establece una condición operativa que el negocio ya ha formalizado: si un pedido supera un determinado importe, necesita una aprobación adicional. El sistema no tiene por qué buscar el PDF de la política en cada ejecución, extraer un párrafo y pedir a un modelo que lo interprete.
Puede haber una regla explícita en el workflow.
RAG puede seguir siendo útil para explicar al usuario por qué existe esa política o localizar la documentación completa. Pero la consecuencia operativa puede vivir como lógica determinista.
Esto no significa que toda política escrita pueda traducirse fácilmente a reglas. Algunas tienen excepciones, lenguaje contractual o contexto difícil de formalizar. En esos casos puede recuperarse la evidencia y pedir revisión o utilizar una combinación. La clave es evitar que un modelo vuelva a «descubrir» en cada consulta algo que la empresa ya ha decidido convertir en una condición exacta.
Un dato vivo debe venir del sistema que manda
Dato estructurado y vivo significa un valor organizado en campos y que puede cambiar con la operación: importe pendiente, stock, estado de una oportunidad, disponibilidad, fecha de una cita, saldo, propietario de una incidencia o estado de un pedido.
La palabra «vivo» no significa que cambie cada segundo. Significa que su validez depende del estado actual del sistema, no de la última vez que alguien exportó un documento.
Cuando la actualidad es crítica, normalmente conviene consultar el sistema de referencia —CRM, ERP, PMS, ecommerce, base operativa u otra fuente autorizada— mediante API o consulta estructurada, siempre que la arquitectura real lo permita.
La guía sobre integración entre CRM y ERP desarrolla esta idea desde el punto de vista de autoridad del dato. Aquí la aplicamos a asistentes y sistemas de conocimiento.
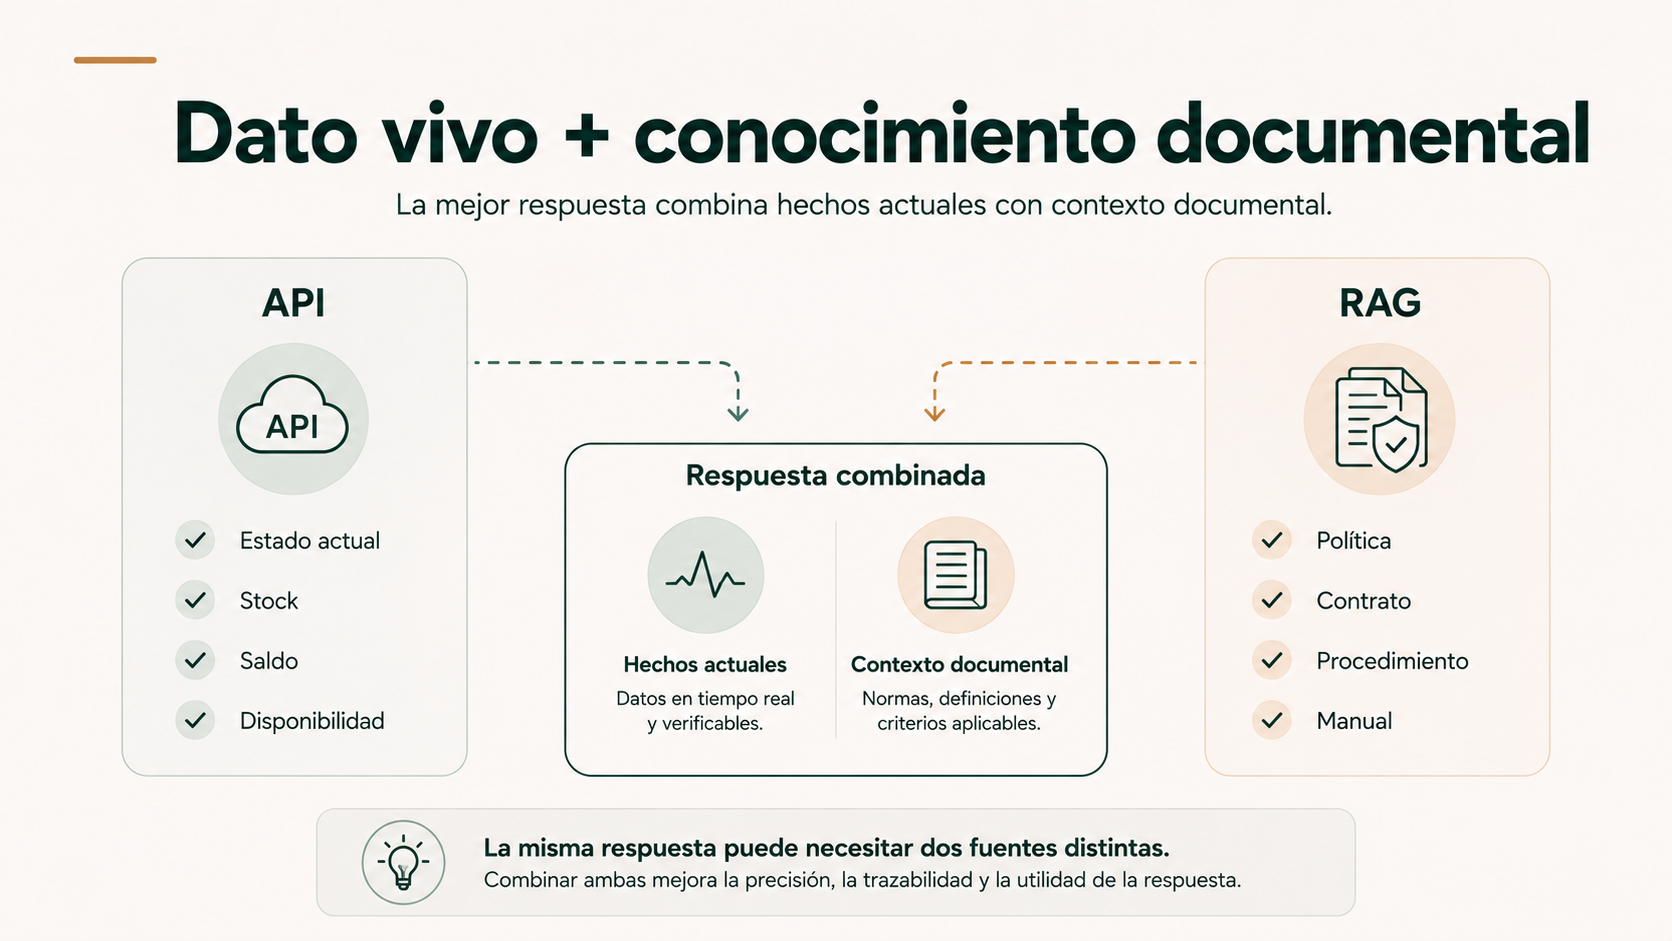
Ejemplo: «¿Está pagada la factura 4837?» es una consulta de estado. «¿Qué procedimiento seguimos cuando una factura lleva más de 60 días vencida?» es una consulta de conocimiento. Pueden aparecer juntas en una misma conversación y necesitar fuentes diferentes.
Una arquitectura combinada puede consultar la factura por API y recuperar por RAG la política de recobro. No existe obligación de elegir una sola tecnología para toda la respuesta.
A veces ya sabes qué documento necesitas: pásalo directamente
Supongamos que el usuario ya está trabajando sobre un contrato concreto. El documento está identificado, autorizado y su tamaño permite incluir el contenido relevante directamente en el contexto del modelo.
En ese escenario, construir un índice permanente puede no aportar suficiente valor. El sistema puede proporcionar el contrato —completo o mediante una selección controlada— directamente a la consulta.
La ventaja es arquitectónica: menos componentes, menos mantenimiento y ningún fallo de recuperación entre documentos que ya sabemos que no necesitamos consultar.
El límite aparece cuando crece el volumen, el contenido cambia con frecuencia, existen permisos complejos, el coste de contexto aumenta o la pregunta puede requerir localizar información en un corpus que ya no cabe razonablemente en cada petición.
No hay un tamaño universal a partir del cual «empieza RAG». Depende del modelo, del coste, la latencia, el tipo de contenido y la calidad requerida.
No toda pregunta empresarial necesita una respuesta generada
Un empleado escribe: «Necesito la política de teletrabajo de España». Quizá lo más útil sea devolverle el documento vigente y la sección correspondiente, no redactar una nueva explicación de tres párrafos.
La generación añade una capa de interpretación. Puede resumir bien, pero también puede omitir una excepción o simplificar una condición que el usuario debería leer literalmente.
Por eso, una búsqueda bien diseñada puede ser suficiente cuando el objetivo es localizar una fuente, un contrato, un procedimiento, una ficha o un fragmento concreto.
En algunos productos, búsqueda y generación pueden coexistir: mostrar primero las fuentes recuperadas y ofrecer después una síntesis. El criterio no debería ser «tenemos un LLM, así que debe redactar», sino qué necesita el usuario para tomar la siguiente decisión.
Cuándo RAG sí empieza a justificar su complejidad
RAG cobra sentido cuando el sistema no puede saber de antemano qué documento contiene la respuesta y necesita recuperar partes relevantes de una colección amplia o dispersa.
Señales habituales:
- Existe demasiado contenido para enviarlo completo al modelo.
- La información está distribuida entre múltiples documentos o fuentes.
- Las preguntas se formulan en lenguaje natural y no siempre utilizan las mismas palabras que la documentación.
- Es importante seleccionar evidencia antes de generar una respuesta.
- El corpus cambia y existe un proceso real de actualización.
- Hay que mostrar o citar de dónde sale la respuesta.
- Los usuarios tienen permisos diferentes sobre partes de la documentación.
- La terminología exacta y el significado conceptual pueden ser importantes al mismo tiempo.
Estas señales no producen una puntuación automática. Un corpus grande pero mal mantenido no se arregla por instalar una base vectorial. Y un conjunto pequeño con permisos imposibles de reproducir puede desaconsejar la indexación aunque técnicamente sea sencilla.
RAG no es «base vectorial + chatbot»
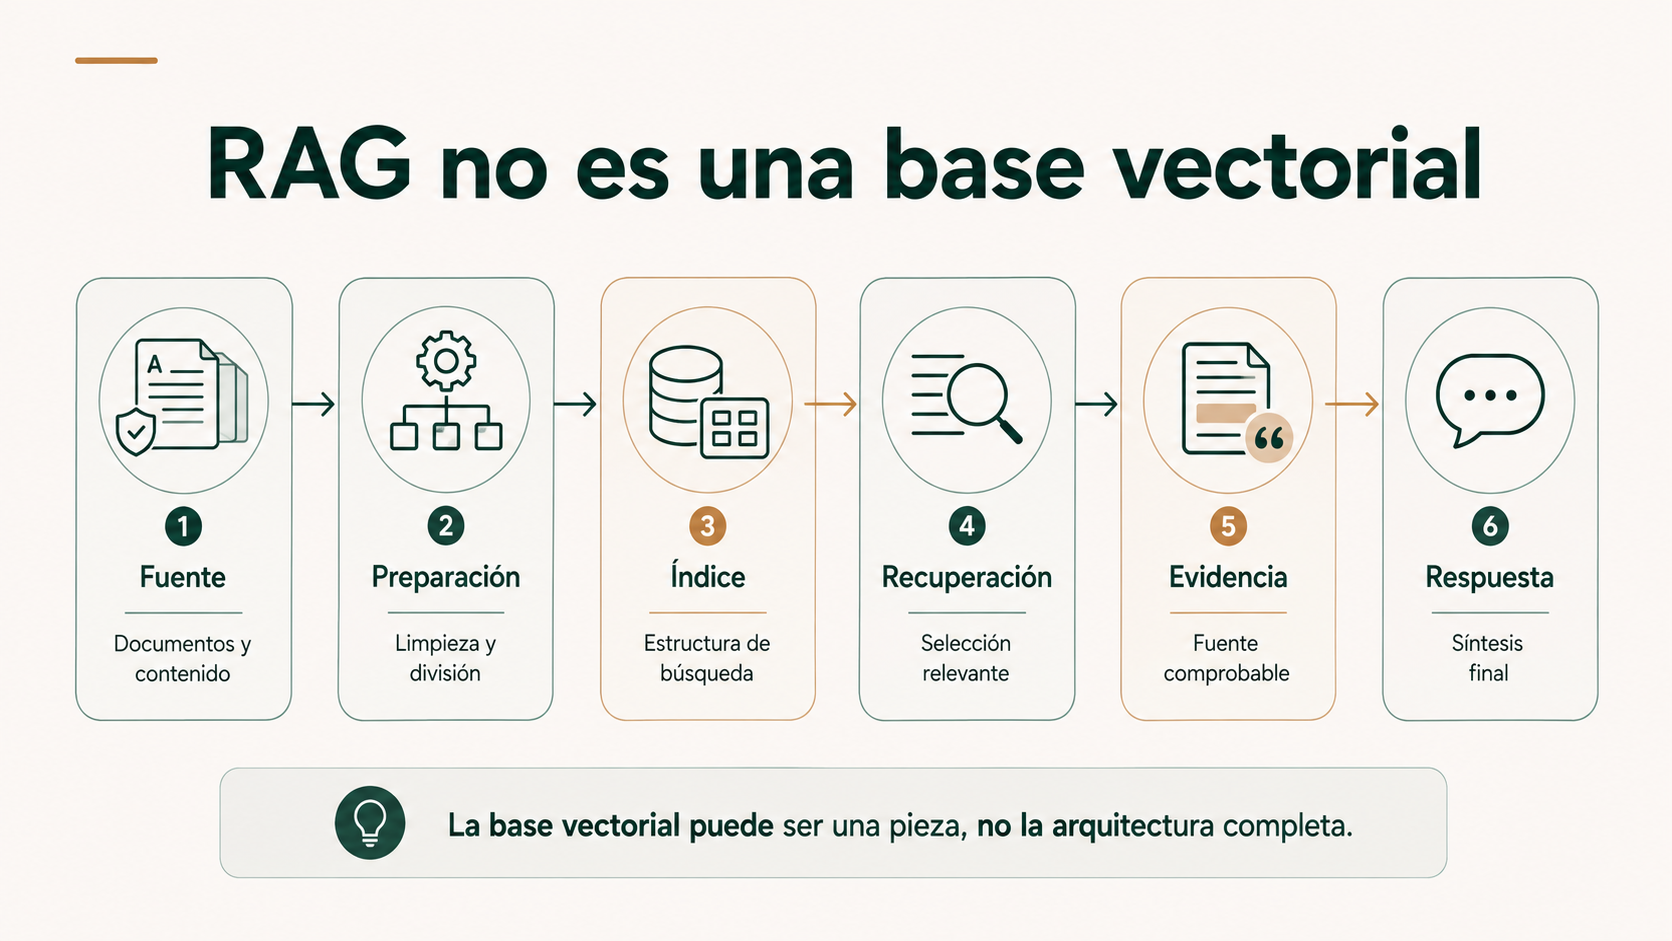
La caricatura habitual dibuja tres cajas: documentos → base vectorial → chatbot. En producción faltan decisiones importantes.
Fuente. Qué documentos entran y quién es propietario de ese contenido.
Preparación. Cómo se extrae, normaliza y divide el contenido.
Metadatos. Qué información acompaña a cada documento o fragmento: versión, fecha, cliente, país, idioma, permisos o tipo.
Índice. Qué estructuras permiten localizar contenido por texto, vectores u otros criterios.
Recuperación. Cómo se formula la búsqueda, qué filtros se aplican y cuántos candidatos se consideran.
Selección. Cómo se ordena o reordena la evidencia que llegará al modelo.
Generación. Cómo se construye la respuesta usando solo el contexto autorizado.
Evidencia. Cómo puede el usuario abrir y comprobar la fuente.
Actualización y evaluación. Cómo se sustituyen versiones, se borran documentos y se comprueba que el sistema sigue recuperando bien.
Una base vectorial es uno de los componentes posibles para búsqueda semántica. No define por sí sola un sistema RAG y tampoco garantiza que la información correcta llegue al modelo.
Un fragmento puede ser correcto y aun así perder el significado
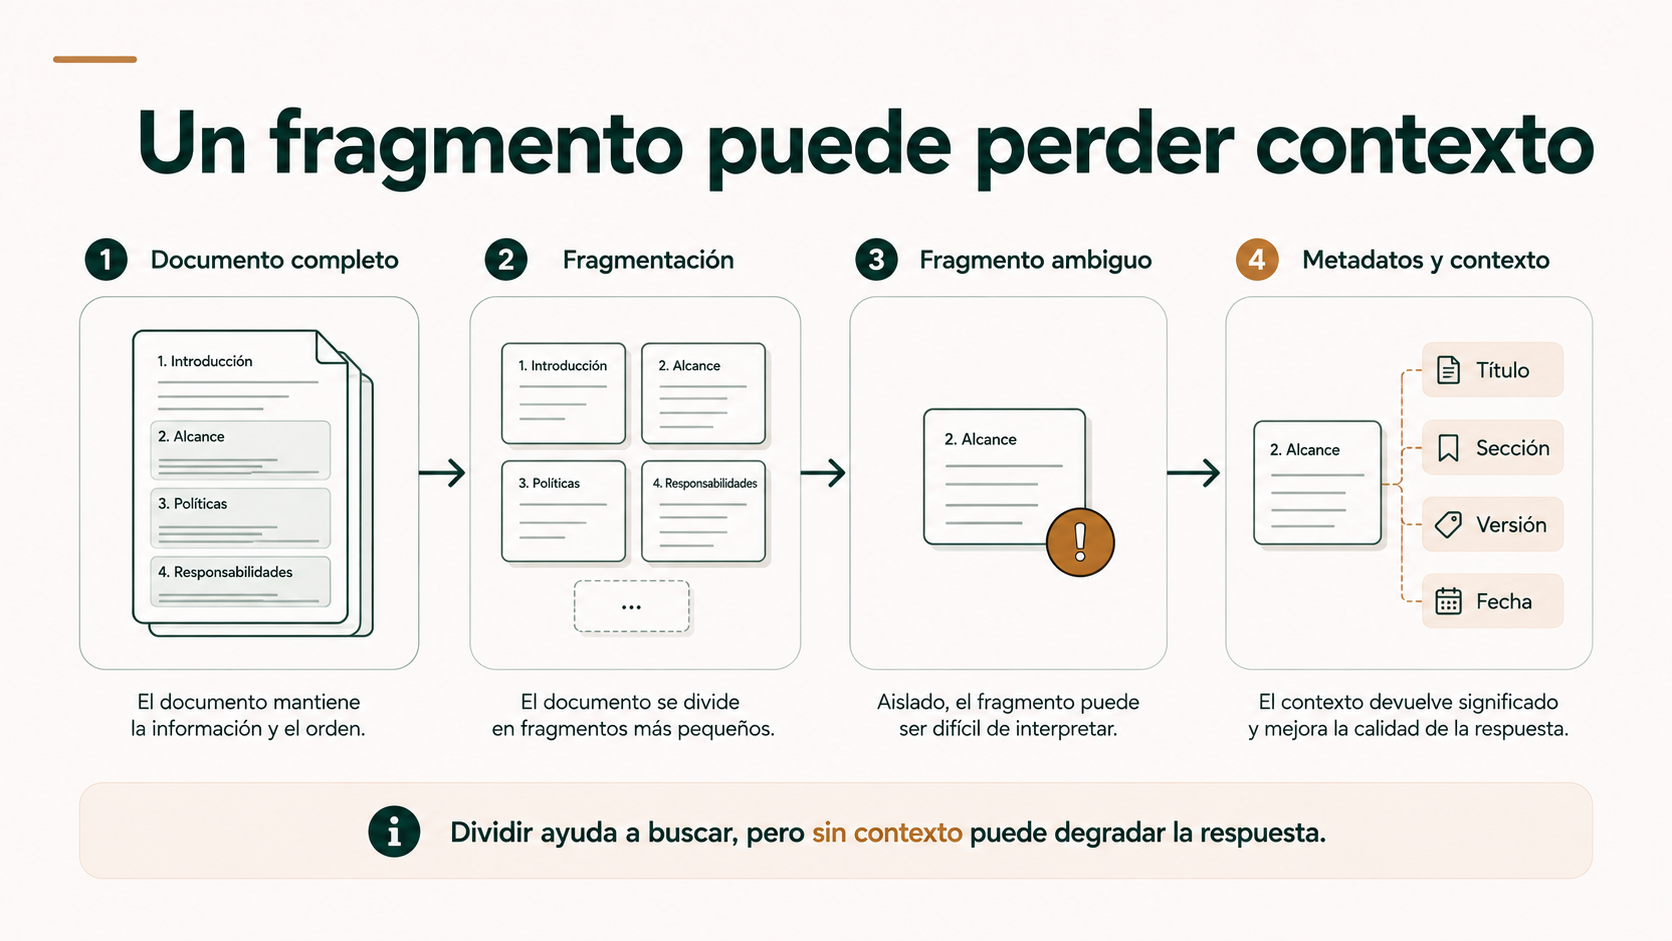
Los documentos largos suelen dividirse en unidades más pequeñas para poder recuperarlas de forma independiente. A estas unidades se las llama habitualmente chunks; en este artículo usaremos «fragmentos».
El problema aparece cuando un fragmento deja atrás la información que le daba contexto.
Imagina este texto recuperado: «El cliente dispone de 30 días para solicitar la renovación». ¿De qué producto habla? ¿Qué país? ¿Qué versión del contrato? ¿Desde qué fecha se cuentan esos 30 días?
El párrafo puede ser literalmente correcto y, sin embargo, ser insuficiente o engañoso fuera de su sección original.
Por eso el diseño de fragmentación puede conservar títulos, secciones, referencias de documento, fechas, entidades u otros metadatos. También puede utilizar solapamiento o enriquecer cada fragmento con contexto adicional.
No existe un tamaño universal de fragmento. Tampoco existe un número universal de resultados a recuperar.
Qué significan chunk, top-k, score y threshold
Chunk: el fragmento en el que se divide un documento para poder buscarlo de forma independiente.
Top-k: cuántos resultados mejor posicionados decide recuperar el sistema en una consulta. Si k=5, por ejemplo, se consideran cinco candidatos. Eso no significa que cinco sea un valor correcto para todos los casos.
Score: una puntuación que utiliza el sistema para ordenar o valorar coincidencias. Su significado depende del buscador o modelo; no debe interpretarse automáticamente como «probabilidad de que la respuesta sea correcta».
Threshold o umbral: valor mínimo que se puede utilizar para aceptar o descartar resultados según esa puntuación. No existe un umbral universal de «verdad».
Embeddings, palabras exactas y búsqueda híbrida: cada una encuentra cosas distintas
Un embedding es una representación numérica del significado aproximado de un texto. Permite que el sistema compare una pregunta con documentos por similitud conceptual, incluso cuando no comparten exactamente las mismas palabras.
Por ejemplo, una consulta sobre «vacaciones» puede localizar un documento que utiliza «permiso anual» si ambos conceptos aparecen suficientemente relacionados para el modelo de embeddings.
La búsqueda vectorial utiliza esas representaciones para encontrar contenidos semánticamente parecidos.
Pero las coincidencias exactas siguen siendo importantes
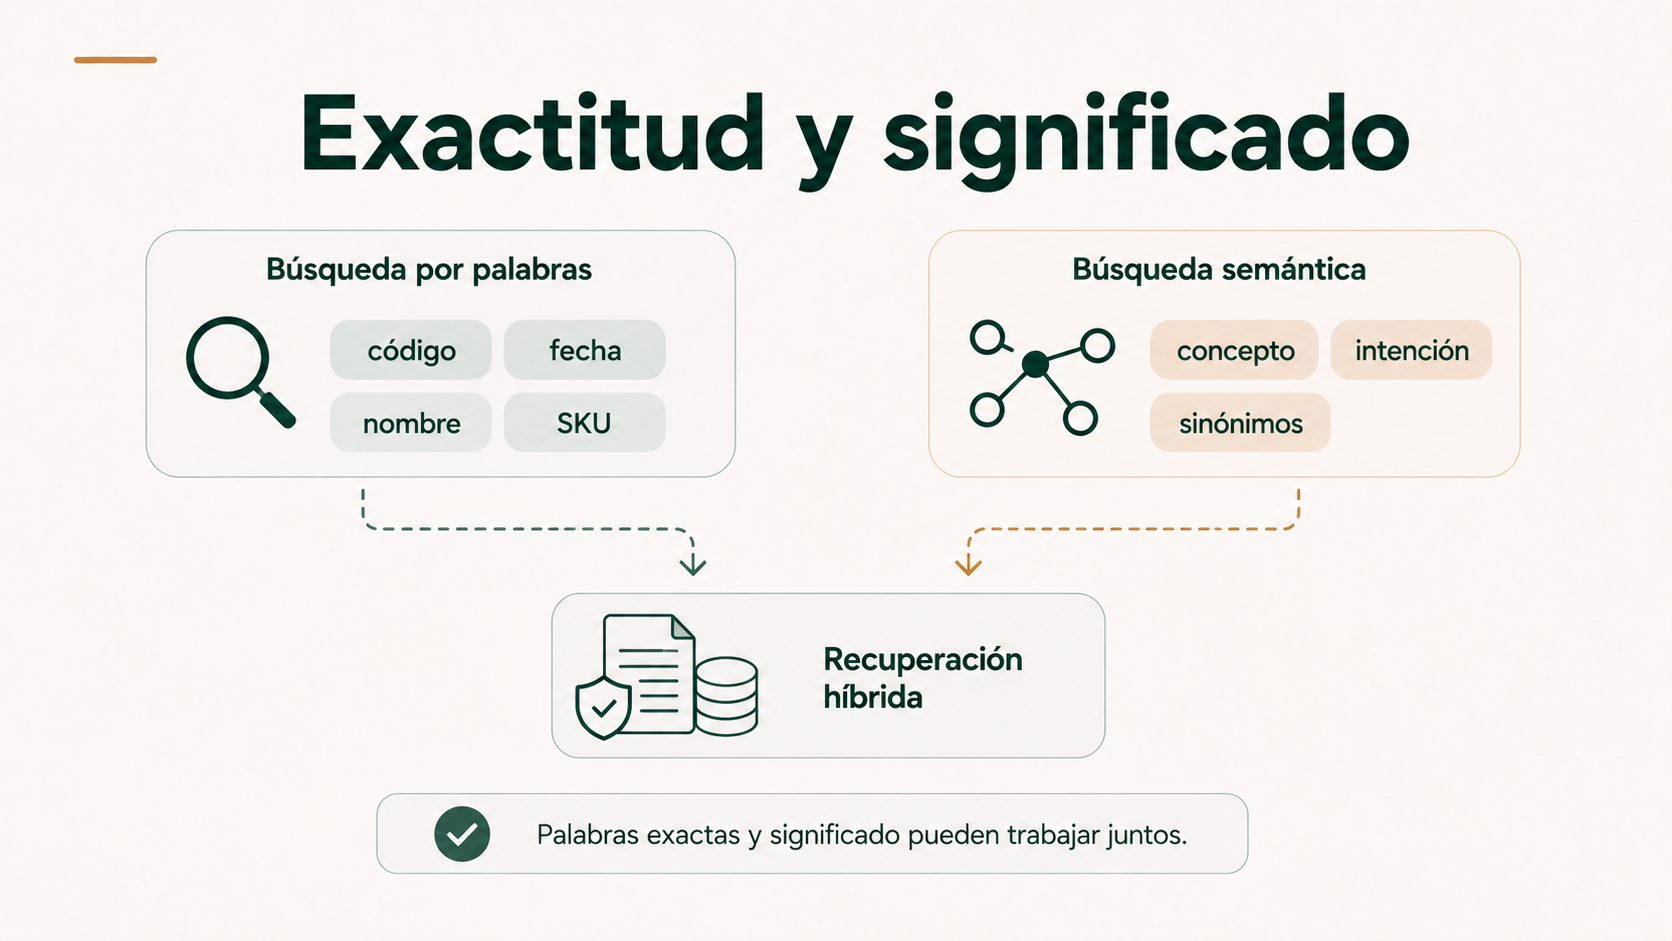
Keyword search significa búsqueda por palabras o texto. No es una tecnología obsoleta frente a los vectores. Puede ser especialmente valiosa para referencias de producto, códigos, números de expediente, nombres propios, fechas, siglas y terminología especializada.
Una búsqueda semántica puede entender que «tiempo libre» se relaciona con «vacaciones». Pero si el usuario escribe «SKU AX-4831», probablemente interese encontrar exactamente esa referencia.
Qué significa búsqueda híbrida
La búsqueda híbrida combina en una misma recuperación resultados de búsqueda textual y de búsqueda vectorial. En lugar de elegir entre «palabras exactas» o «significado», se ejecutan ambos mecanismos y después se combinan sus resultados.
Azure AI Search, por ejemplo, documenta consultas híbridas donde texto completo y vectores se ejecutan en paralelo y sus rankings se fusionan después. Eso permite que una consulta pueda beneficiarse tanto de coincidencias precisas como de similitud conceptual.
Esto no significa que la búsqueda híbrida sea siempre mejor. Añade parámetros y decisiones de ranking, y debe probarse con las consultas reales del negocio.
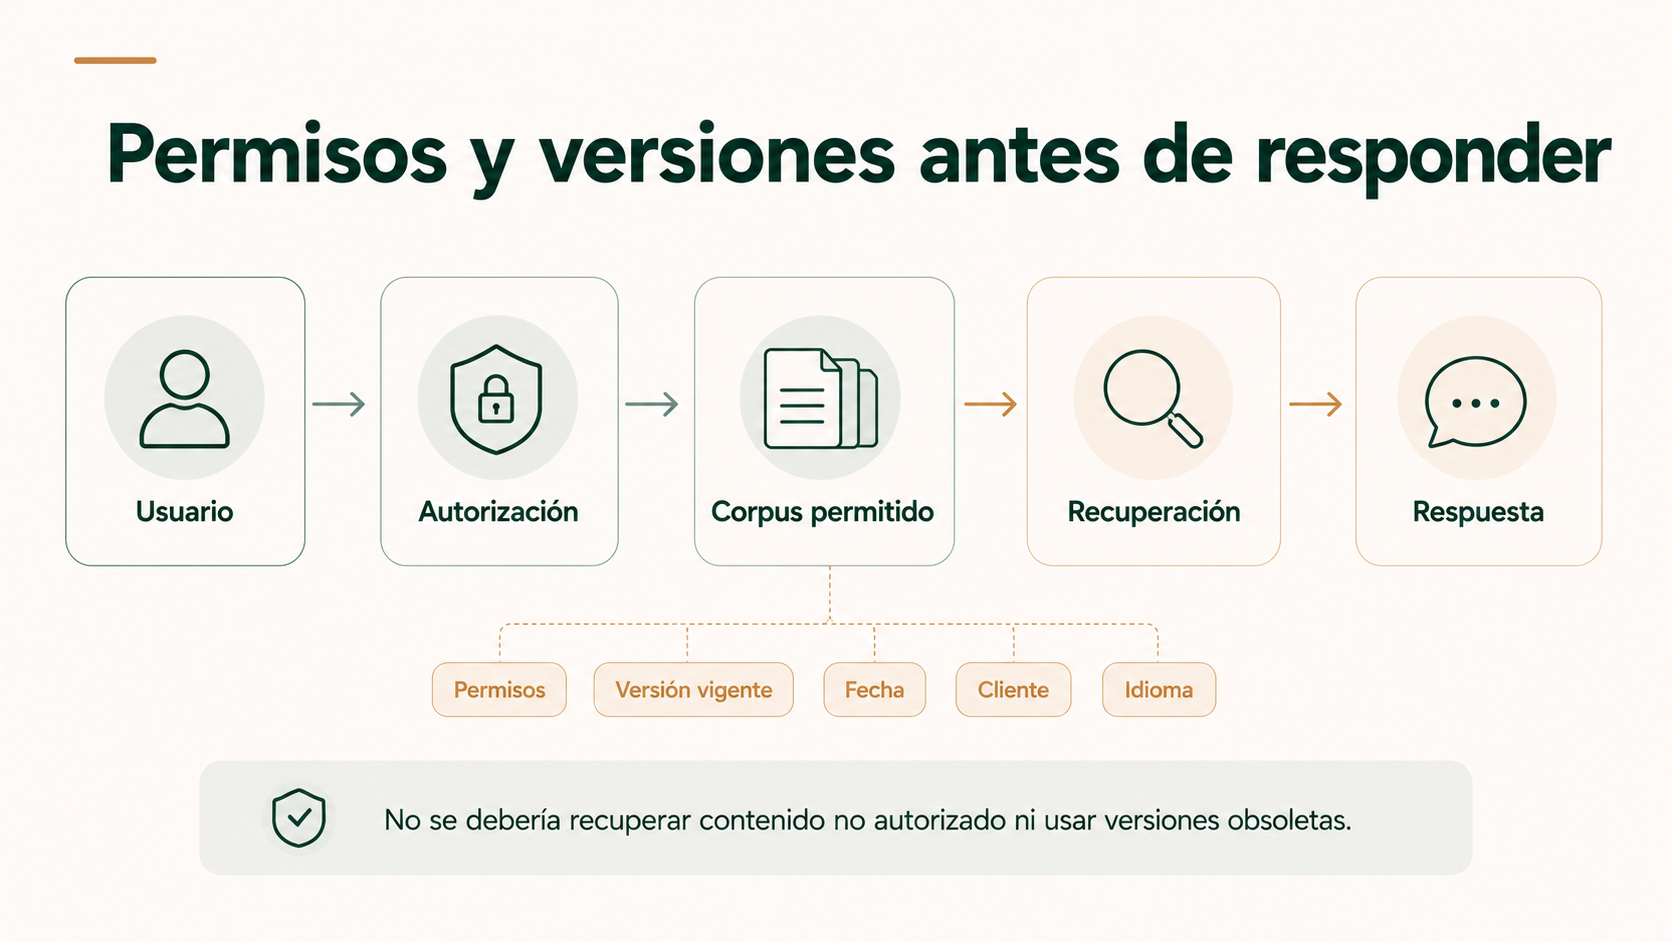
Permisos: no recuperes primero y confíes en ocultar después
Un asistente de conocimiento puede tener acceso a documentos de recursos humanos, contratos, información comercial, procedimientos técnicos y documentación de clientes. No todos los usuarios deberían poder consultar todo.
La autorización debe formar parte del acceso a la fuente o de la recuperación. El sistema no debería recuperar contenido no autorizado y confiar después en que el modelo no lo revele.
Los filtros pueden utilizar metadatos como departamento, cliente, país, nivel de confidencialidad o grupos de acceso. OpenAI File Search y sistemas empresariales de búsqueda permiten trabajar con atributos o filtros durante la recuperación.
En arquitecturas con permisos complejos, también puede ser necesario consultar la fuente utilizando la identidad del usuario o preservar listas de control de acceso equivalentes. Si el índice pierde la lógica de permisos original, la comodidad técnica puede crear una exposición de información que no existía antes. El diseño de permisos y credenciales debe resolverse antes de ampliar el acceso del sistema.
Versiones y vigencia
Una política de 2024 y su versión de 2026 pueden ser semánticamente muy parecidas. Si ambas están indexadas sin distinguir estado y vigencia, la recuperación puede devolver la antigua.
Por eso conviene definir qué significa «vigente», cómo se sustituyen versiones, cómo se eliminan documentos y qué metadatos permiten filtrar por fecha, estado o versión.
El índice también envejece
RAG no proporciona información «en tiempo real» por existir. Entre la fuente y el índice puede haber un proceso de ingestión. Hay que saber qué dispara una actualización, cuánto retraso se acepta y qué ocurre con el contenido eliminado o modificado.
Cuando esa demora no es aceptable porque la pregunta depende de un dato transaccional, vuelve a aparecer la opción de API o consulta directa.
Una cita mejora la trazabilidad. No convierte automáticamente la respuesta en correcta.
Mostrar el documento o fragmento utilizado ayuda mucho. Permite al usuario verificar de dónde sale una afirmación y detectar una versión antigua o una interpretación dudosa.
Pero la cita no elimina el riesgo de error. El sistema puede recuperar el documento correcto y después:
- Interpretar mal una condición.
- Omitir una excepción situada en otro fragmento.
- Mezclar dos versiones.
- Generalizar una regla específica.
- Añadir una conclusión que no aparece en la evidencia.
Por eso conviene diferenciar visualmente fuente recuperada y conclusión generada.
¿Qué hace el sistema cuando no encuentra suficiente evidencia?
Una arquitectura robusta no obliga al modelo a responder siempre. Puede indicar que no ha encontrado evidencia suficiente, pedir una aclaración, reformular la búsqueda, consultar otra fuente autorizada o escalar el caso.
No hay un score universal que separe automáticamente «hay evidencia» de «no hay evidencia». Las puntuaciones dependen del sistema de búsqueda y deben calibrarse mediante pruebas representativas.
Reranking: una segunda mirada a los candidatos antes de responder
Reranking significa reordenar los resultados recuperados con un criterio de relevancia adicional. En español puede entenderse como una segunda pasada de selección.
Imagina que la primera búsqueda recupera veinte fragmentos razonables. El fragmento más útil aparece en la posición ocho. Un mecanismo de reordenación puede volver a evaluar esos candidatos y colocarlo más arriba antes de construir el contexto final.
Anthropic documenta un enfoque de recuperación donde combina embeddings, búsqueda BM25 y una fase de reranking para mejorar su recuperación contextual. Microsoft también ofrece clasificación semántica como capa adicional en determinados flujos de Azure AI Search.
No es un requisito de RAG. Añade coste, latencia y complejidad. Solo tiene sentido si la evaluación muestra que el problema real está en ordenar mejor candidatos razonables.
Ejemplo práctico: una sola pregunta necesita CRM, contrato y política interna
El siguiente ejemplo es ficticio. Imaginemos una empresa B2B que trabaja con CRM, ERP y documentación en Drive o SharePoint.
Un comercial pregunta:
«¿Qué condiciones de renovación tiene ACME y qué debemos hacer este mes?»
1. Identificar qué parte de la pregunta corresponde a cada fuente
El CRM contiene la oportunidad actual, responsable, fecha prevista y actividad comercial. El contrato contiene cláusulas de renovación. La política comercial interna describe qué autorizaciones o pasos deben seguirse.
2. Consultar por API el dato actual
El sistema obtiene del CRM el estado vigente de la oportunidad y las fechas. No intenta recuperar una exportación antigua del CRM mediante búsqueda semántica.
3. Recuperar conocimiento documental
El contrato está correctamente identificado y el usuario tiene permiso. Puede proporcionarse directamente o recuperarse dentro de un corpus autorizado. La política comercial sí puede localizarse mediante búsqueda/RAG si forma parte de una colección amplia.
4. Separar hechos de interpretación
La respuesta puede mostrar:
- Dato actual del CRM: estado, fecha, responsable.
- Condición contractual: fragmento relevante y referencia al contrato.
- Política interna: procedimiento aplicable y fuente vigente.
- Siguiente acción: si existe una regla clara, el workflow puede generar la tarea correspondiente.
5. No forzar una conclusión si las fuentes entran en conflicto
Si el contrato tiene una redacción ambigua, aparece una versión duplicada o la política interna contradice el documento autorizado, el sistema debe decirlo y derivar a la persona competente.
Esta combinación muestra por qué RAG no sustituye a APIs ni workflows. RAG aporta conocimiento; la API aporta estado; las reglas gobiernan consecuencias. Si además se necesita decidir dinámicamente qué herramienta consultar y en qué orden, entonces puede aparecer una arquitectura de agente, desarrollada aparte en la guía de workflow frente a agente de IA.
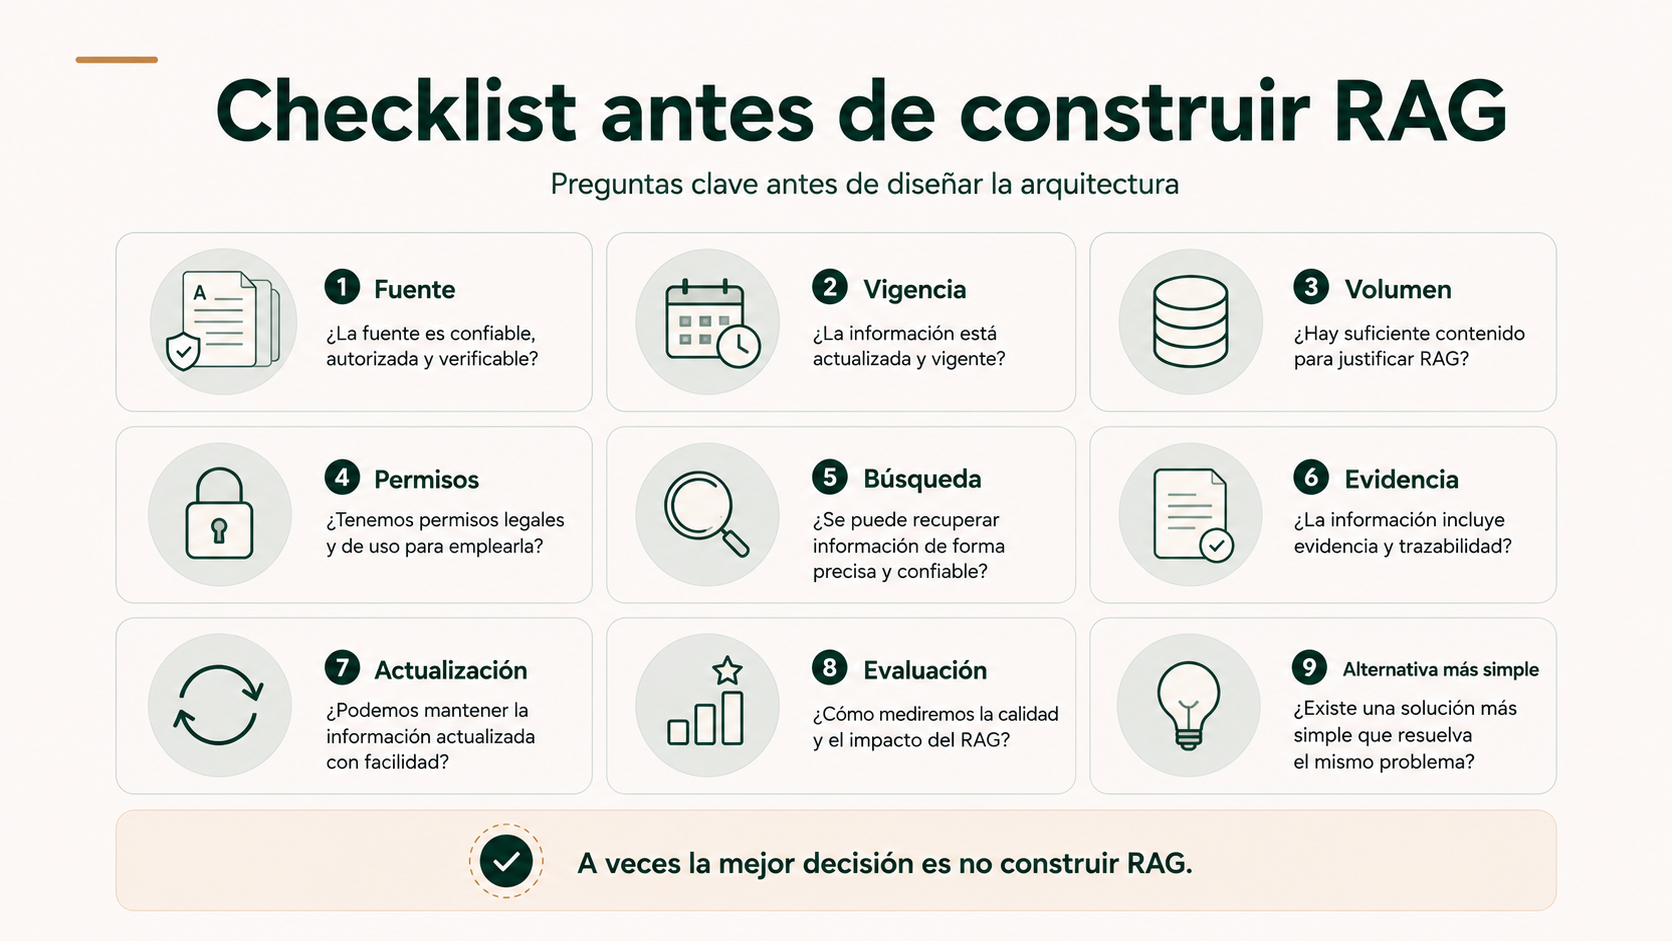
Un marco de decisión antes de escribir «RAG» en la arquitectura
En Yarvia utilizamos este tipo de preguntas como marco de diagnóstico. No es un estándar del sector ni genera una puntuación automática.
1. Fuente
¿La respuesta ya existe como regla, dato vivo, documento conocido o conocimiento repartido?
2. Actualidad
¿Qué retraso puede aceptarse antes de que la respuesta deje de ser válida?
3. Volumen
¿Cuánto contenido debe considerarse y puede enviarse directamente?
4. Permisos
¿Quién puede consultar qué y cómo se conserva esa autorización durante la recuperación?
5. Tipo de consulta
¿Necesitamos coincidencia exacta, similitud conceptual, ambas o una consulta estructurada?
6. Evidencia
¿El usuario necesita abrir la fuente y distinguirla de la interpretación del modelo?
7. Ausencia de respuesta
¿Qué debe ocurrir cuando no se encuentra evidencia suficiente?
8. Evaluación
¿Cómo comprobaremos que recupera lo correcto y que responde basándose en ello?
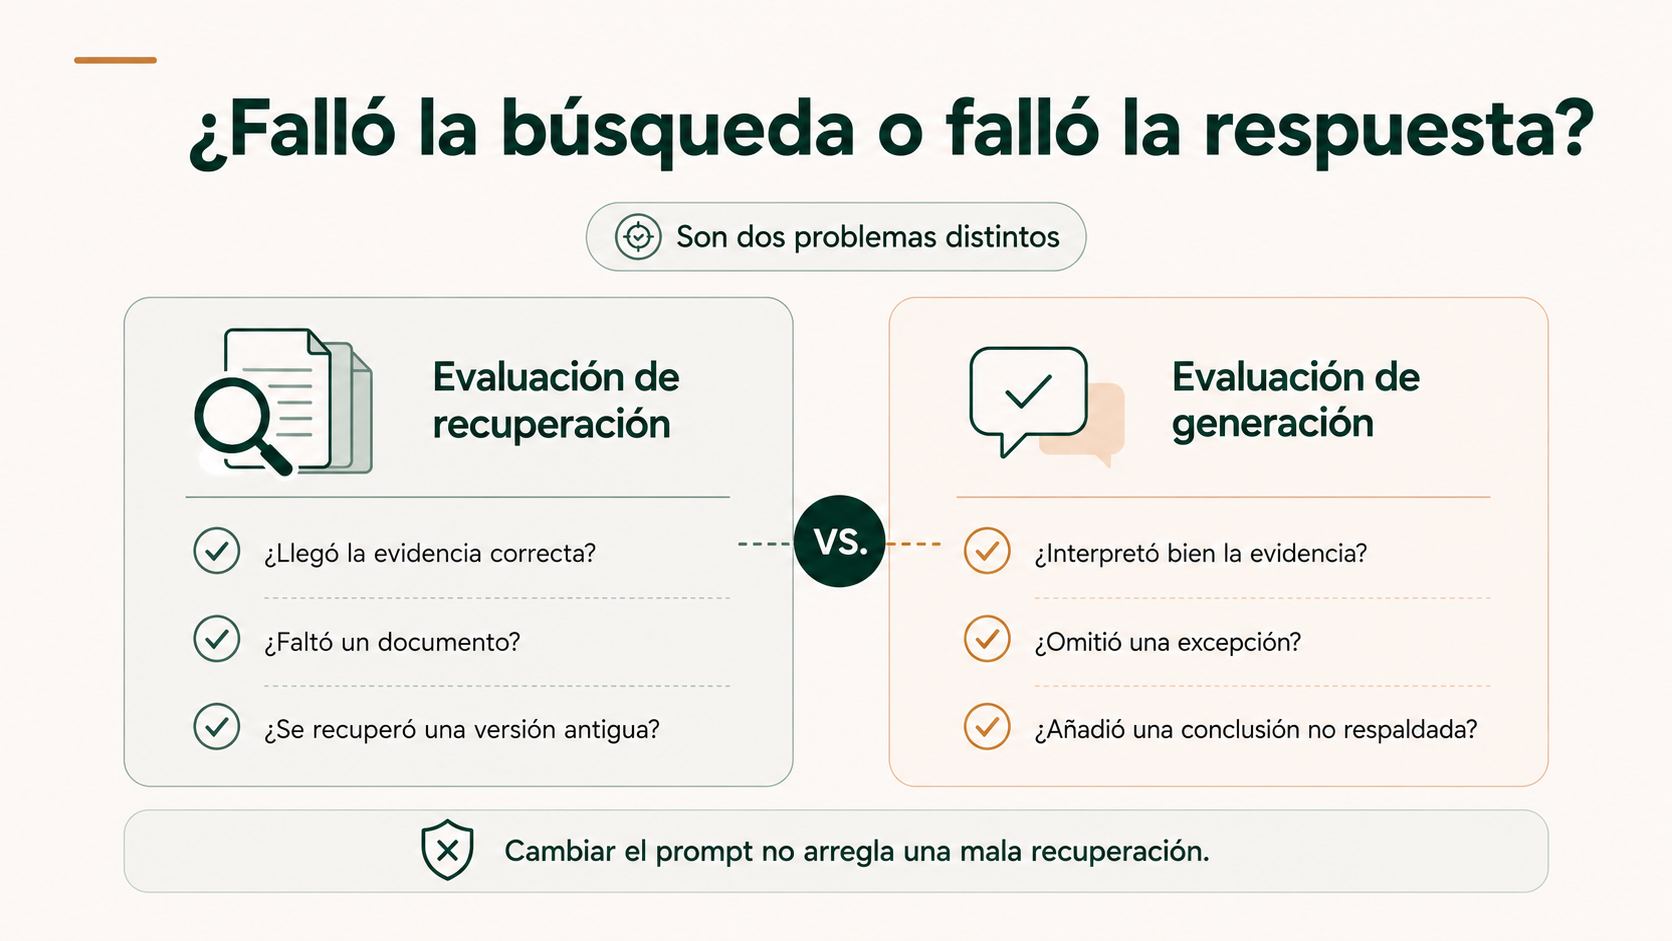
Si la respuesta falla, primero averigua si falló la búsqueda o la generación
En RAG hay dos problemas distintos que a menudo se mezclan.
| Capa | Pregunta de evaluación | Ejemplo de fallo |
|---|---|---|
| Recuperación | ¿Llegó al modelo la evidencia correcta? | La política vigente nunca apareció entre los resultados. |
| Generación | ¿El modelo utilizó correctamente la evidencia disponible? | La política estaba en contexto, pero la respuesta omitió una excepción. |
Este diagnóstico es fundamental. Cambiar el prompt no arregla un documento que nunca se recuperó. Cambiar embeddings no arregla una respuesta que ya tenía la evidencia correcta y la interpretó mal.
Los casos de prueba deberían incluir preguntas directas, sinónimos, códigos, nombres, documentos muy parecidos, versiones antiguas, conflictos, ausencia de respuesta, permisos distintos y preguntas que requieren combinar varias fuentes.
No fijaremos aquí métricas universales ni entraremos en evals completos de agentes; esa profundidad corresponde a una pieza posterior. Para medir el impacto empresarial del sistema completo, puede utilizarse el marco de KPIs de automatización de procesos.
Coste, latencia y mantenimiento también forman parte de la decisión
RAG añade componentes: ingestión, fragmentación, embeddings, índice, consultas, filtros, posible reranking, generación, observabilidad y actualización. También puede reducir la cantidad de contexto que se envía al modelo frente a cargar documentos completos.
No es correcto afirmar que RAG sea siempre más caro o más barato. La comparación debe hacerse sobre el caso real: coste por consulta, tiempo de respuesta, frecuencia de reindexación, complejidad de permisos y esfuerzo de mantenimiento.
Seguridad: los documentos recuperados son datos, no instrucciones autorizadas
Un documento puede contener texto que parezca una instrucción para el modelo. Si el sistema además tiene herramientas para actuar, ese contenido puede convertirse en un vector de prompt injection indirecta: instrucciones maliciosas o no confiables escondidas en información que el sistema consulta.
La protección requiere separar instrucciones del sistema, contenido recuperado y permisos de acción. La profundidad de agentes, herramientas y controles pertenece a otras piezas; aquí basta con recordar que recuperar un documento no concede autoridad a lo que ese documento le diga al modelo que haga.
Cuándo no construir RAG
No construir RAG también puede ser una decisión técnica avanzada. Tiene sentido descartarlo cuando la respuesta es una regla estable, el dato está disponible en un sistema de referencia, solo hay uno o pocos documentos conocidos, el usuario necesita localizar una fuente pero no una síntesis, no existe un proceso de actualización, los permisos no pueden conservarse correctamente o nadie ha definido cómo se evaluará la recuperación.
También conviene detenerse cuando el corpus contiene múltiples versiones contradictorias y nadie sabe cuál manda. RAG no resuelve un problema de gobierno documental: puede hacerlo más visible y, si se diseña mal, multiplicarlo.
Señal de sobrediseño: si para responder una pregunta exacta el equipo está diseñando embeddings, vector store, sincronización y reranking mientras el sistema transaccional ya ofrece el dato mediante una consulta fiable, probablemente la complejidad está en el lugar equivocado.
Preguntas frecuentes
¿RAG necesita siempre una base vectorial?
No. Muchas implementaciones utilizan búsqueda vectorial porque ayuda a recuperar contenido por similitud semántica, pero RAG describe un patrón de recuperación + generación, no una tecnología de almacenamiento obligatoria. Puede combinar búsqueda textual, vectorial, filtros, fuentes remotas u otros mecanismos.
¿RAG evita que una IA alucine?
No. Aportar evidencia relevante puede reducir respuestas basadas únicamente en conocimiento interno del modelo, pero sigue siendo posible recuperar información incorrecta, mezclar versiones o interpretar mal una fuente. Por eso recuperación y generación deben evaluarse por separado.
¿Puedo usar RAG sobre datos del CRM o ERP?
Técnicamente pueden indexarse muchos tipos de contenido, pero eso no significa que sea la mejor fuente. Si la respuesta depende del estado actual del CRM o ERP, normalmente conviene consultar el sistema autorizado directamente. RAG puede complementar esa respuesta con documentación explicativa.
¿Qué diferencia hay entre búsqueda semántica y búsqueda híbrida?
La búsqueda semántica o vectorial intenta encontrar contenido por similitud de significado. La híbrida combina esa señal con búsqueda textual por palabras. Puede ser útil cuando importan tanto conceptos similares como códigos, nombres o términos exactos.
¿Cuándo debería empezar un piloto RAG?
Cuando existen preguntas reales, fuentes identificadas, permisos definidos y un conjunto de casos con el que evaluar recuperación y respuesta. Empezar cargando «todos los documentos de la empresa» antes de definir qué debe responder el sistema suele dificultar el diagnóstico. Ese conjunto puede convertirse después en una evaluación repetible del sistema antes de ampliar su alcance.
DIAGNÓSTICO DE ARQUITECTURA DE CONOCIMIENTO
Antes de elegir RAG, define qué pregunta debe responder cada fuente
Un diagnóstico útil parte de preguntas reales y mapea fuente, autoridad del dato, volumen, permisos, vigencia, necesidad de búsqueda, evidencia, coste, latencia y evaluación.
La salida puede ser una regla, una API, contexto directo, un buscador, RAG, una combinación RAG + API o incluso decidir que no hace falta IA.
No tiene sentido vender RAG antes de saber qué información debe consultar el sistema y quién tiene autoridad sobre ella.
Fuentes
- OpenAI — File Search y Retrieval
Documentación oficial sobre vector stores, búsqueda de contenido relevante, atributos/filtros y recuperación semántica.
Consultar File Search · Consultar Retrieval - Anthropic — Contextual Retrieval
Fuente técnica para RAG, embeddings, BM25, fragmentación, pérdida de contexto y reordenación de resultados.
Consultar fuente - Microsoft Learn — RAG en Azure AI Search
Documentación de producto sobre retos de recuperación, fragmentación, búsqueda vectorial/híbrida, seguridad, gobernanza y composición de respuestas.
Consultar fuente - Microsoft Learn — Búsqueda híbrida en Azure AI Search
Referencia para explicar combinación de texto completo y vectores, coincidencias exactas y fusión de rankings.
Consultar fuente - Google Cloud — Vertex AI RAG Engine
Documentación oficial de producto sobre corpus, ingestión, recuperación y conexión de modelos con fuentes externas.
Consultar fuente - NVIDIA — RAG Blueprint
Referencia técnica complementaria para arquitecturas de recuperación y evaluación; no se utiliza como recomendación de stack concreto.
Consultar fuente
Los mecanismos de búsqueda, fragmentación, ranking, filtros, permisos, actualización y evaluación dependen del corpus, sistemas existentes, proveedor y caso de uso. Los ejemplos de esta guía son criterios de arquitectura y no una configuración universal de RAG.
