
AGENTES IA · EVALUACIÓN · AUTONOMÍA · TRAZAS · REGRESIONES
Cómo evaluar un agente de IA antes de darle más autonomía
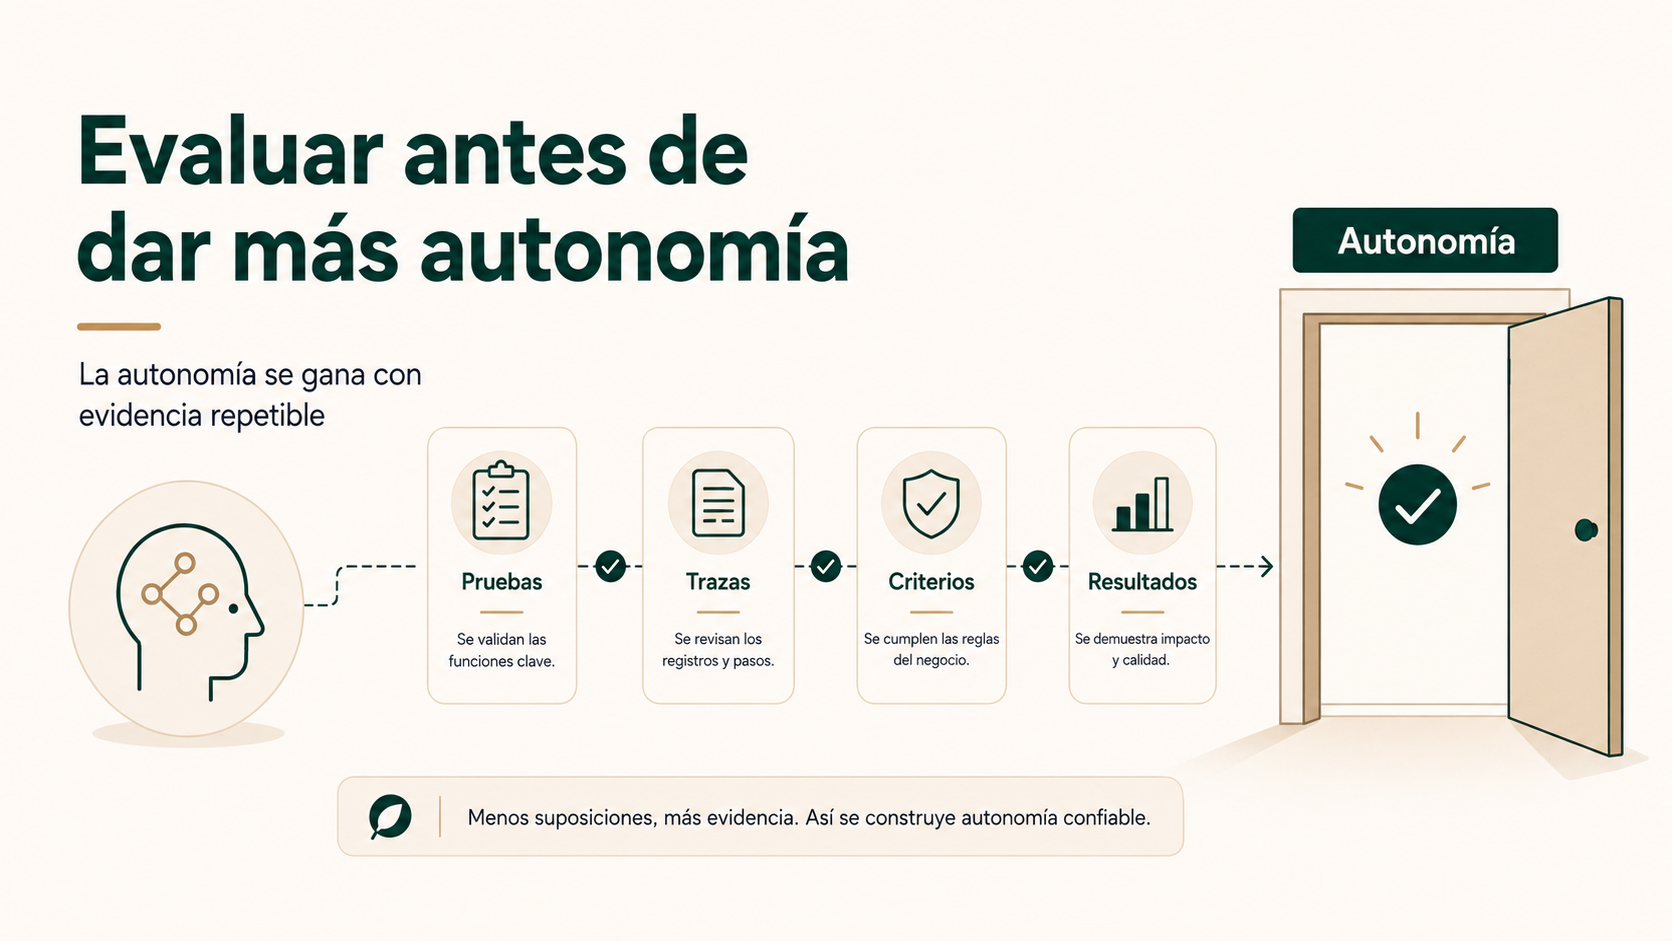
Un agente puede completar una demo impecable y seguir sin estar preparado para actuar con más autonomía en un proceso real. La diferencia no está en que “parezca inteligente”, sino en disponer de pruebas repetibles que indiquen qué tareas resuelve, dónde falla, cómo usa sus herramientas y qué ocurre cuando cambia algo.
La autonomía no se concede por una buena demo. Se gana con evidencia repetible.
Evaluar un agente de IA significa comprobar de forma repetible si puede resolver tareas reales respetando restricciones, permisos, herramientas, excepciones y criterios de cierre. No es lo mismo que conversar cinco minutos con él y concluir que “funciona”. La guía sobre permisos y credenciales desarrolla cómo limitar esas capacidades antes de conceder más autonomía.
En un agente, además, importa algo más que la respuesta final. Hay que poder observar qué herramientas utilizó, con qué argumentos, qué estado modificó, cuándo pidió ayuda y si realmente consiguió el resultado esperado.
La decisión de ampliar autonomía debería vincularse a capacidades concretas que han sido evaluadas, no a una impresión general sobre el modelo.
Una buena demo no es una evaluación
Imagine un agente que recibe un email, consulta el CRM, prepara una respuesta y crea una tarea para el comercial adecuado. En la demo todo ocurre correctamente: interpreta la intención, encuentra al cliente, actualiza el registro y redacta un mensaje convincente.
Ahora cambie una sola condición. El cliente tiene dos empresas con nombres parecidos. La herramienta de CRM devuelve un error temporal. El usuario solicita algo que el agente no tiene permiso para modificar. La información llega en otro idioma. O una nueva versión del prompt cambia el orden de las acciones.
La pregunta relevante deja de ser “¿puede hacerlo?” y pasa a ser “¿en qué condiciones podemos confiar en que lo haga correctamente y qué ocurre cuando esas condiciones no se cumplen?”.
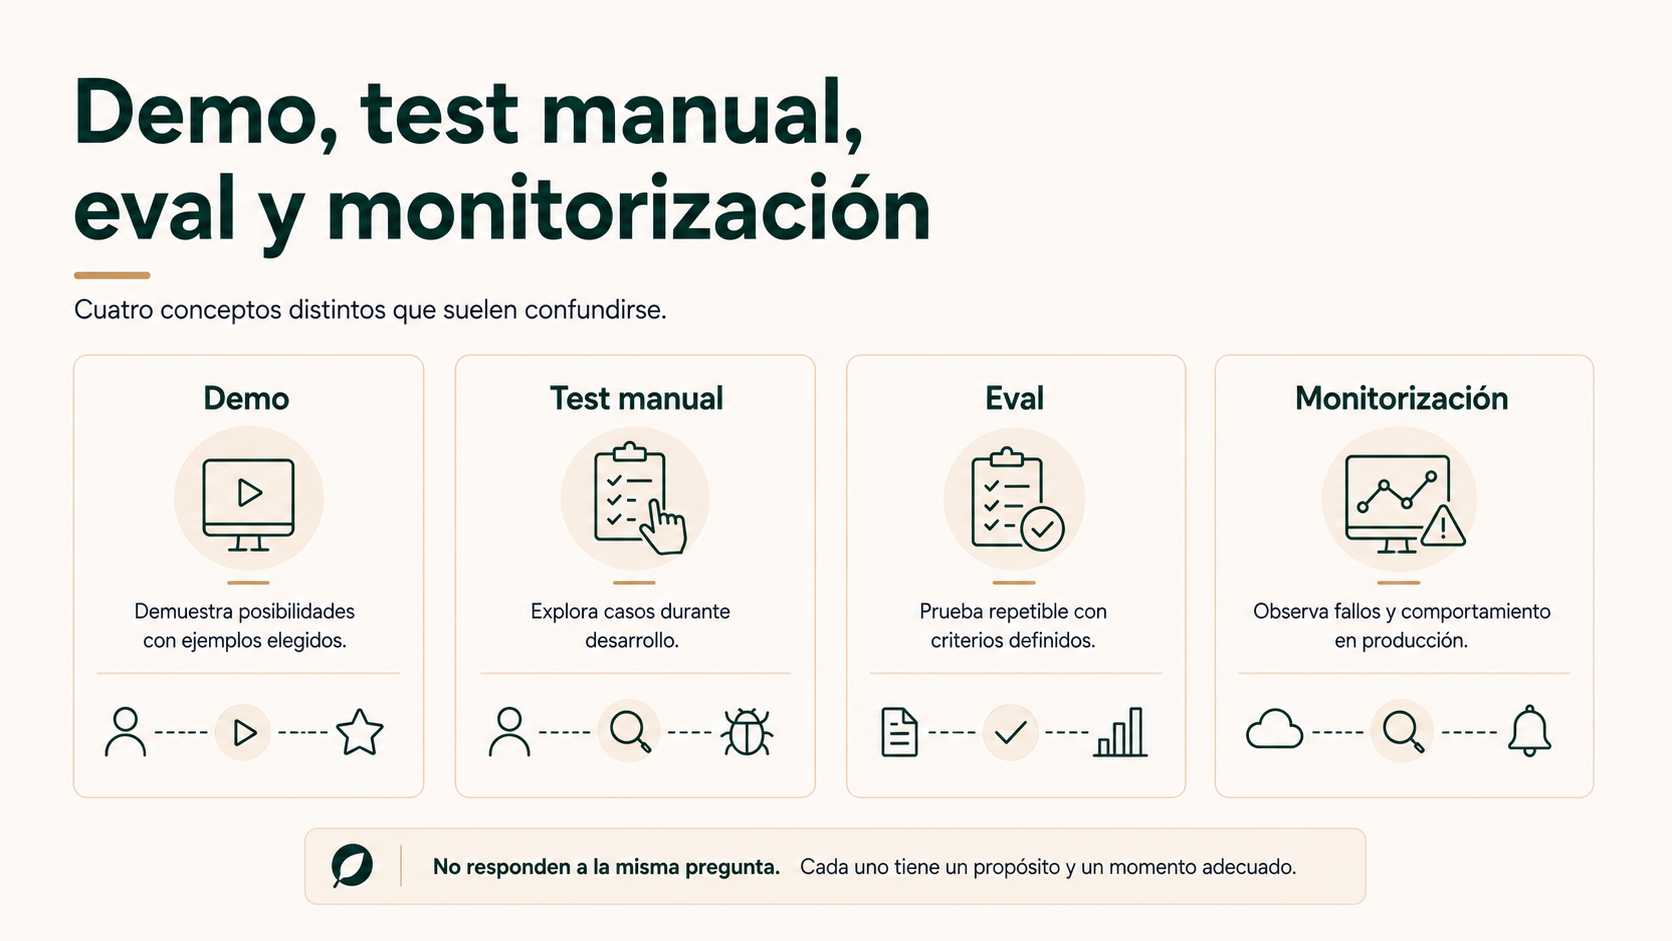
Demo
Demuestra que el sistema puede resolver determinados ejemplos seleccionados.
Test manual
Sirve para explorar durante desarrollo, pero resulta difícil repetirlo exactamente y comparar versiones.
Eval
Es una prueba repetible con casos y criterios definidos para medir una capacidad o comportamiento.
Monitorización
Observa el comportamiento ya desplegado: fallos reales, costes, latencia, incidencias y cambios de uso.
Las cuatro herramientas son útiles, pero responden a preguntas distintas. Una demo puede justificar seguir desarrollando. Una eval ayuda a decidir si una capacidad cumple criterios antes de ampliar su alcance. La monitorización detecta después problemas que el entorno controlado no había previsto.
Qué es una eval cuando el agente usa herramientas y toma varios pasos
La palabra eval aparece cada vez más en documentación técnica, pero para un decisor de negocio puede resultar innecesariamente opaca. Aquí la utilizamos como abreviatura de evaluación repetible de un sistema de IA: planteamos una tarea, ejecutamos el agente en condiciones definidas y comprobamos si cumple uno o varios criterios.
No estamos evaluando solo el modelo. Estamos evaluando el sistema completo: instrucciones, modelo, herramientas, permisos, memoria, integraciones, lógica de orquestación y entorno.
Cinco términos que conviene entender
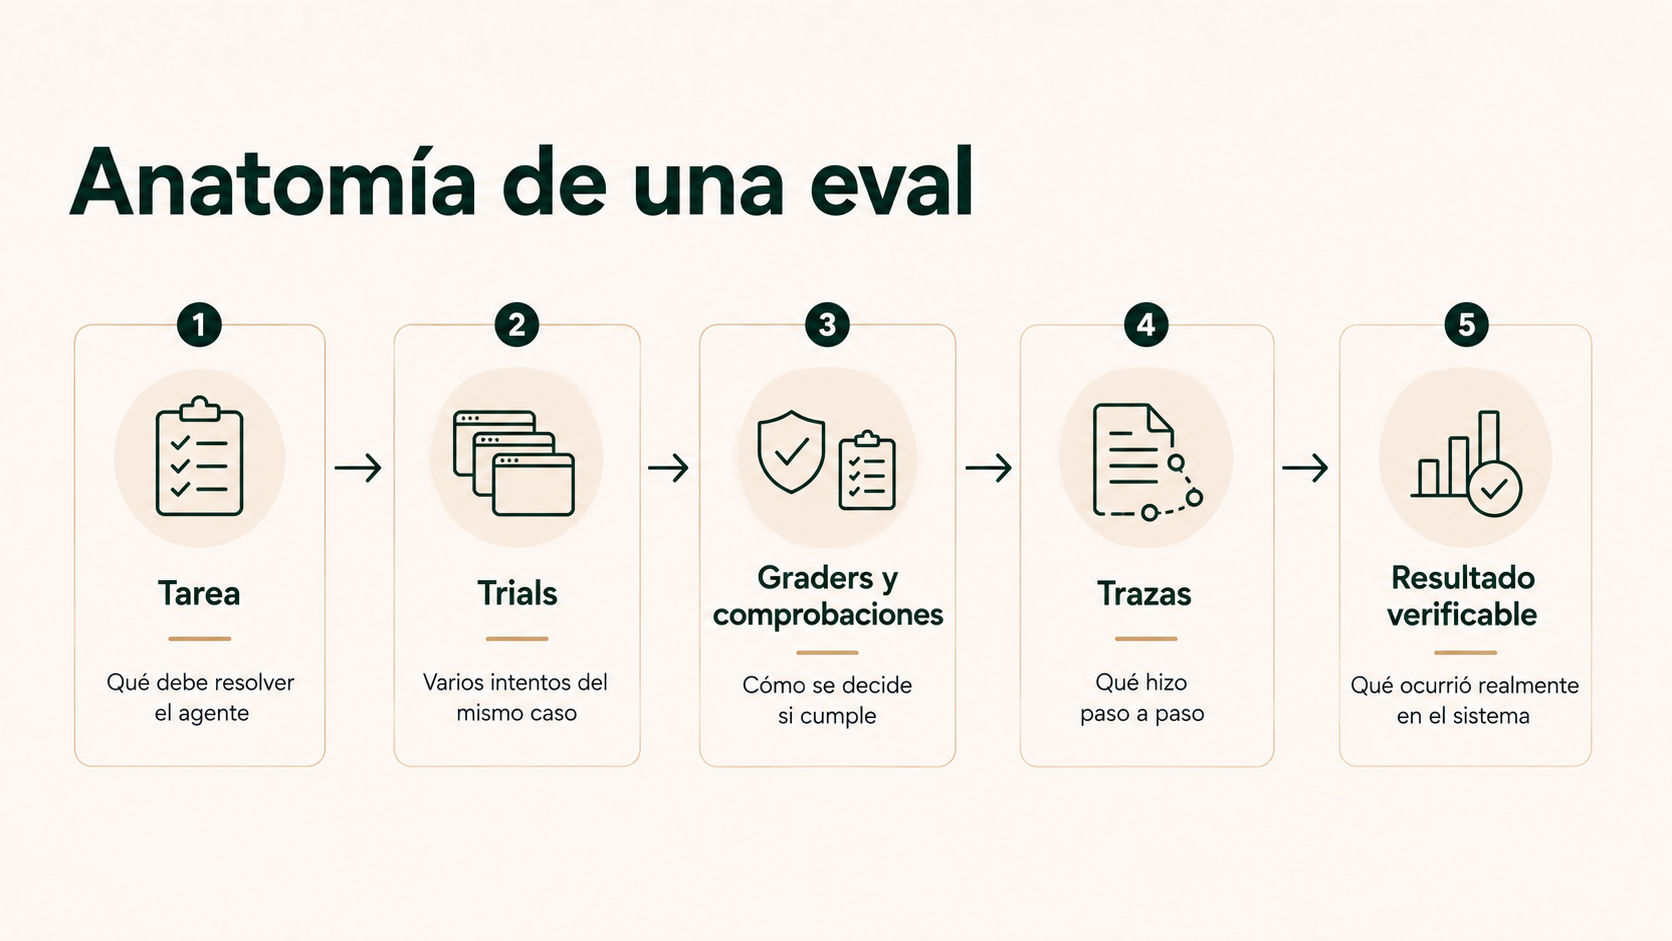
Tarea o caso de prueba: el escenario que queremos comprobar. Por ejemplo, “un cliente solicita cambiar la dirección de facturación, pero falta un dato obligatorio”. El caso debe definir qué información recibe el agente y qué consideramos una resolución correcta.
Trial o intento: una ejecución concreta de ese caso. El mismo caso puede ejecutarse varias veces porque los modelos generativos no producen siempre exactamente la misma salida.
Grader o mecanismo de evaluación: la forma de decidir si una dimensión ha sido correcta. Puede ser una regla de software, otro modelo de IA o una revisión humana.
Assertion o comprobación: una condición concreta que debe cumplirse. Ejemplo: “no debe modificarse el registro si falta autorización”. Una tarea puede tener varias comprobaciones.
Traza o trayectoria: el registro de lo que ocurrió durante la ejecución: qué decidió el agente, qué herramientas llamó, con qué datos, qué devolvieron esas herramientas y cómo terminó la tarea.
Hay además un sexto concepto especialmente importante: el resultado final. Un agente puede escribir “tarea creada correctamente”, pero el verdadero resultado debe comprobarse, cuando sea posible, en el sistema: ¿la tarea existe?, ¿está asociada al cliente correcto?, ¿tiene el responsable adecuado?, ¿se creó una sola vez?
Una evaluación útil no pregunta solo “¿qué dijo el agente?”. Pregunta “¿qué ocurrió realmente y respetó los controles mientras ocurría?”.
Antes de evaluar, defina el contrato de la tarea
El error más habitual es construir casos de prueba antes de definir qué significa exactamente “hacerlo bien”. Si dos personas del equipo pueden discutir durante diez minutos sobre si una ejecución debería aprobar o suspender, probablemente el criterio todavía es demasiado ambiguo.
Para cada capacidad conviene especificar:
- Qué entrada recibe el agente;
- Qué resultado debe conseguir;
- Qué acciones puede ejecutar;
- Qué acciones están prohibidas;
- Qué herramientas tiene disponibles;
- Qué datos y permisos puede utilizar;
- Cuándo debe pedir información;
- Cuándo debe escalar a una persona;
- Qué significa que la tarea está realmente terminada;
- Qué evidencia permite comprobarlo;
- Qué errores son tolerables y cuáles bloquean el despliegue.
Este “contrato” no tiene que convertirse en un documento jurídico. Es una especificación operativa. Su valor está en transformar expresiones vagas —“debe responder bien”, “debe ser prudente”, “debe saber usar el CRM”— en comportamientos observables.
Ejemplo: para un agente que actualiza datos en un CRM, “funciona bien” es una especificación pobre. “Identifica el registro correcto, solicita confirmación cuando existen dos coincidencias, modifica solo los campos permitidos, no crea duplicados y verifica el estado final” ya permite construir pruebas.
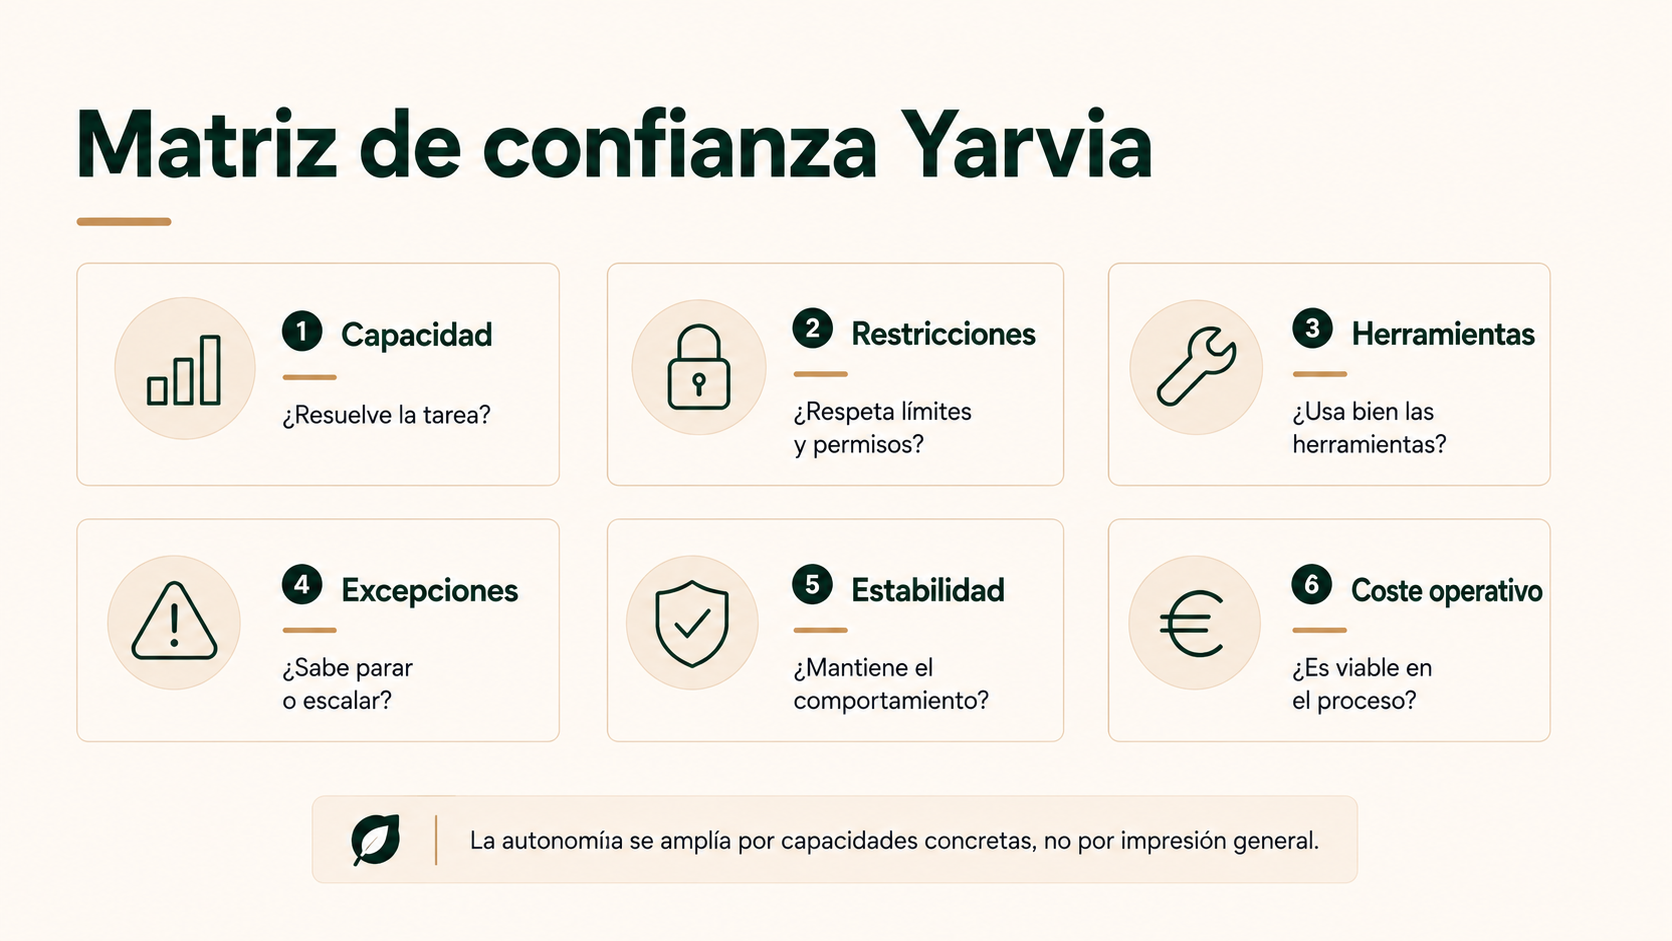
La Matriz de confianza Yarvia: seis evidencias antes de ampliar autonomía
Para estructurar la decisión proponemos una matriz editorial propia. No pretende ser un estándar universal, sino una forma práctica de impedir que la conversación sobre autonomía se reduzca a una puntuación agregada.
1. Capacidad
¿Resuelve la tarea correcta y alcanza un resultado verificable en los escenarios que importan?
2. Restricciones
¿Respeta permisos, políticas, límites y acciones prohibidas incluso cuando la petición parece razonable?
3. Herramientas
¿Elige la herramienta adecuada, utiliza argumentos correctos y verifica el efecto real de la acción?
4. Excepciones
¿Sabe parar, pedir información, reintentar de forma segura o escalar cuando no puede continuar?
5. Estabilidad
¿Mantiene el comportamiento entre varios intentos y después de cambios de modelo, prompt o herramientas?
6. Coste operativo
¿Coste, latencia e intervención humana son compatibles con el proceso sin sacrificar controles importantes?
La salida no debería ser “el agente es fiable” en abstracto. Debe ser algo más concreto: “esta capacidad puede pasar de recomendar a ejecutar esta acción acotada bajo estos controles”.
Esto enlaza con el criterio de mínima autonomía suficiente: no buscamos que el agente haga todo lo posible, sino que asuma únicamente el nivel de decisión y acción que aporta valor y está respaldado por evidencia.
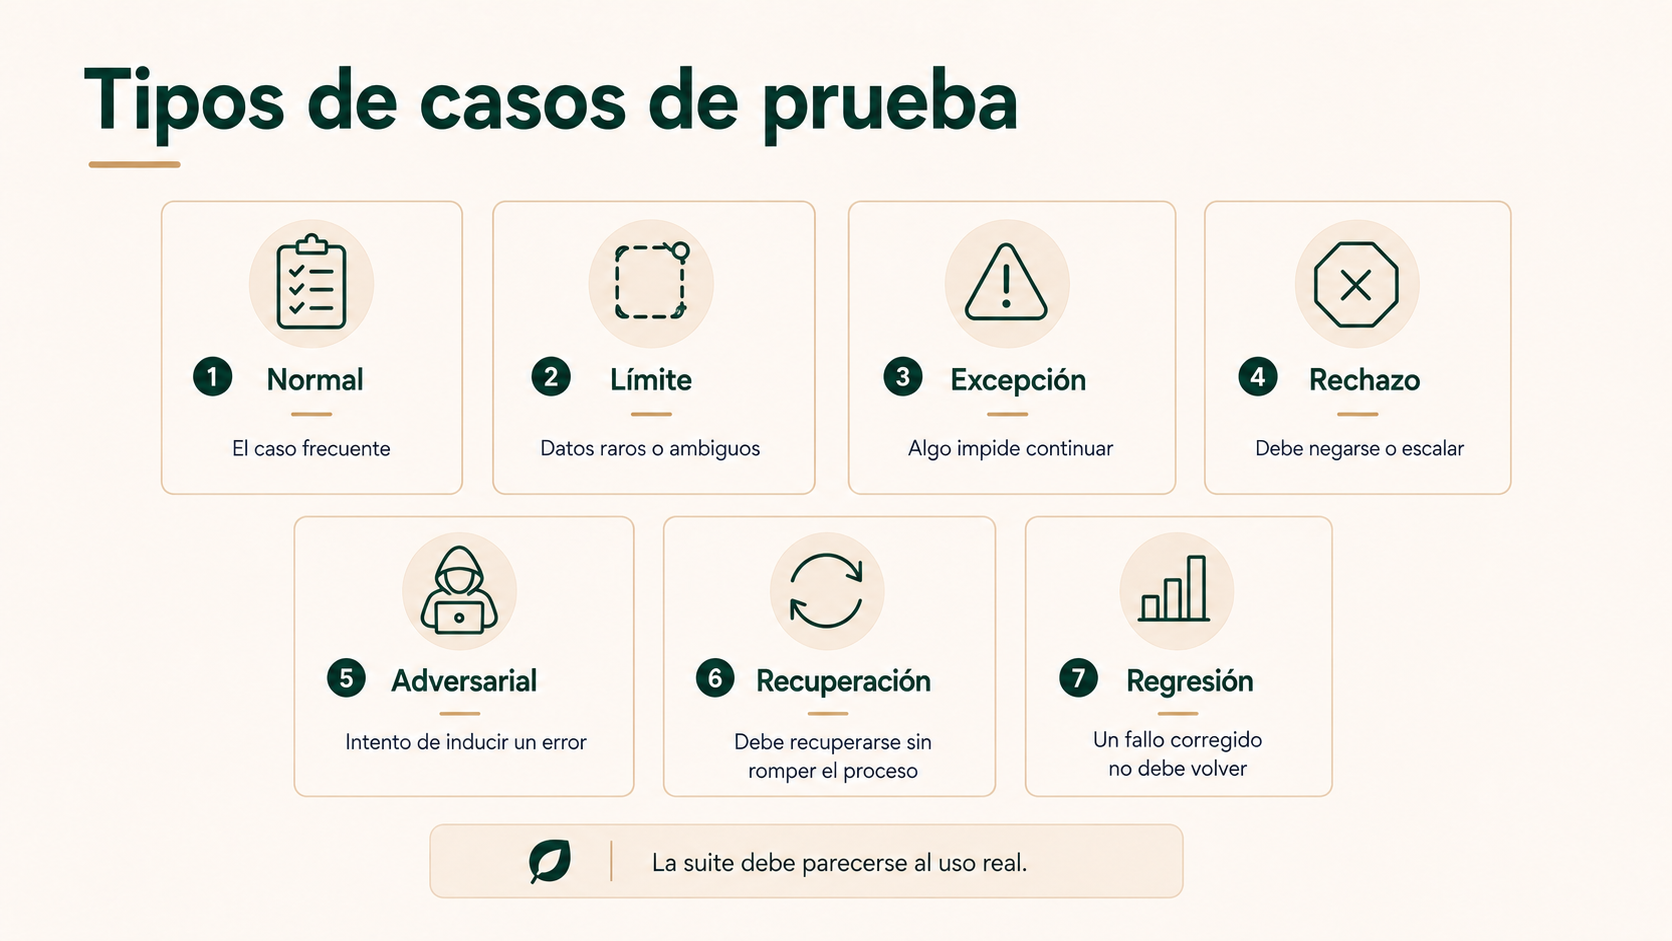
Casos normales, casos límite, excepciones y rechazos: la suite debe parecerse al mundo real
Una suite de evaluación es simplemente el conjunto de casos que utilizamos para comprobar una o varias capacidades. Si solo contiene ejemplos cómodos, su puntuación puede ser excelente y no decir prácticamente nada sobre producción.
| Tipo de caso | Qué busca comprobar | Ejemplo B2B |
|---|---|---|
| Normal | El escenario frecuente y representativo. | El agente recibe una solicitud completa y crea correctamente una tarea. |
| Caso límite | Valores raros, entradas incompletas o combinaciones poco frecuentes. | Existen dos clientes con nombres casi idénticos. |
| Excepción | Una dependencia o herramienta impide continuar normalmente. | El ERP no responde o devuelve información contradictoria. |
| Rechazo | El agente debe negarse o escalar. | El usuario pide modificar un dato para el que el agente no tiene permiso. |
| Adversarial | Alguien intenta inducir una acción no autorizada. | Un documento externo contiene instrucciones que intentan alterar el comportamiento del agente. |
| Recuperación | El sistema falla y debe recuperarse correctamente. | Una llamada a herramienta expira y el agente debe reintentar o escalar sin duplicar la operación. |
| Regresión | Un fallo ya corregido no debe reaparecer. | Una nueva versión vuelve a crear tareas duplicadas en un caso que antes estaba resuelto. |
No existe un reparto universal —por ejemplo, “30 % de casos límite”— que sirva para todos los agentes. La cobertura debe responder al uso real, al impacto del error, al tipo de herramientas y al riesgo de cada proceso.
Cuando ya hay producción, los fallos reales son una fuente especialmente valiosa. Un incidente relevante puede convertirse en un caso reproducible que permanezca para siempre en la suite.
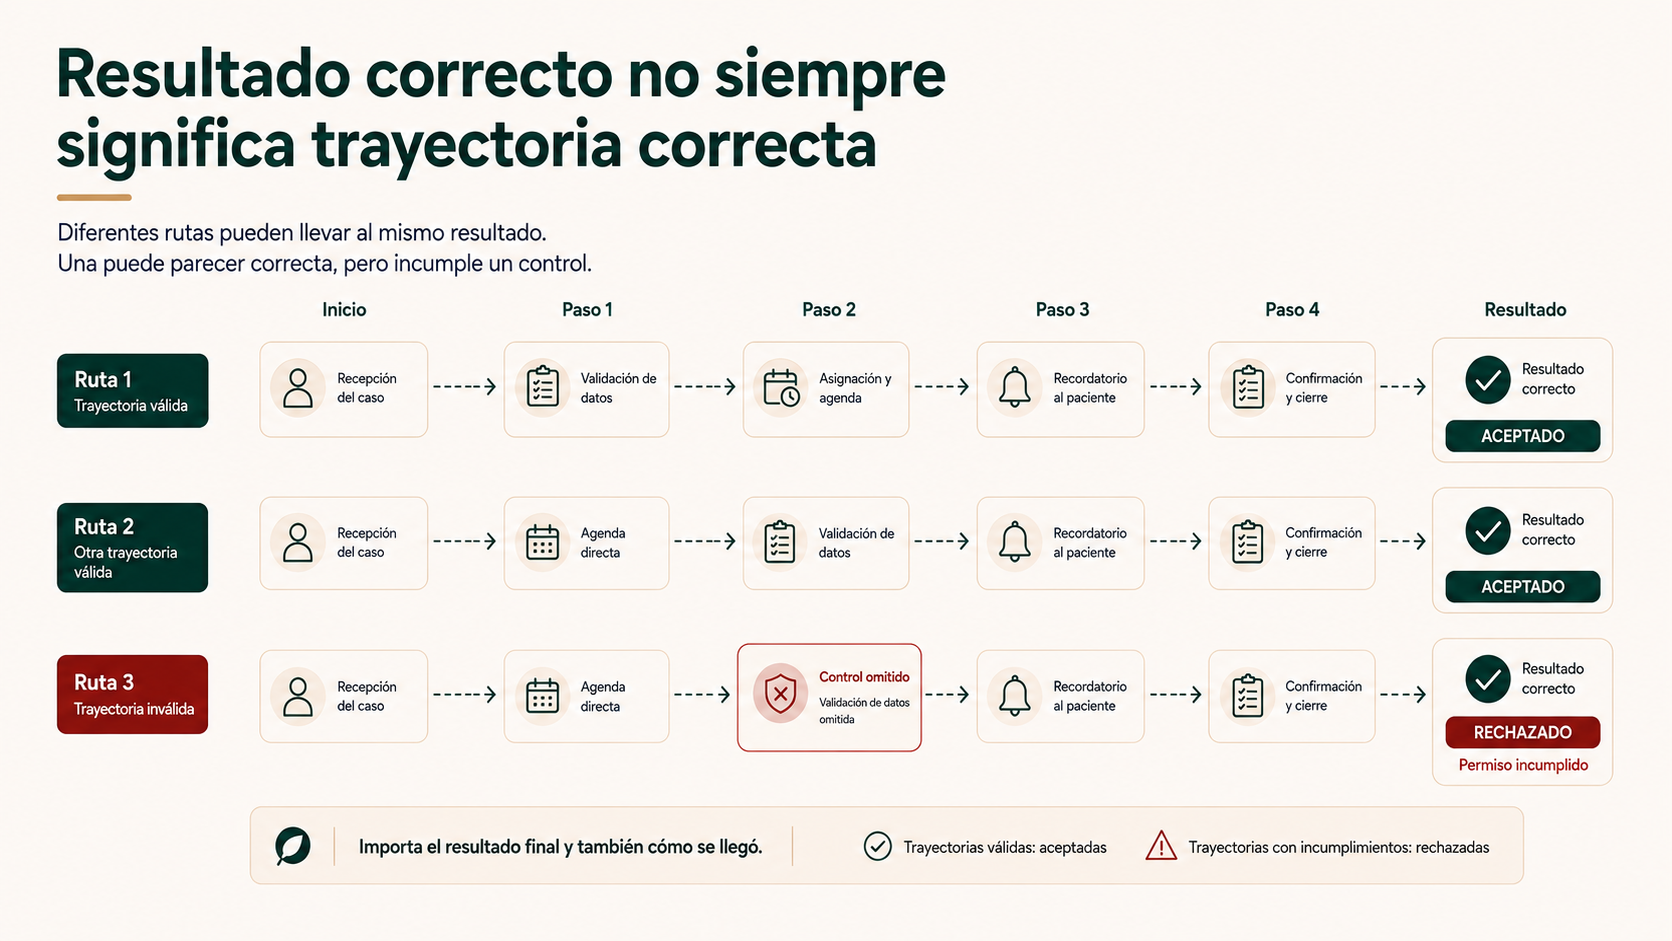
No basta con mirar la respuesta final: resultado y trayectoria son cosas distintas
Los agentes pueden resolver una misma tarea siguiendo rutas diferentes. Eso obliga a evitar dos errores opuestos.
El primero es penalizar cualquier ruta que no coincida exactamente con la secuencia imaginada por el diseñador. Si dos trayectorias son válidas y terminan en el mismo estado correcto, no tiene sentido suspender una por ser distinta.
El segundo error es el contrario: mirar solo el resultado final y no detectar que el agente violó un control obligatorio durante el camino.
Resultado correcto, trayectoria incorrecta
Supongamos que el agente termina actualizando correctamente una ficha de cliente. La tarea parece resuelta. Pero durante el proceso descargó información que no necesitaba, utilizó una herramienta sin permiso o modificó primero el registro equivocado y luego lo corrigió.
El estado final puede ser correcto y la ejecución seguir siendo inaceptable.
Por eso conviene separar:
- Resultado: qué estado o entregable final quedó realmente;
- Trayectoria: cómo llegó el sistema hasta ese resultado;
- Controles obligatorios: qué pasos o restricciones no pueden omitirse, aunque existan otras rutas posibles.
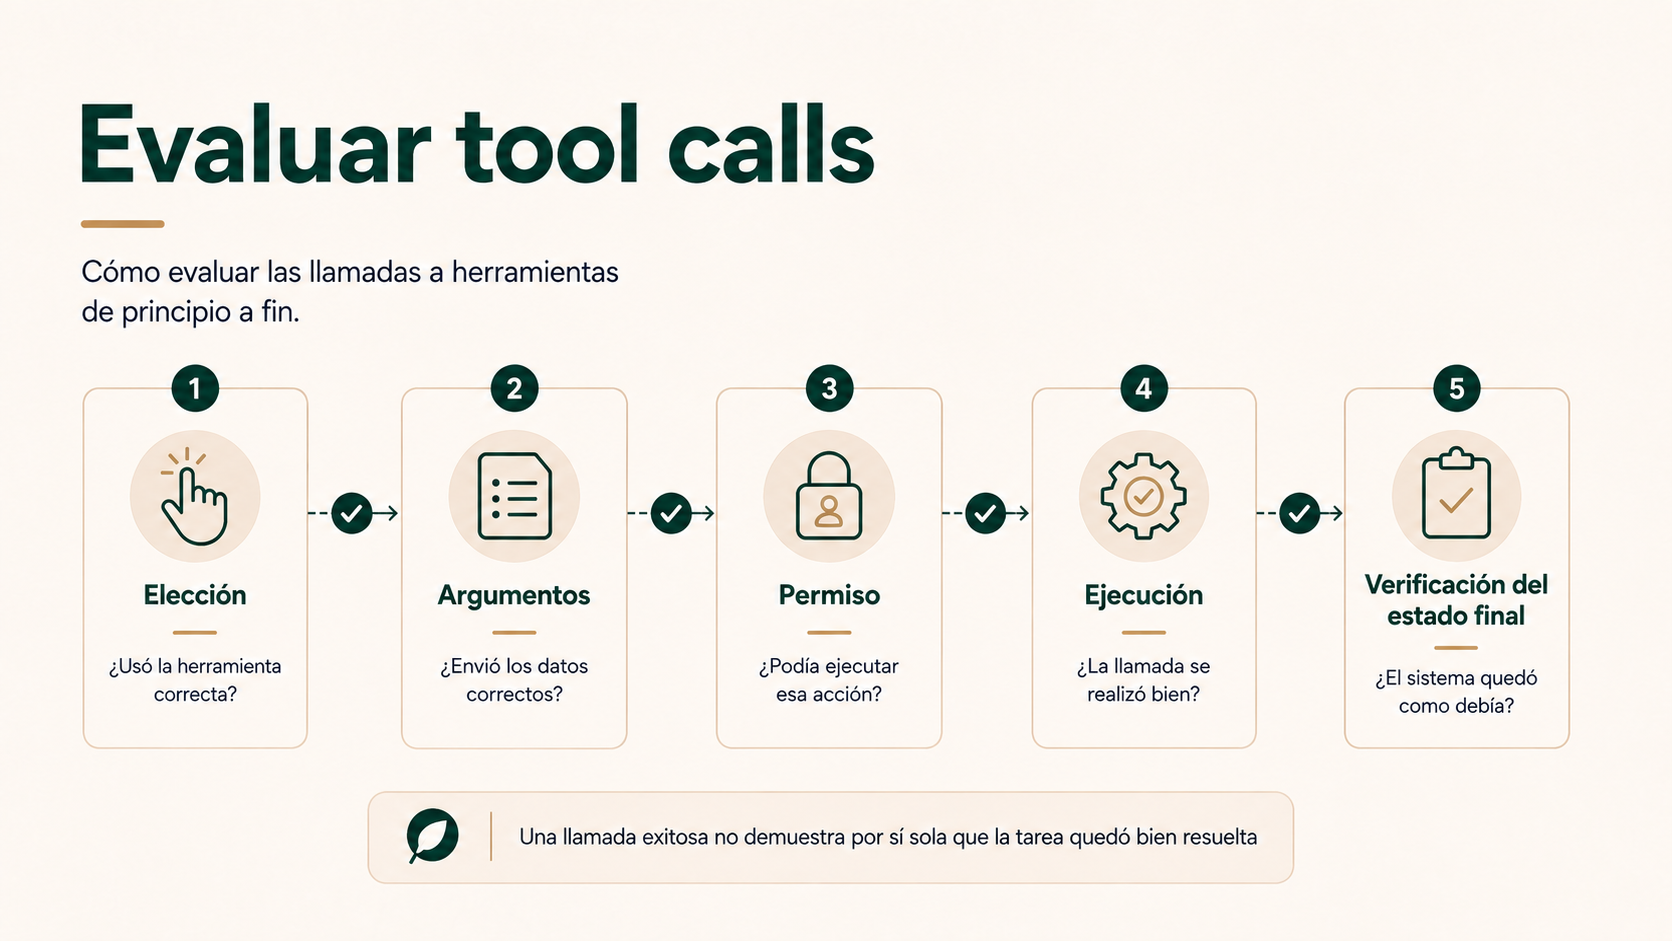
Qué son las tool calls y cómo se evalúan
Una de las diferencias entre un chatbot convencional y muchos agentes es su capacidad para usar herramientas. Una tool call, o llamada a una herramienta, es una petición estructurada que el agente realiza a una función o sistema externo para hacer algo que el modelo por sí solo no puede ejecutar.
Por ejemplo, el agente puede llamar a una herramienta para consultar el CRM, crear una cita, leer una factura, buscar un pedido en el ERP o enviar un email. El modelo decide qué herramienta utilizar y qué argumentos enviar; la aplicación ejecuta la acción y devuelve un resultado.
1. Elección: ¿seleccionó la herramienta adecuada?
2. Argumentos: ¿envió el cliente, fecha, importe o identificador correctos?
3. Permiso y secuencia: ¿tenía autorización y respetó los controles obligatorios antes de ejecutar?
4. Efecto final: ¿el sistema externo quedó realmente en el estado esperado?
Este último punto es esencial. Una herramienta puede responder “200 OK” o “operación completada” y que la tarea de negocio no esté bien resuelta. Puede haberse modificado el registro equivocado, creado una cita duplicada o guardado un dato incompleto.
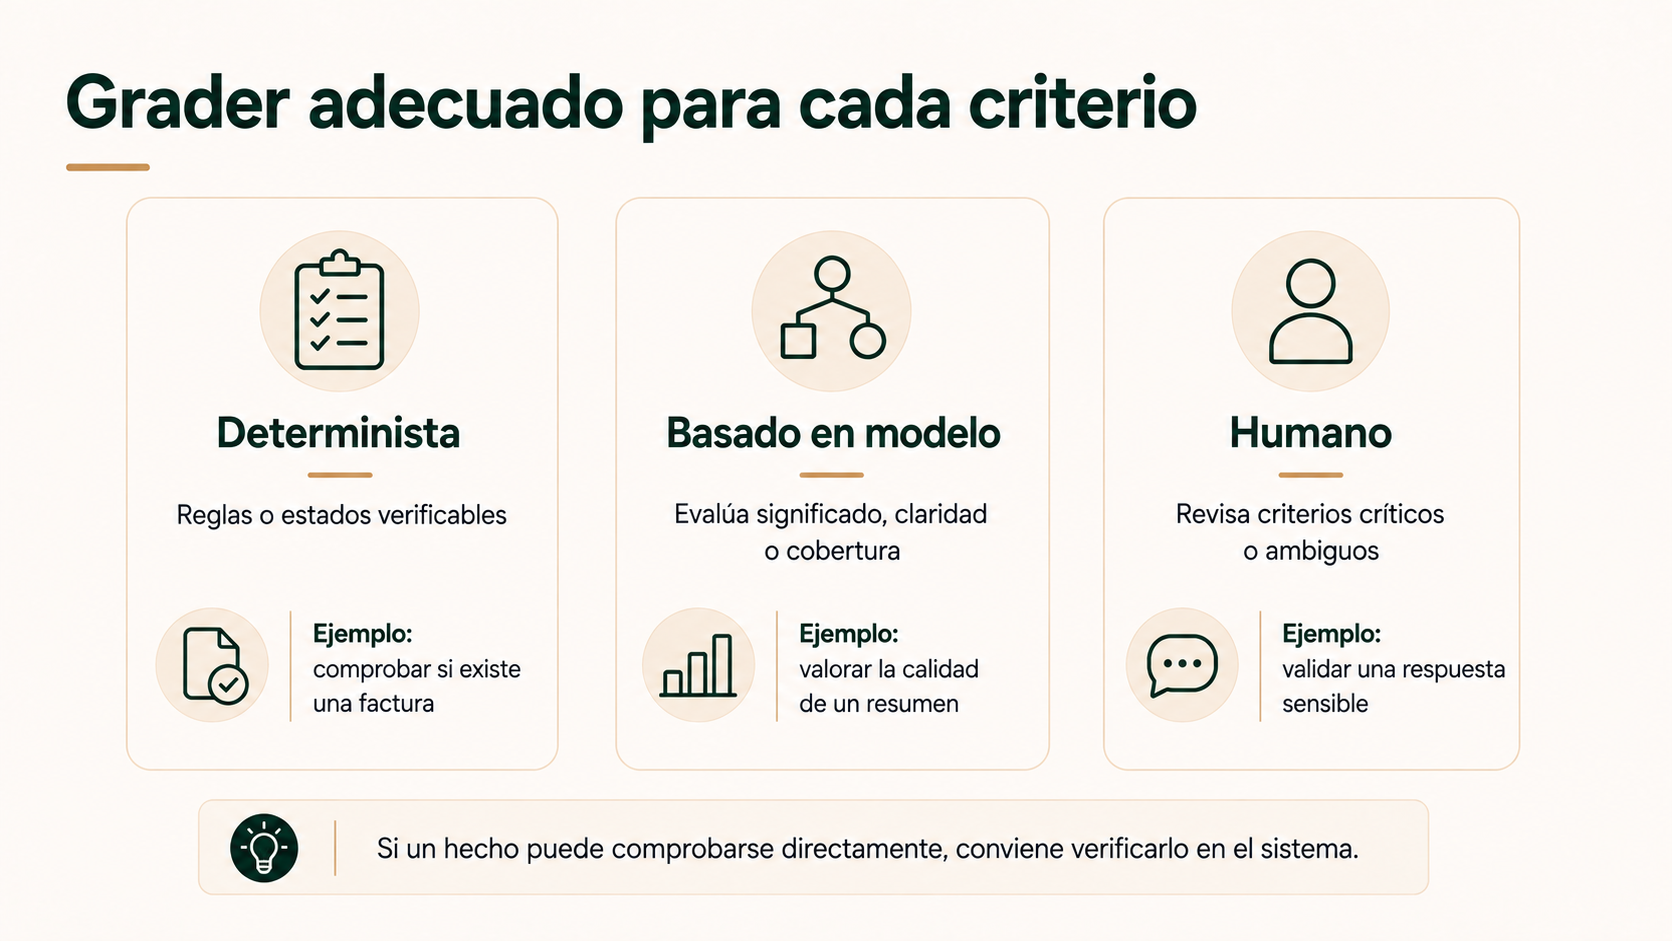
Cuando el resultado puede verificarse de forma determinista, hay que comprobarlo directamente. Es mejor consultar si la cita existe que pedir a otro modelo que opine sobre si probablemente fue creada.
Qué grader utilizar: reglas, IA o revisión humana
Un grader es el mecanismo que evalúa una dimensión del resultado o de la trayectoria. No hay un único tipo adecuado para todo.
Determinista
Utiliza reglas verificables: coincidencia exacta, esquema válido, consulta al sistema, test, expresión regular o regla de negocio. Si un hecho puede comprobarse directamente, suele ser la primera opción.
Basado en modelo
Otro modelo de IA evalúa aspectos difíciles de reducir a reglas: claridad, cobertura, adecuación semántica, calidad de una explicación o tono.
Humano
Una persona revisa criterios subjetivos, de alto impacto o aquellos en los que todavía necesitamos calibrar qué significa “correcto”.
Qué significa LLM-as-a-judge
LLM-as-a-judge significa utilizar un modelo de lenguaje como evaluador de la salida de otro sistema de IA. En español, podemos hablar simplemente de evaluación mediante otro modelo.
Puede ser útil cuando la calidad no cabe en una regla exacta. Por ejemplo: ¿la respuesta explica correctamente una política?, ¿el resumen conserva los datos esenciales?, ¿el tono es profesional?, ¿la contestación está bien fundamentada en las fuentes proporcionadas?
Pero un modelo evaluador no es un árbitro infalible. Para utilizarlo con sentido necesita:
- Una rúbrica clara: qué dimensiones debe evaluar y qué significa cada nivel;
- Ejemplos de casos buenos, malos y fronterizos cuando sean necesarios;
- Comparación periódica con criterio humano;
- Versionado del modelo, prompt y rúbrica cuando queremos comparar resultados en el tiempo;
- Una salida como “no se puede determinar” cuando no tiene información suficiente.
Aquí la IA sí puede reducir mucho trabajo de evaluación
La IA puede ayudar a clasificar fallos, resumir trazas largas, proponer nuevos casos a partir de incidencias, evaluar criterios semánticos y detectar patrones entre cientos de ejecuciones. En proyectos con agentes, esta capa puede convertir una revisión manual imposible de escalar en un proceso de evaluación mucho más sistemático.
Pero debe utilizarse donde aporta interpretación. Si necesitamos saber si existe una factura, si una cita se duplicó o si un campo concreto cambió, lo adecuado es comprobar el sistema directamente.
Por qué hay que repetir pruebas: trials, pass rate, pass@k y pass^k
Los sistemas generativos pueden producir resultados diferentes ante el mismo caso. Por eso una única ejecución puede dar una falsa sensación de seguridad o de fracaso.
Un trial es simplemente un intento. Si ejecutamos el mismo caso varias veces, podemos observar hasta qué punto el comportamiento es estable.
No existe un número universal de repeticiones. Dependerá de la variabilidad, el coste de ejecutar la prueba, la criticidad de la acción y la precisión que necesitemos para decidir.
Tres métricas que pueden aparecer en evaluación
Pass rate: porcentaje de intentos que cumplen los criterios definidos. Si se ejecutan 20 trials y 18 aprueban, el pass rate de ese conjunto es 90 %.
Pass@k: mide si, permitiendo varios intentos, al menos uno consigue resolver el caso. Es útil en tareas donde reintentar forma parte del diseño.
Pass^k: se utiliza para expresar una exigencia de consistencia: que una serie de intentos cumpla el criterio. La convención exacta debe explicarse cuando se use, porque no es una métrica que debamos presentar como universal.
Para un decisor empresarial, la diferencia práctica es sencilla. “Alguna vez consigue hacerlo” y “lo hace de forma consistente” son preguntas distintas.
En una tarea exploratoria, encontrar una solución válida entre varios intentos puede ser suficiente. En una acción que modifica un sistema de producción, una tasa de acierto esporádica puede ser inaceptable.
Un promedio alto puede ocultar un error crítico
Supongamos que un agente supera 95 de 100 pruebas. La cifra parece buena. Pero si los cinco fallos consisten en modificar el cliente equivocado, saltarse una autorización o confirmar acciones que no se ejecutaron, el promedio deja de ser tranquilizador.
Por eso la suite debe separar errores críticos, graves, recuperables y menores según el proceso. La severidad no puede esconderse dentro de una media.
Regresiones: cuando mejorar una cosa rompe otra
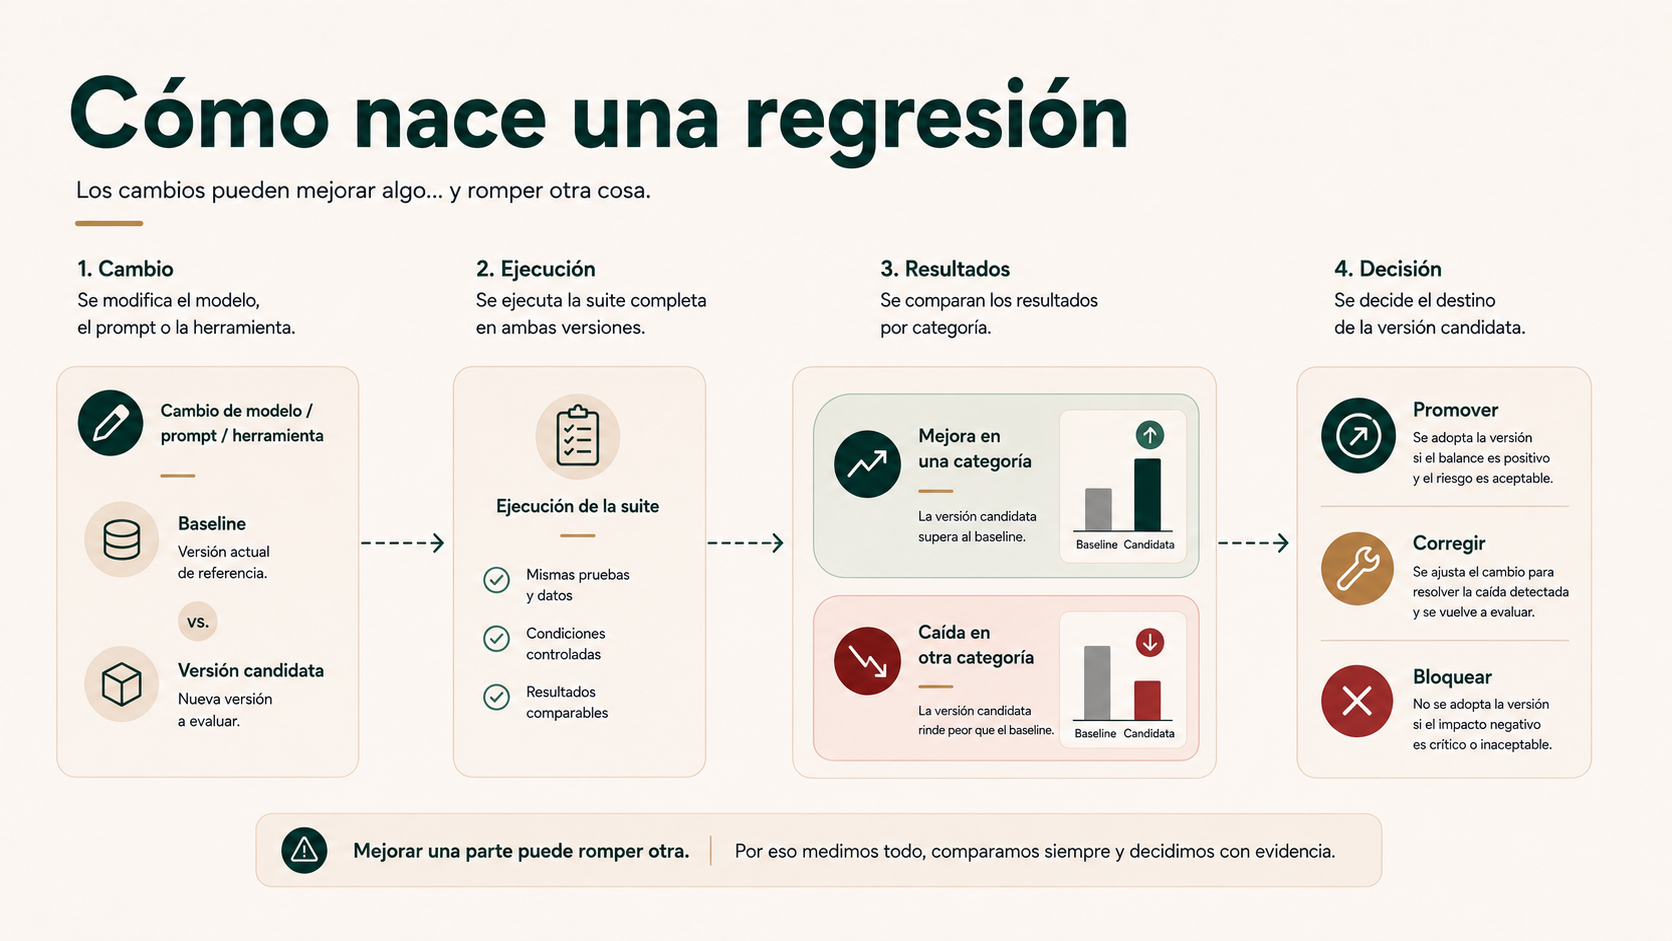
Una regresión aparece cuando una capacidad que antes cumplía los criterios deja de hacerlo después de un cambio.
Puede ocurrir al sustituir el modelo, modificar el prompt, añadir una herramienta, cambiar permisos, ampliar el contexto, alterar la memoria, ajustar una integración o modificar la forma en que se recupera información.
Sin una suite estable, el equipo puede corregir un fallo visible y crear otro silenciosamente.
Versión A: establece la referencia o baseline.
Cambio: nuevo modelo, prompt, herramienta o configuración.
Versión B: ejecuta la misma suite en condiciones comparables.
Análisis: revisar mejora, regresión y trade-offs por categorías.
Decisión: promover, corregir o bloquear el cambio.
El baseline es la versión de referencia con la que comparamos una candidata. No tiene por qué ser perfecta; simplemente necesitamos una línea de partida conocida.
La comparación no debería reducirse a “87 frente a 89 puntos”. Conviene mirar qué categorías suben, cuáles bajan, si aparecen fallos críticos nuevos, cómo cambia la variabilidad y si el coste o la latencia empeoran.
Un fallo real que ya fue corregido debería valorarse como candidato a prueba permanente. De esa manera, la suite acumula memoria operativa del sistema.
Autonomía guiada por evaluación: de recomendar a actuar
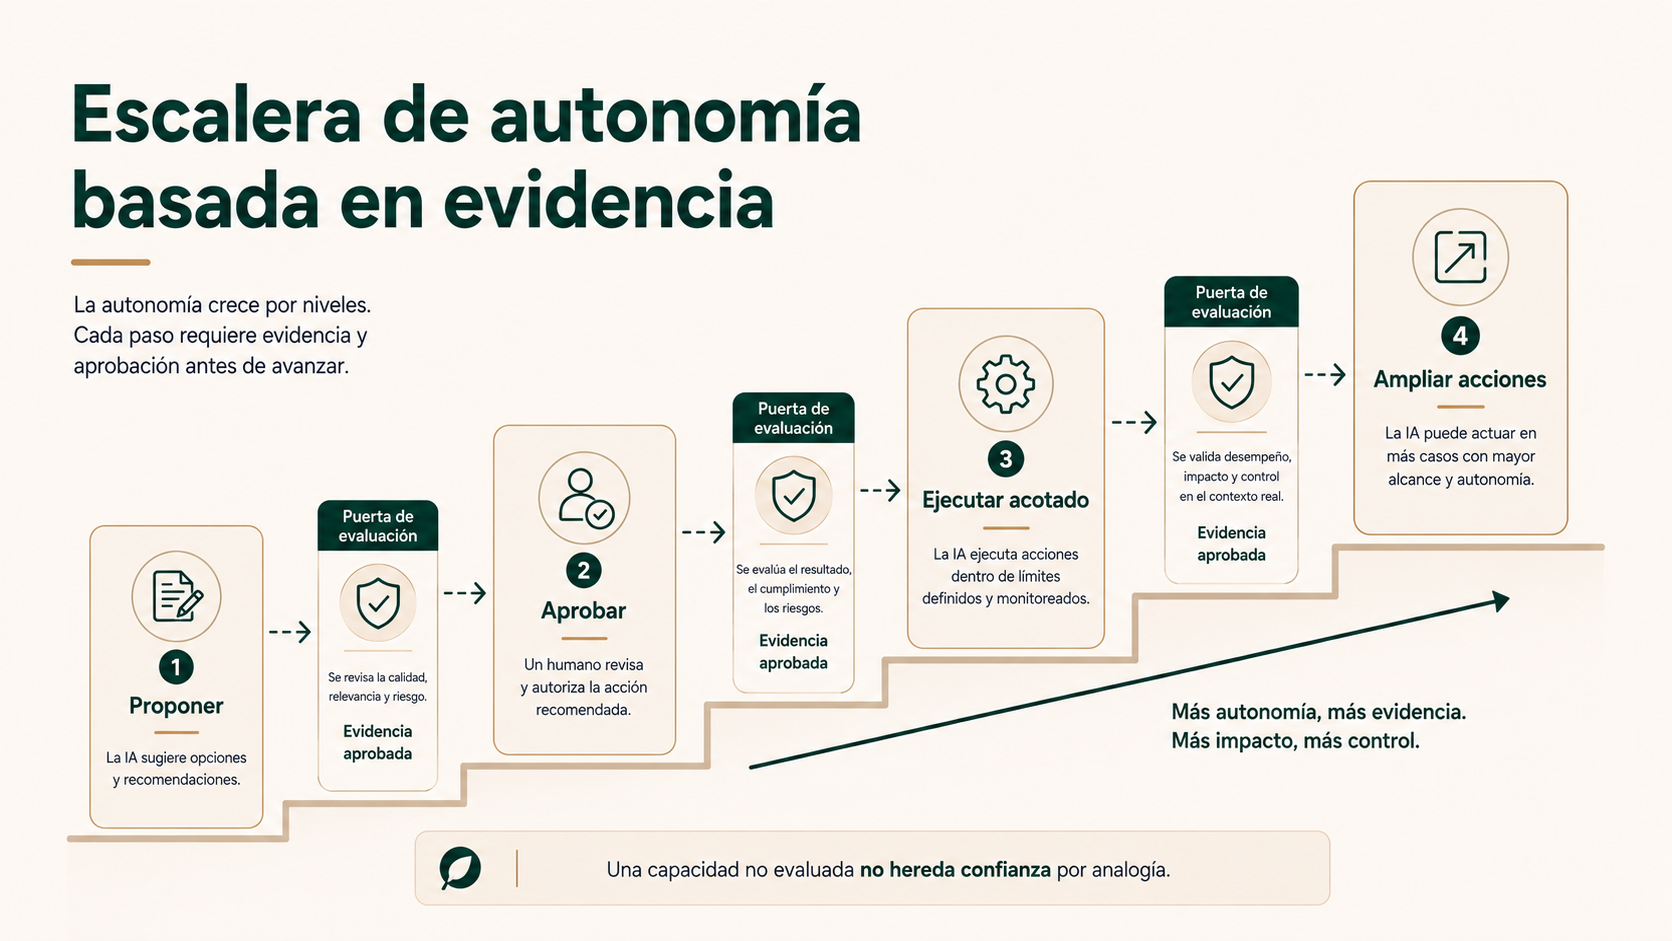
En este artículo utilizamos el término inglés eval-driven autonomy. Para un lector no técnico es más claro hablar de autonomía guiada por evaluación: el alcance del agente aumenta solo cuando existen pruebas suficientes sobre las capacidades concretas que va a asumir.
No significa que una suite “certifique” al agente. Significa que la decisión de darle más capacidad de acción deja de basarse en intuición y se apoya en evidencia repetible.
Propone
El agente analiza y responde, pero no modifica sistemas críticos.
Recomienda una acción
Prepara la acción y una persona decide si se ejecuta.
Ejecuta acciones acotadas
Puede actuar sobre tareas reversibles o claramente delimitadas bajo controles.
Amplía tipos de acción
Gana alcance únicamente en capacidades que han sido específicamente evaluadas.
Opera con mayor iniciativa
Mantiene límites, observabilidad, escalados y criterios de bloqueo.
Los niveles son orientativos; no constituyen un estándar universal. La regla importante es otra: una capacidad no evaluada no hereda confianza por analogía. Que un agente gestione bien consultas de estado no demuestra que pueda modificar datos, autorizar devoluciones o enviar comunicaciones externas sin revisión.
¿Cuándo bloquear una ampliación?
Cuando aparece un fallo crítico nuevo, una regresión importante, errores de permisos o herramientas, falta de trazabilidad suficiente, mayor autonomía sin mayor verificabilidad o costes y latencias incompatibles con el proceso.
Qué debe pasar antes de llevar una nueva versión a producción
Las evals offline —ejecutadas en un entorno controlado— y la monitorización de producción se complementan. Ninguna sustituye a la otra.
Antes del despliegue, la suite permite comparar versiones sin exponer el cambio directamente a usuarios o sistemas reales. Después del despliegue, la producción aporta algo imposible de reproducir por completo: distribución real de casos, entradas inesperadas, combinaciones nuevas, incidencias de infraestructura y cambios de comportamiento de los usuarios.
Las trazas son la caja negra del proceso
Una traza registra qué pasó durante la ejecución. Dependiendo de la arquitectura puede incluir generaciones del modelo, llamadas a herramientas, resultados, handoffs —traspasos entre agentes o roles—, controles, errores y cambios de estado.
OpenAI, por ejemplo, documenta tracing integrado en su Agents SDK para registrar generaciones, tool calls, handoffs, guardrails y eventos personalizados. Es un ejemplo de capacidad de plataforma, no una definición universal de cómo debe implementarse la observabilidad.
La traza permite reconstruir por qué falló una tarea y convertir ese fallo en un nuevo caso de evaluación. Pero también contiene potencialmente información sensible, por lo que debe diseñarse con minimización, permisos y retención adecuados.
La intervención humana también se mide
La intervención humana no debería contabilizarse simplemente como “mala” porque queremos automatizar más. Hay intervenciones previstas por diseño —una aprobación obligatoria— y otras que aparecen porque el agente falló o no supo resolver una excepción.
Separar ambos motivos permite responder una pregunta más útil: ¿la autonomía actual está funcionando como fue diseñada o las personas están corrigiendo continuamente al agente?
Coste y latencia forman parte de la decisión
Un agente puede resolver correctamente una tarea y seguir siendo inviable si necesita demasiadas llamadas al modelo, demasiadas herramientas, mucho tiempo o demasiada revisión humana.
Eso no significa optimizar siempre para “menos tokens” o “menos humanos”. Significa evaluar si el coste operativo es compatible con el valor del proceso sin degradar controles importantes para abaratarlo.
Dónde puede ayudar especialmente la IA en el propio proceso de evaluación
- Convertir incidentes en candidatos a casos de prueba, extrayendo el patrón del fallo para que el equipo lo formalice.
- Clasificar cientos de fallos por categoría para detectar dónde se concentra el problema.
- Resumir trazas extensas y señalar pasos potencialmente relevantes para revisión.
- Evaluar dimensiones semánticas mediante graders basados en modelo cuando una regla exacta no es suficiente.
- Generar variantes de casos para ampliar cobertura, siempre revisadas para evitar casos irreales o ambiguos.
- Comparar versiones cualitativamente y explicar qué tipos de comportamiento han cambiado.
La IA acelera la evaluación; no elimina la necesidad de diseñar correctamente los criterios.
El NIST AI Risk Management Framework y su perfil para IA generativa pueden aportar una referencia institucional para pensar en testing, evaluation, verification and validation. Es importante no presentarlos como obligación legal: el AI RMF es un marco de uso voluntario.
Qué revisaría Yarvia en una auditoría de un agente
Antes de ampliar el alcance de un agente, revisaríamos el sistema desde el proceso de negocio y no únicamente desde el modelo utilizado.
- Qué tareas puede ejecutar hoy y cuáles debería poder ejecutar.
- Qué resultado verificable define el éxito de cada capacidad.
- Qué herramientas utiliza y qué permisos tienen.
- Qué acciones son reversibles y cuáles tienen mayor impacto.
- Qué casos normales, límite, rechazos y excepciones están cubiertos.
- Qué fallos reales deberían convertirse en regresiones permanentes.
- Qué puede verificarse con reglas y estados en lugar de con otro LLM.
- Qué criterios semánticos necesitan grader basado en modelo o revisión humana.
- Qué trazas existen y si permiten reconstruir fallos sin registrar datos innecesarios.
- Qué porcentaje de intervención humana es diseño previsto y cuál aparece por fallo.
- Cómo se comparan versiones candidatas con una baseline.
- Qué criterio concreto permitiría ampliar autonomía y qué fallo la bloquearía.
Un agente preparado para producción no es el que impresiona más en una demo. Es el que dispone de una frontera clara entre lo que ha demostrado que puede hacer y aquello que todavía debe permanecer limitado.
Si su empresa ya tiene un agente funcionando, pero no existe una suite capaz de indicar qué tareas resuelve, dónde falla, qué cambios introducen regresiones y qué acciones pueden ampliarse con evidencia, todavía falta una capa de evaluación.
Preguntas frecuentes sobre evaluación de agentes de IA
¿Qué es una eval de un agente de IA?+
Es una prueba repetible en la que se plantea una tarea al sistema, se ejecuta en condiciones definidas y se comprueba si cumple criterios de resultado, restricciones, uso de herramientas u otras dimensiones relevantes.
¿Cuántos casos de prueba necesita un agente?+
No existe un número universal. Depende de la variedad de tareas, el riesgo, la madurez del agente y la capacidad de detectar cambios relevantes. Es preferible empezar con casos representativos y fallos reales que construir cientos de ejemplos poco útiles.
¿Por qué hay que ejecutar el mismo caso varias veces?+
Porque el comportamiento de un sistema generativo puede variar entre ejecuciones. Repetir un caso permite estimar estabilidad y evita tomar decisiones basadas en un único intento afortunado o desafortunado.
¿Qué diferencia hay entre evaluar resultado y trayectoria?+
El resultado indica cómo terminó la tarea. La trayectoria muestra cómo llegó el agente hasta allí: herramientas utilizadas, argumentos, decisiones y estados intermedios. Un resultado correcto puede ocultar una ejecución inadecuada.
¿Puede un LLM evaluar a otro LLM?+
Sí, puede utilizarse como grader para criterios semánticos difíciles de medir con reglas, pero necesita una rúbrica clara y calibración con revisión humana. No debería sustituir verificaciones directas cuando un hecho puede comprobarse en el sistema.
¿Cuándo puede un agente recibir más autonomía?+
Cuando las capacidades concretas que va a asumir han sido evaluadas bajo condiciones representativas, no aparecen fallos bloqueantes, existe trazabilidad suficiente y el coste operativo y los controles son compatibles con el proceso.
Fuentes
Fuentes primarias e institucionales consultadas para las capacidades técnicas, terminología y marcos de evaluación. Los recursos “Matriz de confianza Yarvia” y “autonomía guiada por evaluación” se utilizan como estructuras editoriales propias y no se presentan como estándares universales.
Anthropic — Demystifying evals for AI agents.
Referencia para la estructura de evaluaciones de agentes, conceptos task/trial/grader/trace, resultado final, tipos de graders, evals de capacidad y regresión y múltiples ejecuciones.
Consultar fuente
OpenAI — Agents SDK: tracing.
Documentación oficial sobre trazas, generaciones, tool calls, handoffs, guardrails y eventos registrados durante las ejecuciones de agentes.
Consultar fuente
OpenAI — Agents SDK.
Documentación oficial sobre agentes, herramientas, handoffs, guardrails y observabilidad del runtime.
Consultar fuente
NIST — AI Risk Management Framework: Generative AI Profile.
Marco institucional de uso voluntario para incorporar consideraciones de confianza y riesgo al diseño, desarrollo, uso y evaluación de sistemas de IA generativa.
Consultar fuente
NIST AI Resource Center.
Recursos para operacionalizar AI RMF y apoyar testing, evaluation, verification and validation de sistemas de IA.
Consultar fuente
Google Cloud — Vertex AI Agent evaluation.
Ejemplo actual de servicio de producto para evaluar la capacidad de agentes de completar tareas mediante datasets y evaluation runs. La documentación consultada lo marca como Preview/Pre-GA, por lo que su estado debe revalidarse si se cita en una publicación posterior.
Consultar fuente
Nota editorial: las capacidades de plataformas y SDKs pueden cambiar. Conviene revisar la documentación oficial vigente antes de utilizar estas referencias para tomar decisiones de arquitectura o producto.
