
AUTOMATIZACIÓN · KPIS · ROI · OPERACIONES
Cómo medir si una automatización funciona: KPIs, baseline, errores y coste de excepción
Una automatización puede ejecutar miles de tareas sin fallar y, aun así, no haber mejorado el proceso. Para saber si funciona hay que comparar contra una línea base, medir el resultado completo, hacer visibles los errores y excepciones y separar tiempo liberado, ahorro real y valor económico.
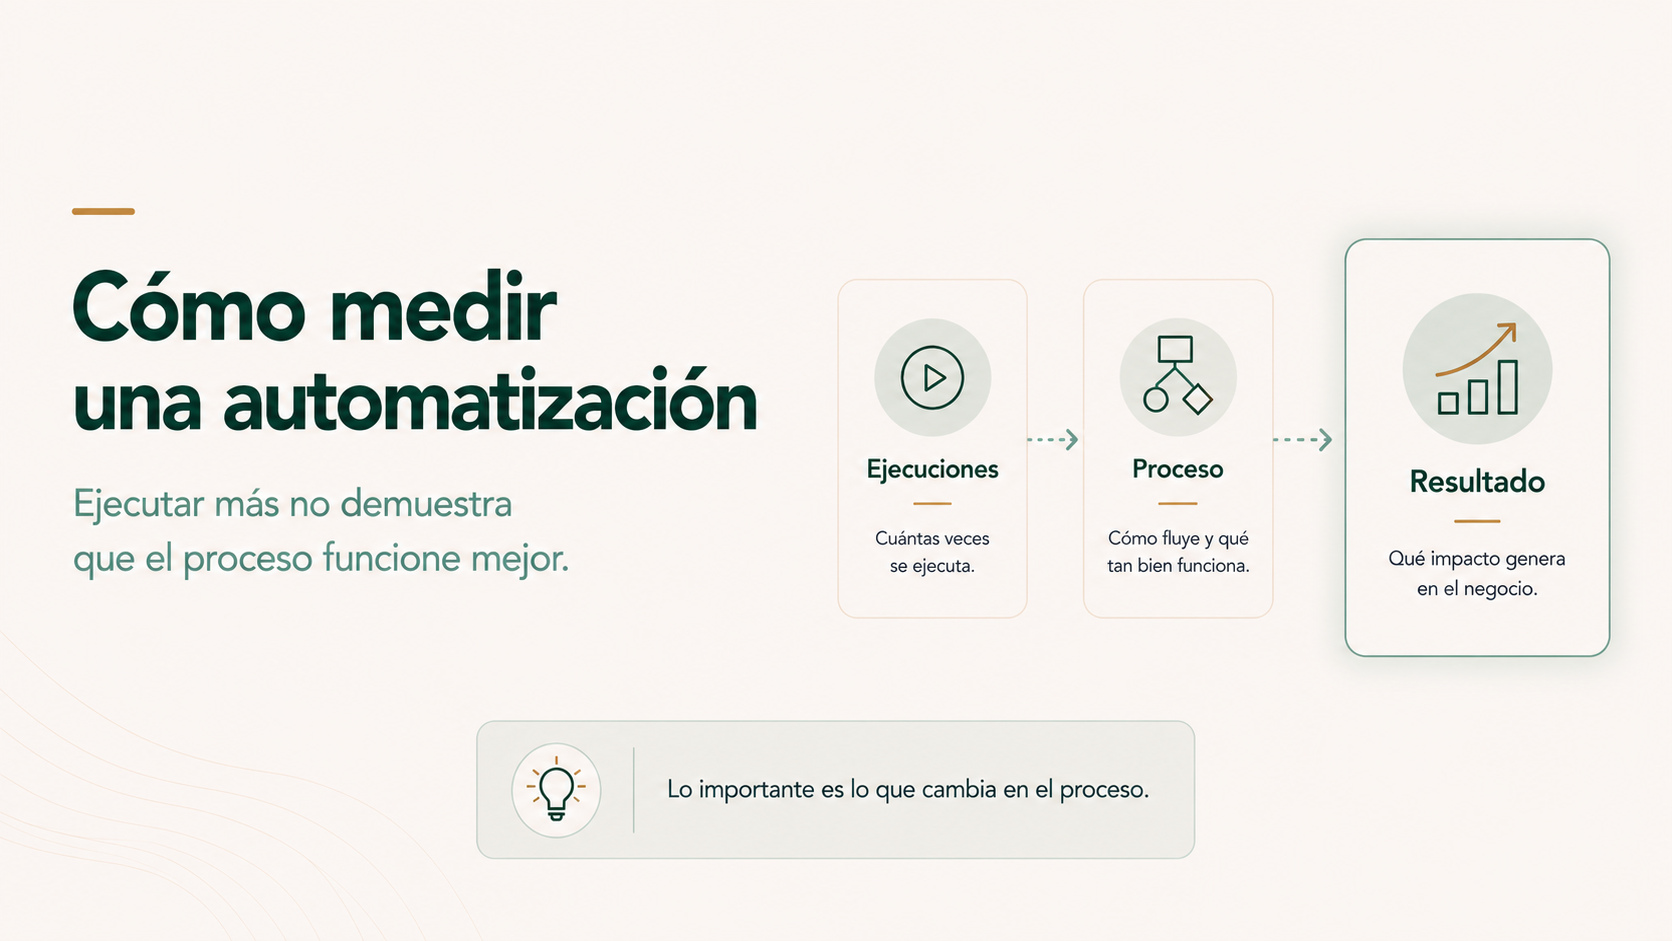
Una automatización no se mide por cuántas tareas ejecuta. Se mide por lo que cambia en el proceso cuando esas tareas dejan de hacerse como antes.
El porcentaje automatizado, el número de ejecuciones o la disponibilidad técnica no demuestran por sí solos una mejora empresarial.
Para medir de verdad hace falta una línea base comparable, una unidad de análisis estable, KPIs vinculados al resultado del proceso y métricas que hagan visible el coste de errores, retrabajo y excepciones.
El dato decisivo no es cuánto trabajo ha absorbido la automatización, sino si el proceso completo termina mejor, con qué coste y sin trasladar el problema a otra etapa.
20.000 ejecuciones correctas y ninguna respuesta a la pregunta importante
Imaginemos una automatización que recibe pedidos por email, extrae los datos y crea un borrador en el ERP. El panel técnico muestra 20.000 ejecuciones correctas durante el trimestre. La tasa de error de la integración es baja. El servicio ha estado disponible casi todo el tiempo.
Sobre el papel, parece un éxito.
Pero nadie sabe si el pedido tarda menos en quedar listo, si administración dedica menos tiempo real, si han disminuido las correcciones, si los pedidos incompletos esperan más que antes o cuánto cuesta resolver los casos que la automatización no puede cerrar.
Ese es el problema de medir una automatización desde la herramienta en lugar de medirla desde el proceso.
Una automatización funciona cuando mejora el resultado del proceso completo respecto a una línea base comparable sin trasladar coste, error o trabajo manual a otra parte del circuito.
Esta definición obliga a mirar más allá de «funciona/no funciona». Un flujo puede estar técnicamente sano y generar un cuello de botella nuevo. Puede ahorrar minutos en una etapa y añadir horas de espera en otra. Puede reducir trabajo manual normal y concentrar todo el esfuerzo en una cola de excepciones difíciles. Incluso puede liberar tiempo sin producir todavía una reducción de costes.
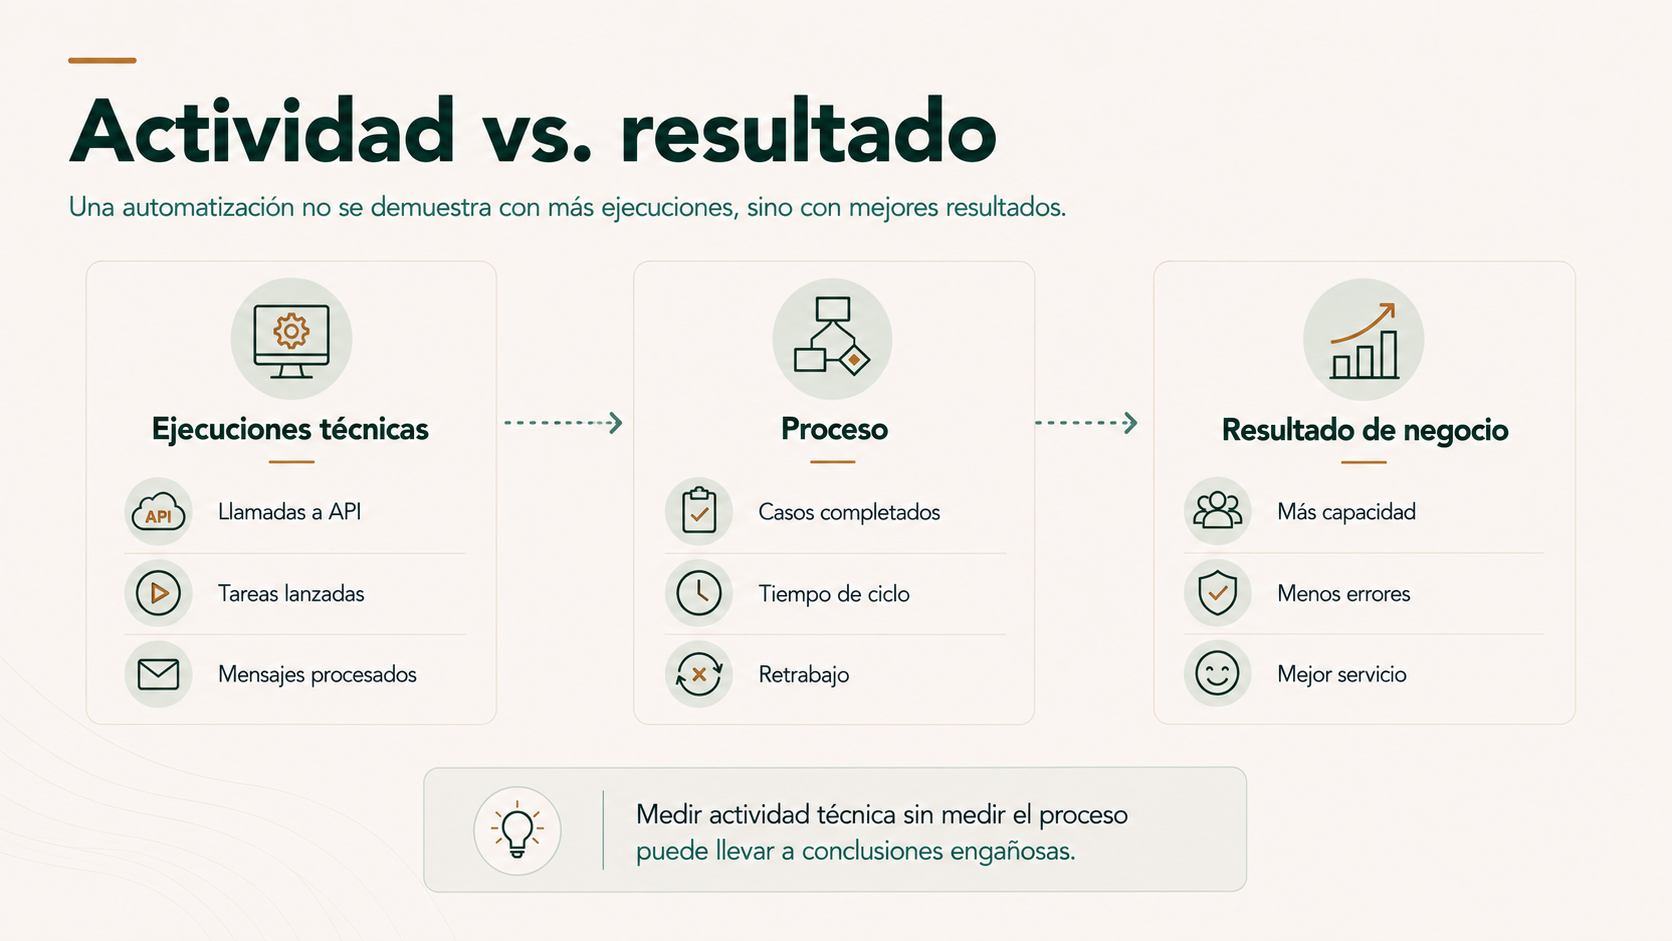
Por eso conviene distinguir desde el principio actividad, rendimiento técnico, rendimiento operativo y resultado de negocio.
Antes de elegir KPIs, define qué estás midiendo y contra qué lo vas a comparar
Una medición puede ser matemáticamente correcta y, aun así, responder a la pregunta equivocada. El primer trabajo no es montar un dashboard. Es definir la unidad de análisis y el punto de comparación.
Métrica, KPI, baseline, objetivo y límite operativo son cosas distintas
Métrica es cualquier medida que ayuda a observar un proceso o sistema. Número de ejecuciones, duración, casos pendientes, errores o minutos de intervención humana son métricas.
KPI —Key Performance Indicator o indicador clave de rendimiento— es una métrica elegida porque representa un resultado relevante para el objetivo del proceso. No toda métrica merece convertirse en KPI.
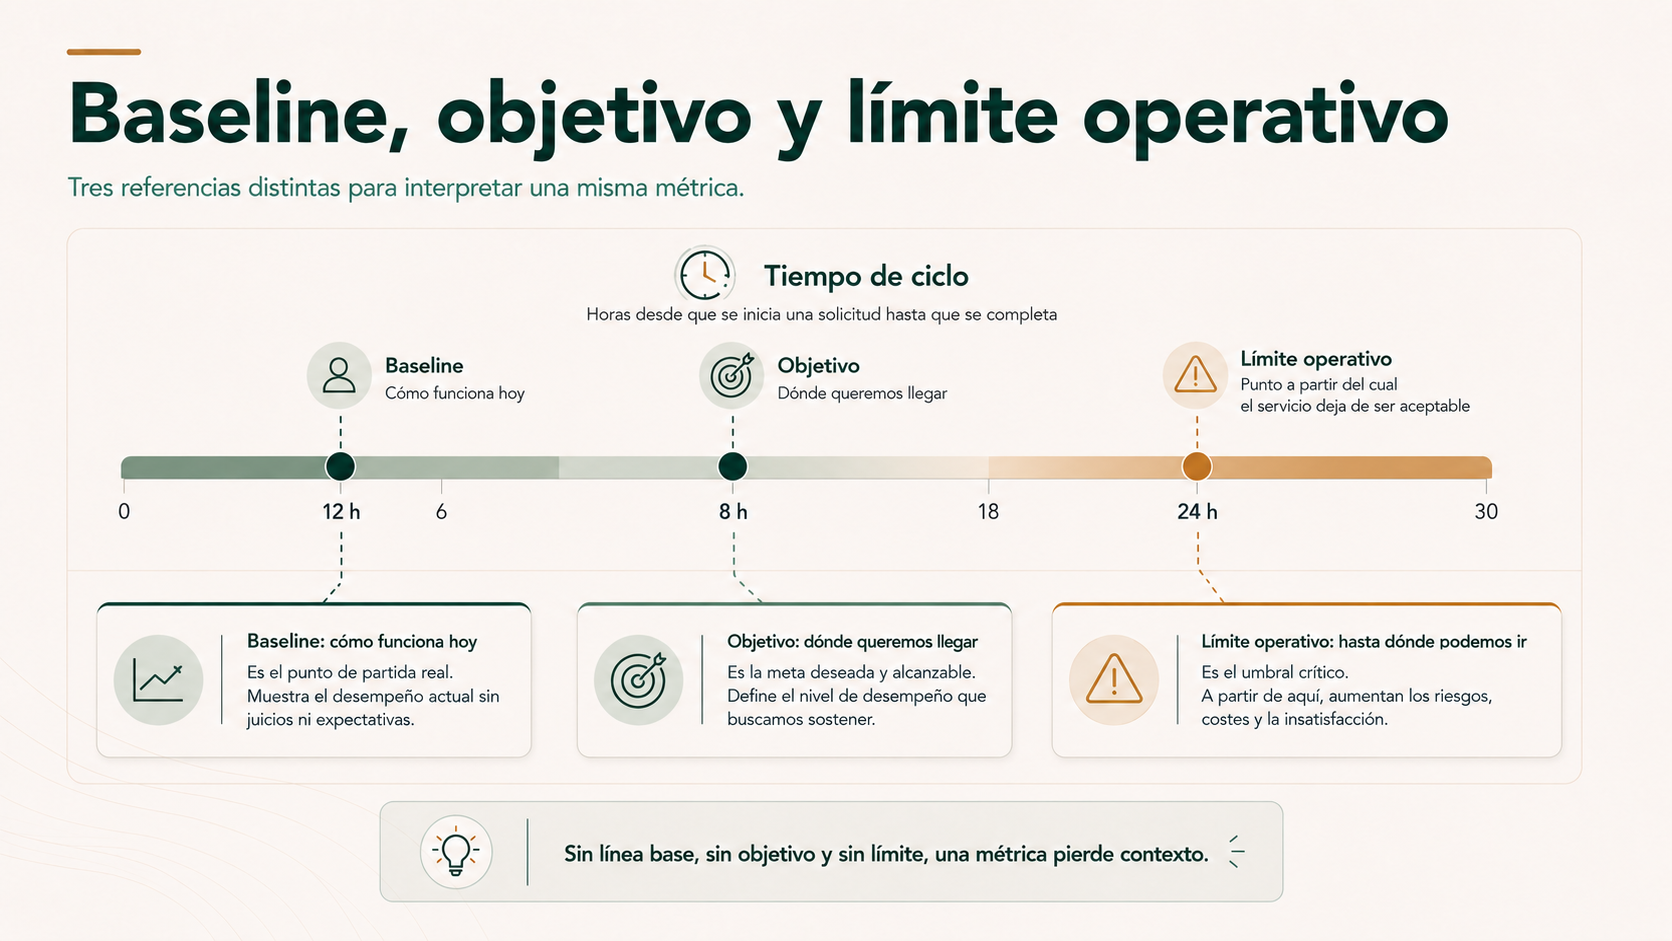
Baseline o línea base es el comportamiento de referencia antes de introducir el cambio, o durante un periodo estable que podamos comparar. La baseline dice cómo funciona ahora.
Objetivo dice cómo queremos que funcione. Y un límite operativo indica a partir de qué valor aparece una degradación o incidencia que exige atención.
Un proceso puede mejorar frente a la baseline y no alcanzar todavía el objetivo. También puede cumplir el objetivo medio y esconder un conjunto pequeño de casos que ha empeorado mucho.
Define primero qué es un «caso»
En un proceso de facturas, un caso puede ser una factura recibida y contabilizada. En soporte, una incidencia cerrada. En compras, una solicitud resuelta. En una clínica, una cita administrativa gestionada. En un hotel, una modificación de reserva completada.
El inicio y el final deben ser estables. Si antes medimos desde «email recibido» hasta «tarea creada» y después medimos desde «email recibido» hasta «pedido validado», no estamos comparando el mismo recorrido.
También importa el denominador: el conjunto sobre el que calculamos un ratio. «10 errores» significa cosas muy distintas sobre 100 casos o sobre 100.000. Y «90 % automatizado» puede referirse a casos recibidos, casos elegibles, ejecuciones técnicas o casos completados correctamente. Si no se declara el denominador, el porcentaje puede ser engañoso.
La baseline debe representar un periodo comparable
La línea base debería recoger suficiente variabilidad para describir el funcionamiento normal: volumen, tiempo de ciclo, minutos de trabajo manual, errores, retrabajo, excepciones, backlog —casos pendientes acumulados— y coste aproximado por caso cuando sea posible.
No existe una duración universal para construirla. Un proceso muy estable puede necesitar menos observación que otro sometido a cierres mensuales, campañas, vacaciones, estacionalidad o picos de demanda. Si no hay histórico fiable, puede crearse una baseline prospectiva mediante una fase previa de observación.
La regla práctica es sencilla: la comparación solo es útil si antes y después representan poblaciones, periodos y estados del proceso razonablemente equivalentes.
Promedio no siempre significa comportamiento típico
Los promedios pueden ocultar colas. Si casi todos los casos se resuelven rápido pero una minoría espera horas o días, la media puede parecer aceptable y el problema seguir ahí.
Cuando aporte, conviene mirar la mediana y percentiles. Un percentil indica el valor por debajo del cual cae una parte determinada de los casos. Por ejemplo, el p95 ayuda a observar la zona lenta de la distribución sin convertir el análisis en estadística avanzada.
Esto importa especialmente en automatización porque las excepciones suelen concentrarse en la cola. El tiempo medio puede bajar de seis a cuatro horas y, al mismo tiempo, el 10 % más lento pasar de doce a treinta horas porque permanece pendiente de intervención humana.
El cuadro de medición de automatización: seis capas para evitar mejoras aparentes
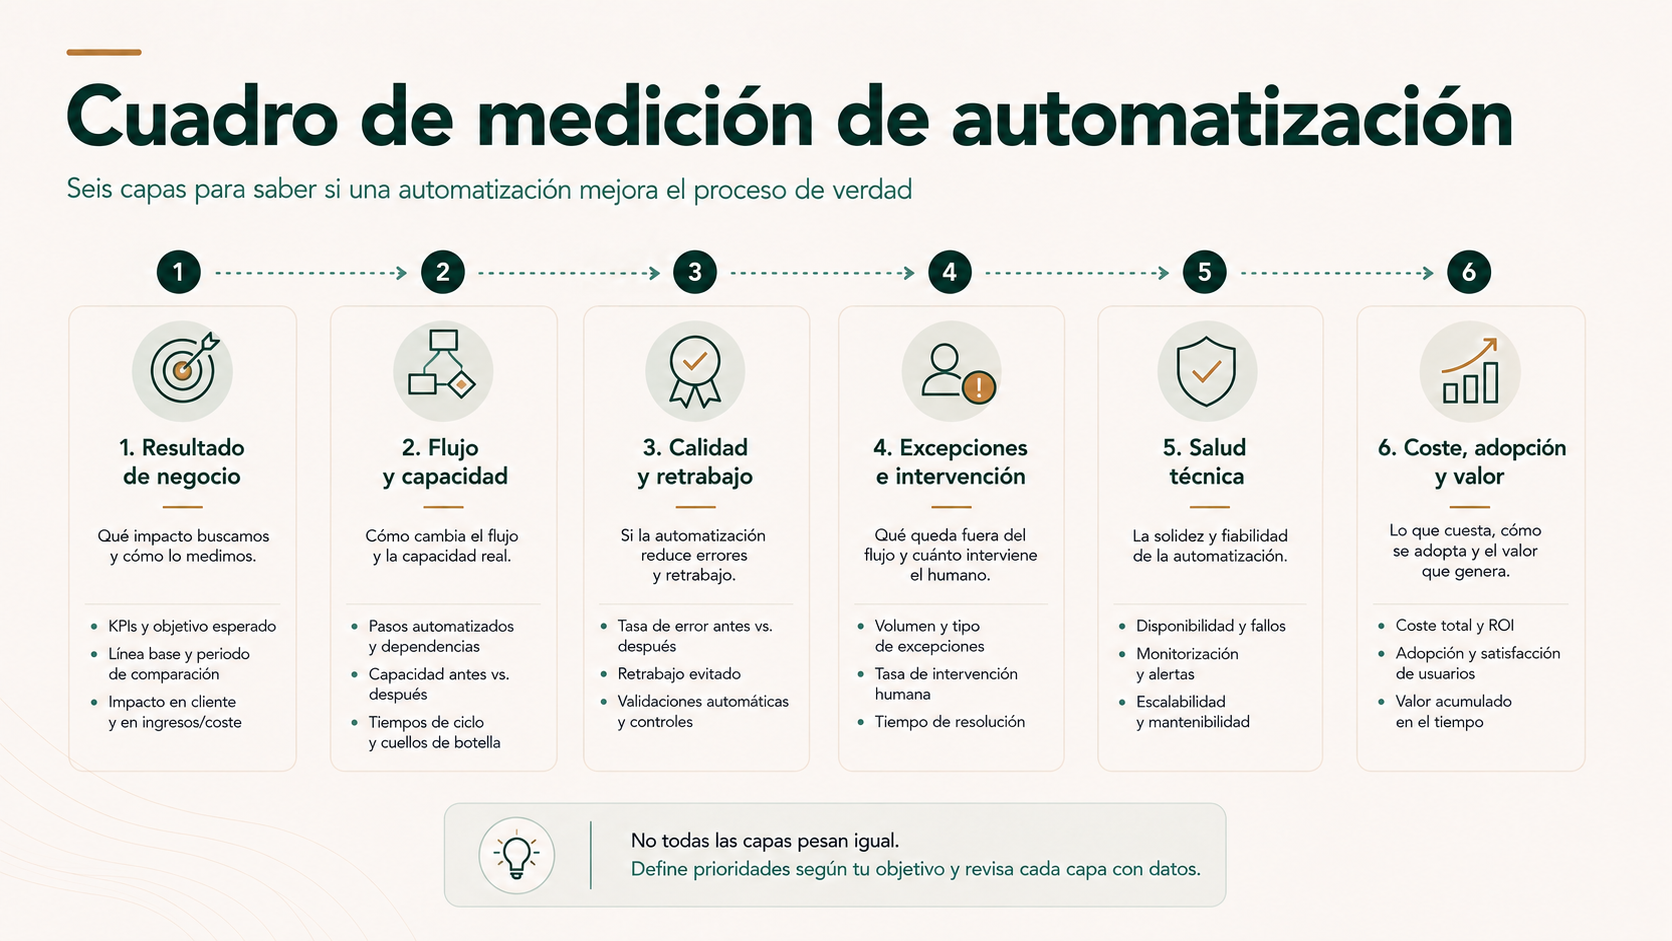
Para ordenar la evaluación utilizaremos un recurso editorial propio de Yarvia: el cuadro de medición de automatización. No es un estándar universal ni pretende reducir un proyecto a una puntuación. Su función es obligar a mirar seis capas distintas antes de declarar que una automatización ha funcionado.
1. Resultado
Qué consecuencia empresarial debía mejorar: tiempo hasta resolución, capacidad, servicio, coste o calidad.
2. Flujo y capacidad
Tiempo de ciclo, espera, volumen completado, backlog y capacidad de salida.
3. Calidad
Errores, correcciones posteriores, retrabajo y casos resueltos correctamente al primer intento.
4. Excepciones
Casos fuera del camino automático, tiempo humano, espera en cola y coste residual.
5. Salud técnica
Disponibilidad, latencia, reintentos, dependencias, fallos y capacidad de recuperación.
6. Coste, adopción y valor
Coste por caso, uso real del flujo, circuitos paralelos, capacidad liberada y valor económico.
La utilidad del marco está en las relaciones entre capas. Si baja el tiempo de ciclo pero suben los errores, la mejora necesita revisión. Si aumenta el porcentaje automatizado pero el coste de excepción crece, quizá solo hemos movido el trabajo. Si la solución funciona técnicamente pero el equipo sigue usando hojas paralelas, la adopción está diciendo algo importante sobre el diseño.
Medir el flujo: tiempo de ciclo, tiempo manual, capacidad y retrabajo
Una de las confusiones más habituales consiste en medir solo el tiempo que desaparece de una tarea manual concreta. El proceso puede seguir tardando lo mismo.
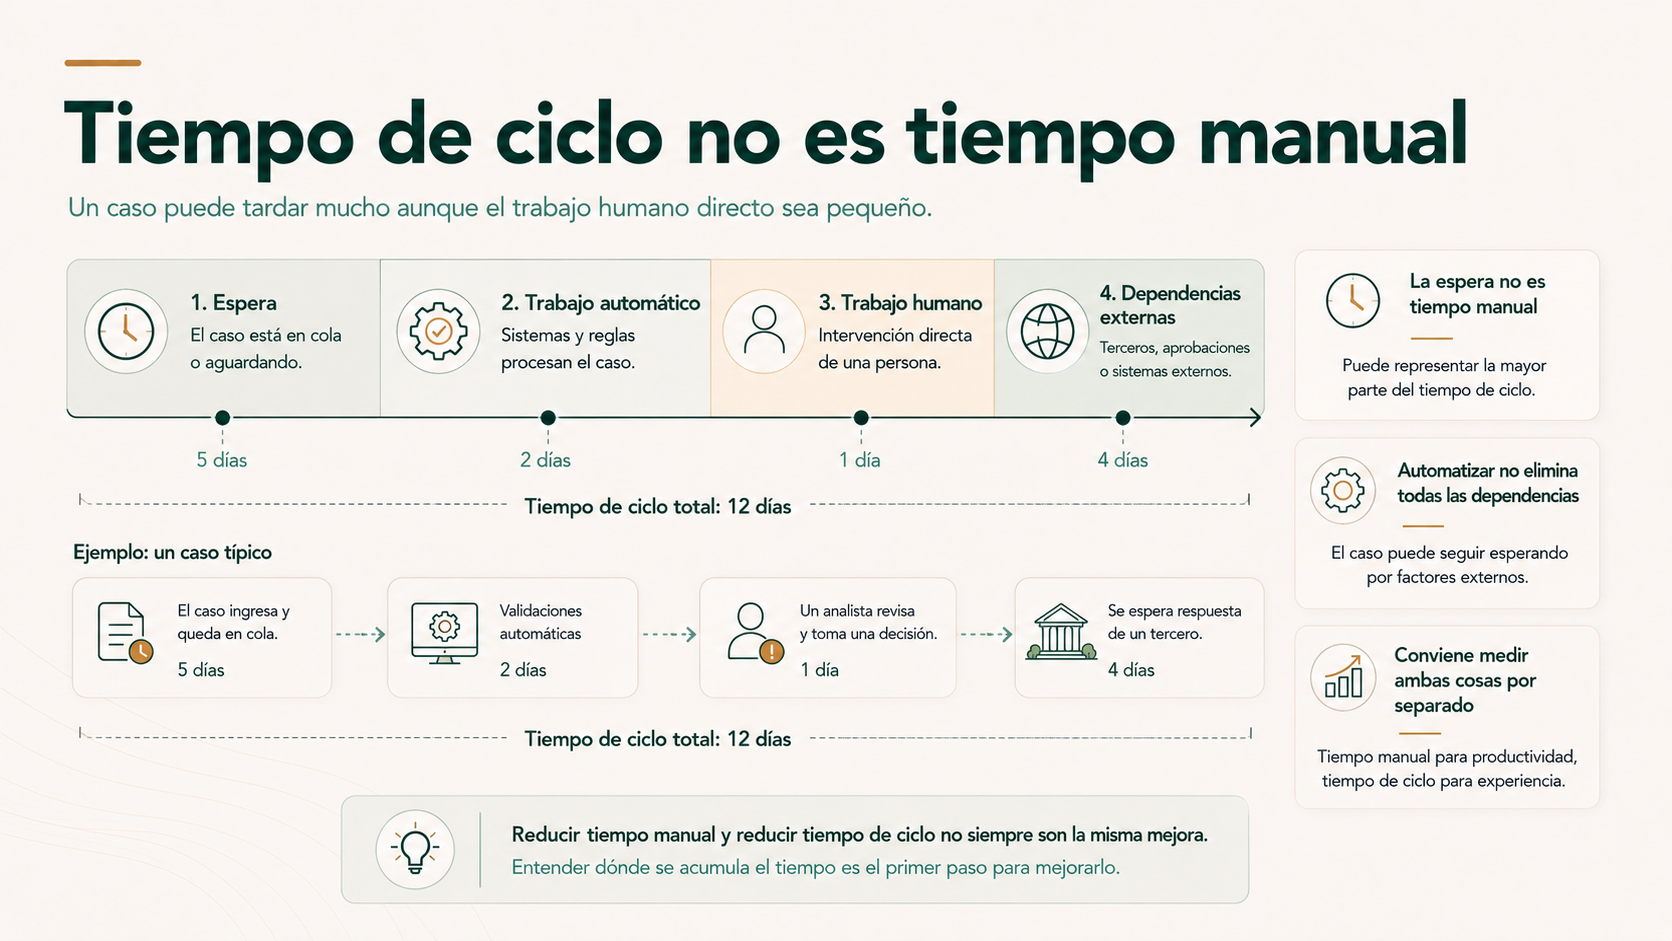
Tiempo de ciclo es el tiempo transcurrido desde el inicio definido de un caso hasta su finalización. Tiempo de trabajo manual es el tiempo efectivo que una persona dedica a ese caso. Son dos magnitudes distintas.
Una automatización puede reducir de quince a dos minutos la intervención administrativa y no modificar el tiempo de ciclo si el caso sigue esperando ocho horas una aprobación, una respuesta de cliente o una sincronización posterior.
Capacidad de salida, backlog y cuello de botella
Throughput es el volumen de casos completados por unidad de tiempo. En castellano podemos hablar de capacidad de salida o volumen procesado. Debe observarse junto al volumen entrante y al backlog.
El backlog es el conjunto de casos pendientes que se va acumulando. No basta con conocer cuántos hay: su antigüedad puede revelar que los casos difíciles quedan atrapados mientras los sencillos se resuelven cada vez más rápido.
Si la automatización incrementa el throughput en la primera etapa pero el cuello de botella se desplaza a validación, facturación o aprobación, la capacidad global puede no cambiar.
Calidad: error, retrabajo y primer intento
Retrabajo es repetir una actividad porque el caso no quedó correctamente resuelto o tuvo que volver a una etapa anterior. Es importante porque puede aparecer lejos del punto donde se originó el error.
Conviene medir errores por tipo y severidad, correcciones posteriores y, cuando pueda definirse objetivamente, el porcentaje de casos completados correctamente al primer intento.
Además, hay que separar error técnico, error de negocio y excepción.
Tres categorías que no deben mezclarse
Error técnico: timeout, autenticación caducada, API no disponible, formato inválido o fallo de una dependencia.
Error de negocio: cliente incorrecto, importe incoherente, pedido creado para la cuenta equivocada o expediente cerrado incompleto, aunque técnicamente la operación haya recibido una respuesta correcta.
Excepción: caso legítimo que no puede seguir el camino automático previsto y necesita otra ruta. No toda excepción implica que la automatización haya fallado.
Una API puede responder correctamente y el proceso estar equivocado. Del mismo modo, una excepción bien diseñada puede ser una salida correcta del sistema. Por eso la tasa de éxito técnico nunca debería utilizarse como sustituto de la tasa de casos operativamente correctos.
El coste de excepción: donde suele esconderse la parte más cara del proceso
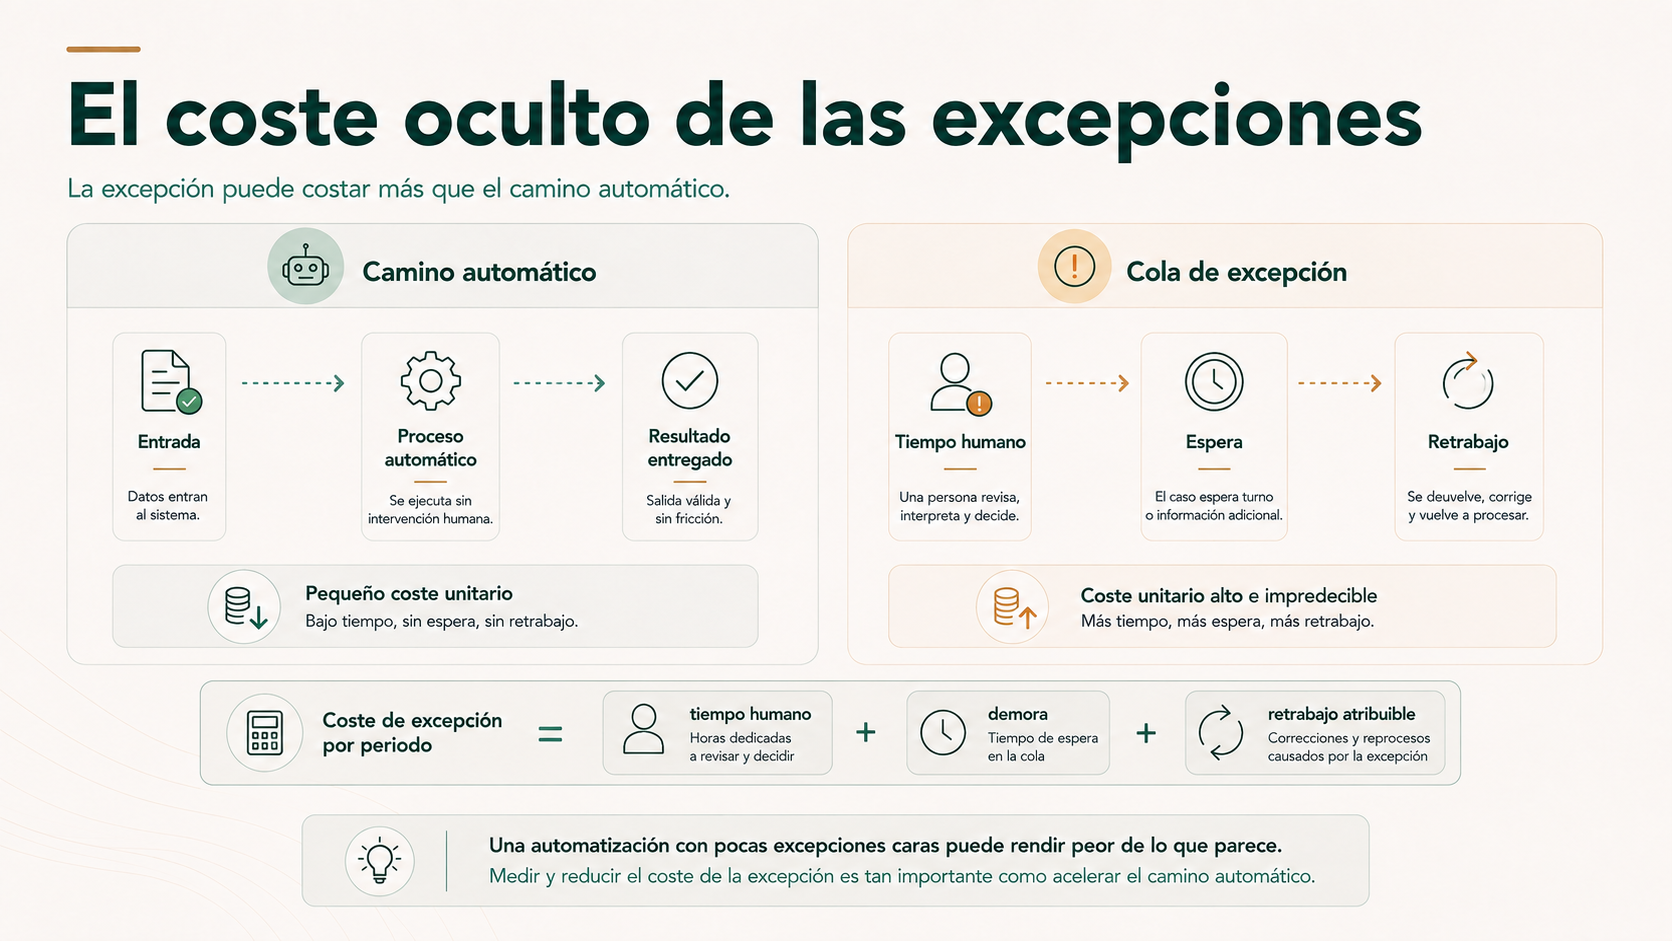
Una automatización puede resolver el 95 % de los casos y parecer excelente. El problema es que el 5 % restante puede concentrar la mayor dificultad, más tiempo humano, más espera y buena parte de los errores.
Por eso el porcentaje automatizado es una métrica incompleta. Debe acompañarse de volumen absoluto, calidad, tiempo de resolución y coste del camino residual.
En la entrada sobre human-in-the-loop explicamos cómo diseñar revisión, aprobación y excepciones. Aquí la pregunta es otra: ¿cuánto cuesta y qué efecto operativo tiene esa intervención?
El coste de excepción intenta hacer visible el esfuerzo necesario para detectar, entender, resolver y cerrar los casos que salen del camino normal. Puede incluir tiempo humano directo y, cuando sea razonablemente atribuible, retrabajo o costes de demora.
Modelo orientativo para hacer visible el coste de las excepciones
Coste de excepción por periodo
Tiempo humano dedicado a excepciones × coste horario interno aplicable + retrabajo o demora razonablemente atribuibles
No es una fórmula contable universal. Su utilidad es obligar a identificar qué trabajo y qué coste sigue existiendo fuera del camino automático.
También puede calcularse un coste medio por excepción o un coste de excepción repartido sobre todos los casos. Lo importante es no esconder el esfuerzo residual bajo un porcentaje de automatización atractivo.
Una cola de excepciones debería medir al menos motivo, tiempo hasta asignación, tiempo activo de resolución, tiempo total en espera, resultado y reincidencia. Si una misma causa aparece repetidamente, quizá deje de ser una «excepción» y esté pidiendo rediseñar una regla o ampliar la cobertura.
Salud técnica: necesaria para operar, insuficiente para demostrar valor
Disponibilidad, latencia, reintentos, errores por dependencia, colas pendientes, tiempo de recuperación y cambios de versión son métricas necesarias. Sin ellas es difícil diagnosticar por qué una automatización se degrada.
Pero describen principalmente cómo se comporta el sistema técnico. No responden por sí mismas a si el negocio está mejor.
Una automatización puede estar disponible prácticamente todo el tiempo y ser poco utilizada. Puede responder rápido y producir un resultado de negocio incorrecto. Puede completar sus pasos y dejar el trabajo difícil en una cola manual.
La observabilidad técnica sirve cuando ayuda a conectar síntomas con el proceso: qué ocurrió, en qué etapa, para qué caso, con qué dependencia y qué consecuencia produjo.
En integraciones complejas también resulta útil correlacionar las señales técnicas con la entidad de negocio. La integración CRM–ERP es un buen ejemplo: un reintento, una duplicación o una divergencia puede ser técnicamente rastreable, pero lo que importa es si terminó afectando a cliente, pedido, factura o estado comercial.
Adopción y circuitos paralelos: cuando el sistema funciona y el proceso real ocurre por otro sitio
Adopción significa hasta qué punto las personas y equipos utilizan de verdad la solución prevista como parte del proceso. No se limita a «usuarios que han iniciado sesión». La pregunta es si los casos reales recorren el circuito diseñado.
Un circuito paralelo aparece cuando una parte del trabajo se sigue realizando fuera del flujo oficial: una hoja de cálculo auxiliar, mensajes privados, correos reenviados, anotaciones manuales, registros duplicados o correcciones que nunca vuelven al sistema.
Estos circuitos son relevantes porque pueden distorsionar todas las métricas. El sistema parece procesar el 80 % de los casos, pero un equipo mantiene una hoja para corregir datos antes de enviarlos. Esa actividad desaparece del dashboard, no del trabajo.
Por eso conviene medir la proporción de casos que entra por el canal previsto, correcciones fuera del workflow, bypasses —saltos deliberados del flujo—, duplicación de registro y tareas manuales no capturadas.
Una baja adopción tampoco debe interpretarse automáticamente como «resistencia al cambio». Puede señalar que la solución tiene mala experiencia de uso, no cubre excepciones relevantes, genera poca confianza o fuerza al equipo a adaptar un proceso que no encaja con la realidad.
Una señal útil
Si el equipo necesita mantener una hoja paralela para que la automatización funcione, esa hoja forma parte del proceso real y debe entrar en la medición.
Liberar tiempo no significa automáticamente ahorrar dinero
Este es uno de los errores más frecuentes al justificar económicamente una automatización.
Supongamos que un equipo libera 40 horas al mes. Si la estructura de costes permanece igual, la empresa no ha reducido automáticamente su salida de caja en «40 horas × coste horario».
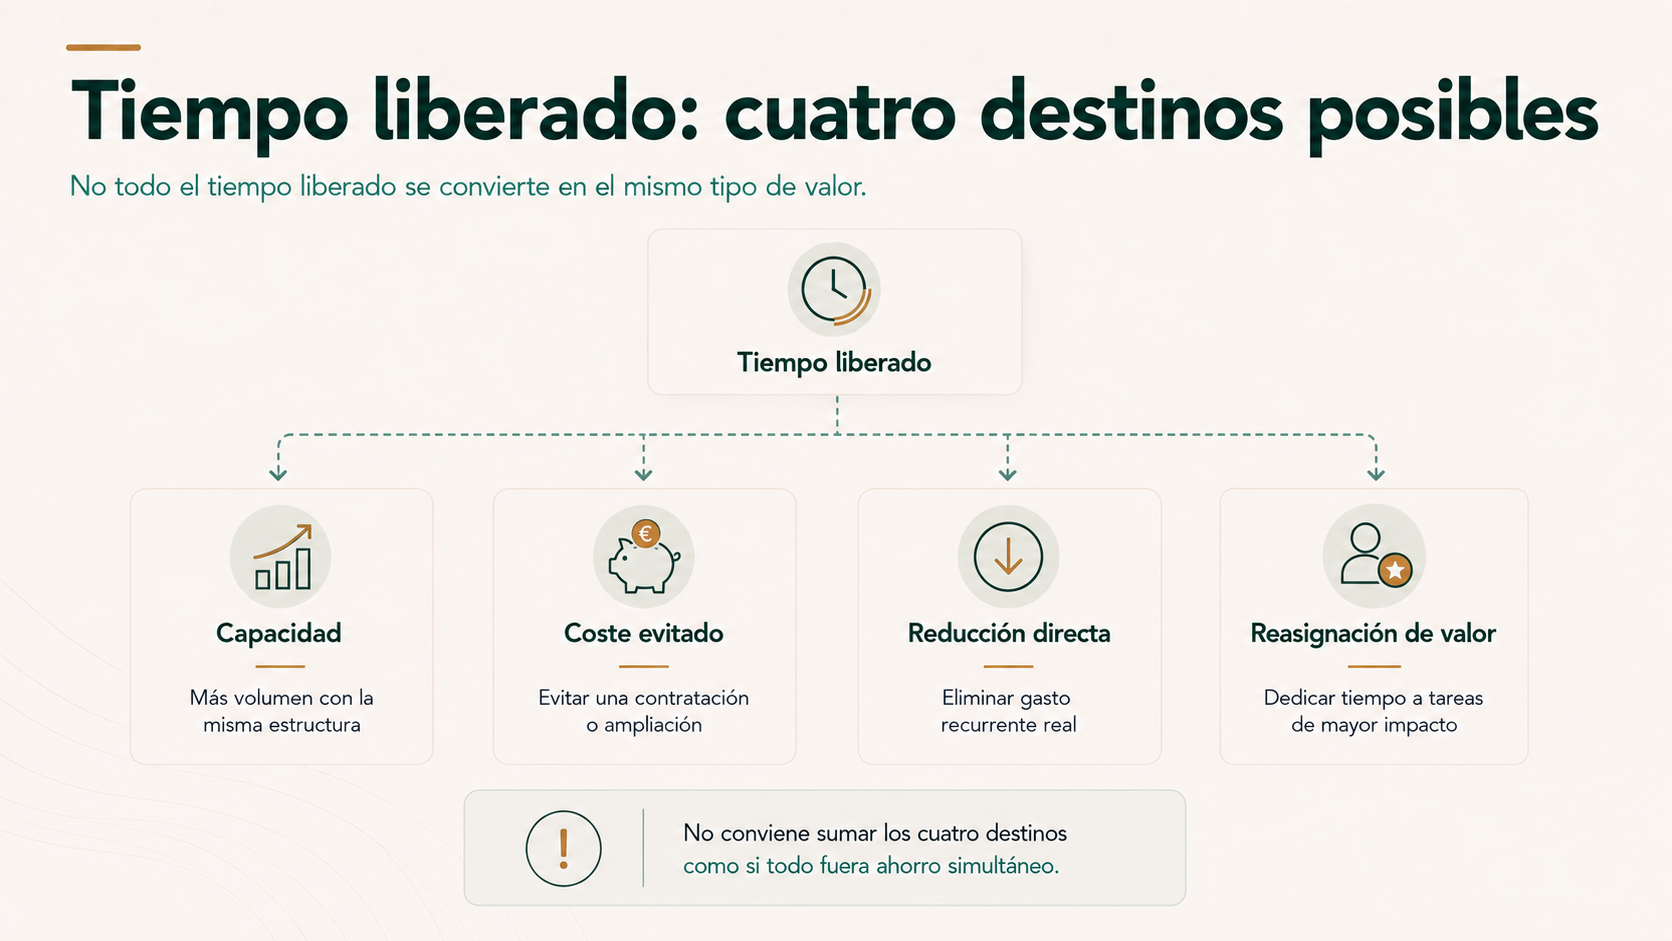
El tiempo liberado puede tener valor, pero primero hay que identificar qué ocurre con esa capacidad.
Capacidad liberada: el equipo dispone de tiempo que antes consumía el proceso.
Coste evitado: esa capacidad permite, por ejemplo, absorber crecimiento sin contratar al mismo ritmo que antes.
Reducción directa de coste: existe una disminución demostrable de gasto, horas extra, externalización, licencias o estructura atribuible al cambio.
Valor generado: la capacidad se reasigna y produce un resultado medible: más casos atendidos, menos retraso, mejor conversión o menor pérdida, siempre que la atribución sea razonable.
Ejemplo ilustrativo: 100 horas liberadas no significan «media persona menos»
Imaginemos un equipo de cinco personas que, entre todas, libera 100 horas al mes después de automatizar una parte del proceso. La empresa mantiene la misma plantilla y el mismo coste salarial, por lo que no existe automáticamente una reducción de gasto equivalente a esas 100 horas.
Si gracias a esa capacidad el equipo puede absorber, por ejemplo, un 20 % más de volumen sin ampliar estructura, el efecto económico puede clasificarse como capacidad liberada y, si ese crecimiento habría exigido realmente una contratación adicional, como coste evitado.
La cifra del 20 % es solo un ejemplo didáctico. No es un benchmark ni una expectativa general. La mejora real debe calcularse con el volumen, la carga y la estructura de cada empresa.
Estas vías pueden coexistir, pero no deben sumarse si representan el mismo beneficio desde ángulos distintos. Convertir toda hora liberada en euros y después añadir también «capacidad generada» puede duplicar el valor.
Coste total de operar la automatización
Para evaluar el resultado económico no basta con recordar el coste de construcción. En operación pueden existir licencias, infraestructura, consumo de APIs o modelos, mantenimiento, observabilidad, soporte, incidencias, revisión humana, tratamiento de excepciones y cambios provocados por sistemas externos.
Cuando el volumen varía, el coste por caso puede aportar más información que el coste mensual aislado.
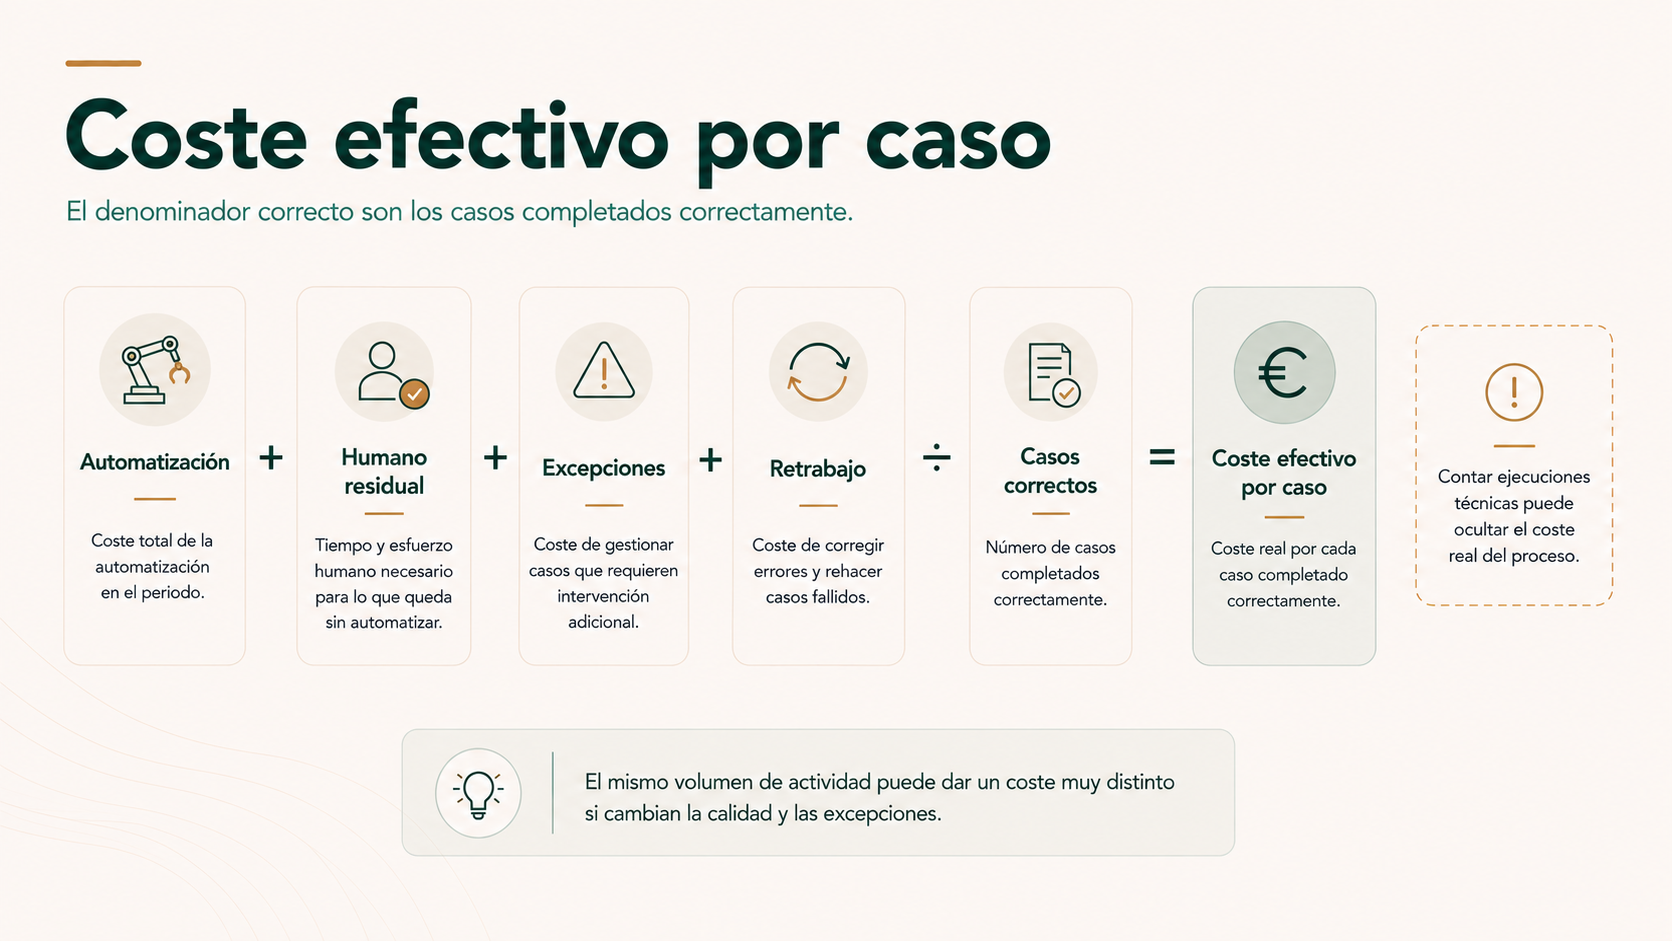
Modelo Yarvia orientativo: coste efectivo por caso
(Coste operativo automatizado atribuible + coste humano residual + coste de excepciones + retrabajo atribuible) / casos completados correctamente
El denominador importa: utilizar ejecuciones técnicas en lugar de casos realmente completados puede hacer parecer eficiente un sistema que todavía necesita correcciones posteriores.
La palabra importante es correctamente. Dividir por ejecuciones técnicas puede hacer parecer barato un sistema que necesita muchas correcciones posteriores.
Si los costes no pueden atribuirse con suficiente rigor, es mejor mostrar sus componentes por separado que fabricar una cifra precisa pero poco defendible.
ROI y payback después de resolver la atribución
ROI es una relación entre beneficio económico atribuible y coste relevante durante un periodo definido. Payback o plazo de recuperación es el tiempo necesario para que los beneficios acumulados compensen la inversión según los supuestos utilizados.
Ambos son útiles, pero una fórmula no resuelve el problema principal: qué beneficio podemos atribuir realmente a la automatización y qué costes estamos incluyendo.
La entrada sobre cuánto cuesta automatizar un proceso desarrolla las variables de construcción y mantenimiento. Aquí el foco está en comprobar si la operación posterior produce valor medible.
Antes/después no siempre demuestra que la automatización causó toda la mejora
Después de implantar una solución pueden cambiar al mismo tiempo el volumen, la demanda, el equipo, el producto, los precios, una campaña comercial o el propio procedimiento interno.
Por eso «antes tardábamos seis horas y ahora cuatro» es evidencia de cambio, pero no siempre demuestra que todo el cambio proceda de la automatización.
Conviene comparar periodos y segmentos equivalentes, documentar otros cambios relevantes y, cuando sea viable, utilizar pilotos, despliegues progresivos, cohortes o grupos comparables. No hace falta convertir cada proyecto en un experimento académico, pero sí evitar atribuir de más.
Segmentar para descubrir dónde funciona y dónde no
Un promedio global puede ocultar que la automatización funciona muy bien en casos simples y mal en una categoría concreta. La segmentación puede hacerse por tipo de caso, proveedor, cliente, sede, canal, producto, horario o cualquier dimensión relevante con suficiente volumen.
El objetivo no es crear cientos de segmentos. Es descubrir si existe una parte del proceso que necesita otra regla, otro dato o incluso quedar fuera de la automatización.
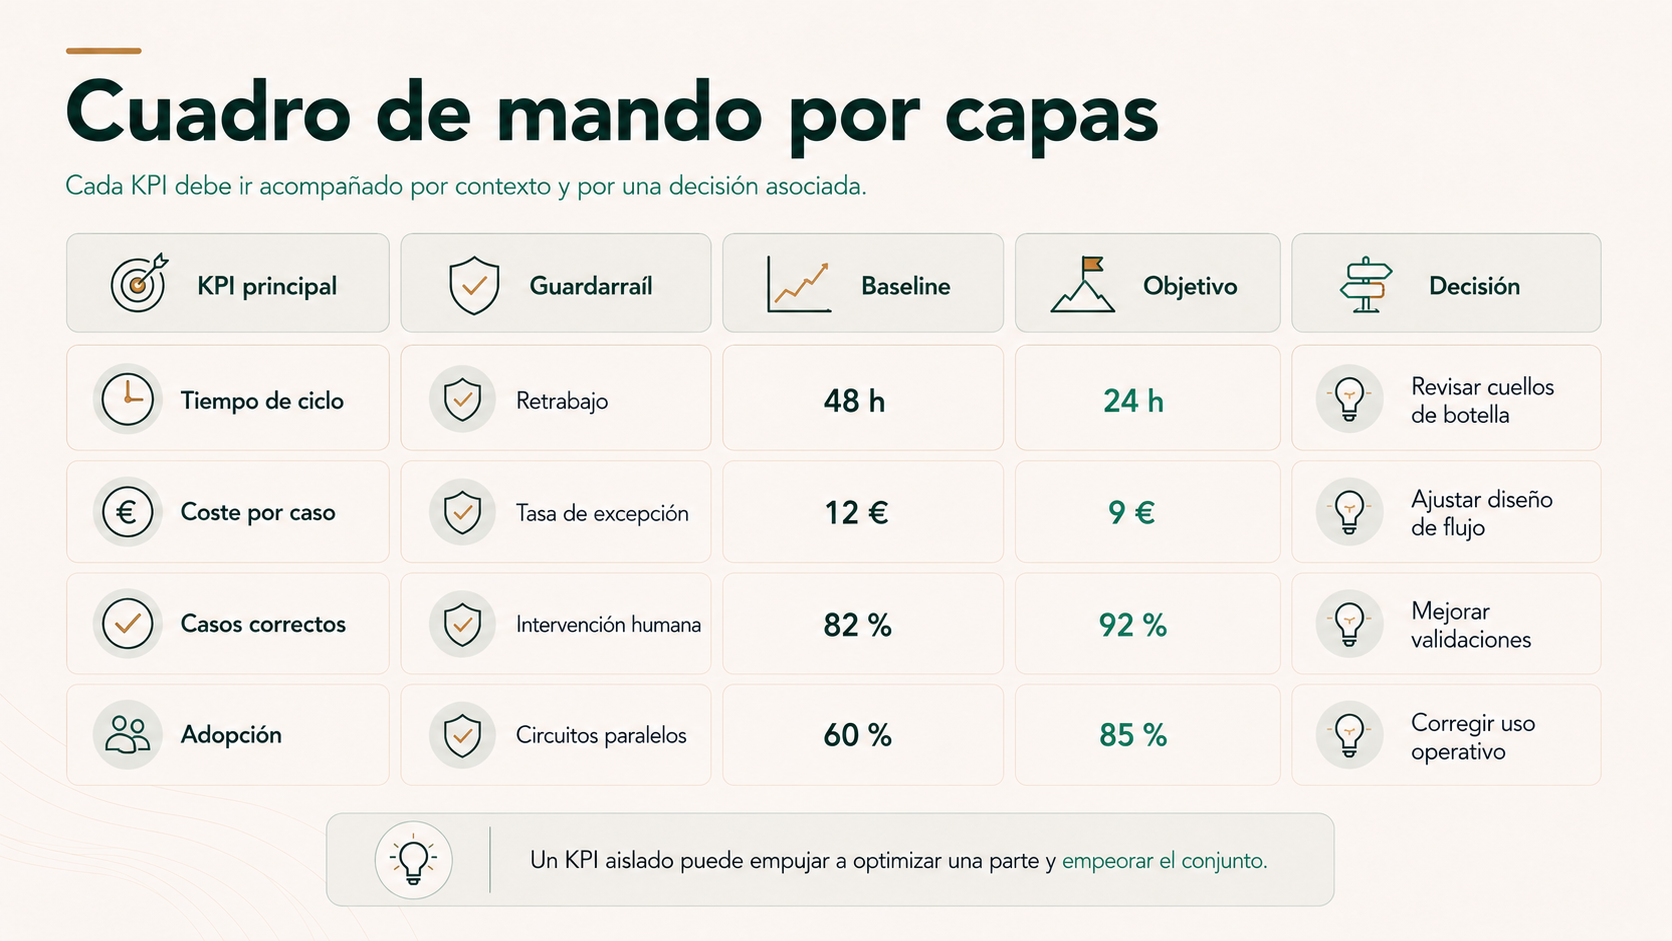
Qué son las métricas de guardarraíl
En este artículo llamamos métricas de guardarraíl a indicadores que vigilamos para evitar que mejorar un objetivo principal deteriore otra dimensión importante. El término se usa aquí como recurso de diseño, no como una taxonomía universal del sector.
Un KPI puede decir «reducir tiempo de ciclo». Su métrica de guardarraíl puede ser «no aumentar tasa de error». Si el objetivo es reducir intervención humana, una guardarraíl puede vigilar incidencias posteriores. Si buscamos bajar coste por caso, podemos observar que no empeoren la espera o la completitud.
La lógica es sencilla: no optimizar una parte del proceso a costa de romper otra que no aparece en el KPI principal.
Process mining, observabilidad y NIST AI RMF: tres referencias útiles, no tres requisitos
Qué significa process mining
Process mining o minería de procesos es una disciplina y conjunto de técnicas que reconstruyen cómo se ejecuta realmente un proceso a partir de los eventos registrados en sistemas: qué actividades ocurren, en qué orden, cuánto tardan, qué variantes aparecen y dónde existen esperas o retrabajo.
Puede ayudar cuando la organización dispone de datos de eventos suficientemente consistentes. Por ejemplo, permite observar duración de casos, tiempos de espera, variantes y repeticiones. No significa que toda empresa necesite comprar una herramienta de process mining para medir una automatización.
En muchos proyectos bastará con mejorar estados, marcas de tiempo, logs y métricas de los sistemas existentes. La minería de procesos es una opción cuando la complejidad, volumen y calidad de datos justifican ese nivel de análisis.
Observabilidad: entender qué está ocurriendo cuando algo se desvía
La observabilidad combina métricas, logs y trazas para poder comprender el comportamiento de un sistema a partir de sus señales. En automatización empresarial interesa especialmente cuando esas señales pueden relacionarse con casos y resultados de negocio.
AWS y Azure ofrecen marcos de arquitectura que recomiendan definir KPIs ligados a objetivos, establecer baselines, utilizar telemetría y evitar quedarse solo con métricas técnicas desconectadas del resultado. Son referencias útiles de ingeniería, no una obligación de desplegar el proyecto en esas nubes.
Qué es NIST AI RMF y cuándo tiene sentido citarlo
NIST AI RMF significa Artificial Intelligence Risk Management Framework, el marco de gestión de riesgos de inteligencia artificial del National Institute of Standards and Technology de Estados Unidos. Es un marco voluntario que organiza la gestión del riesgo de IA en cuatro funciones: gobernar, mapear, medir y gestionar.
Su función MEASURE propone evaluar y monitorizar riesgos, rendimiento, fiabilidad e impactos de sistemas de IA antes y durante su operación. En esta entrada lo utilizamos solo cuando la automatización incorpora IA.
No tendría sentido presentarlo como requisito general para un workflow determinista que mueve datos entre dos sistemas. Su valor aquí es recordar que, cuando existe IA, la medición no termina en latencia o coste: puede requerir evaluar calidad, fiabilidad, incertidumbre y comportamiento durante la operación.
La guía sobre evaluación de agentes de IA desarrolla evals, casos límite y regresiones. Esta pieza mantiene el foco en la automatización y el proceso completo.
Un cuadro de mando útil tiene pocas métricas y cada una conduce a una decisión
Un dashboard con cuarenta indicadores puede generar más tranquilidad visual que capacidad de gestión.
Para cada KPI conviene definir: qué pregunta responde, cómo se calcula, cuál es la fuente, qué población utiliza, con qué frecuencia se revisa, qué segmentación importa, quién es responsable y qué decisión se toma si se desvía.
Además, ayuda separar indicadores de negocio, proceso y salud técnica. Si se mezclan sin jerarquía, una mejora técnica puede eclipsar un deterioro operativo.
| Objetivo | KPI principal | Guardarraíl | Baseline | Fuente | Segmentación | Propietario | Decisión si se desvía |
|---|---|---|---|---|---|---|---|
| Reducir tiempo de ciclo | Mediana de tiempo hasta cierre | Tasa de error | Periodo pre-automatización comparable | CRM / ERP / log de proceso | Tipo de caso | Operaciones | Investigar cuello de botella |
| Reducir trabajo manual | Minutos humanos por caso | Coste de excepción | Muestreo previo | Time tracking / estados | Tipo de excepción | Operaciones + finanzas | Rediseñar regla o cobertura |
| Aumentar capacidad | Casos correctos completados por periodo | Backlog antiguo | Volumen histórico | Sistema de registro | Canal / equipo | Responsable de proceso | Ajustar capacidad o automatización |
Si una empresa todavía no puede completar esta tabla con datos fiables, el problema no es que le falte un dashboard. Probablemente necesita revisar primero cómo define el proceso, qué estados registra y qué fuentes permiten construir una línea base. Ese es precisamente el punto de partida de un diagnóstico de automatización: decidir qué debe medirse antes de añadir más herramientas.
La tabla no pretende convertirse en plantilla universal. Su valor está en mostrar que cada KPI necesita contexto y una decisión asociada. Si nadie sabe qué hacer cuando se desvía, probablemente sea una métrica de observación, no un indicador de gestión.
Ejemplo práctico: la automatización que ahorraba minutos pero acumulaba excepciones
Pensemos en una empresa B2B ficticia que recibe pedidos por email y los introduce manualmente en el ERP. Antes de automatizar, mide durante un periodo representativo el volumen, el tiempo desde la recepción hasta el borrador en ERP, los minutos humanos, errores detectados, aclaraciones solicitadas y casos pendientes.
Después automatiza la extracción y validación de los pedidos elegibles. Los casos normales generan el borrador y las excepciones pasan a una cola.
La primera lectura parece positiva: el tiempo manual por pedido baja con claridad. Sin embargo, el tiempo total de ciclo apenas mejora.
Al segmentar, aparece la explicación: una minoría de pedidos con referencias ambiguas permanece demasiado tiempo en la cola de excepciones. No son muchos, pero concentran buena parte del esfuerzo humano y envejecen más que antes.
El equipo rediseña la información que recibe quien resuelve la excepción, mejora una regla de matching y añade un estado específico para diferenciar «pendiente de cliente» de «pendiente de revisión interna».
En la siguiente medición, el backlog antiguo cae y la capacidad de salida aumenta sin subir la tasa de error.
Finanzas no convierte automáticamente todas las horas liberadas en ahorro. Parte del valor se clasifica como capacidad absorbida: el equipo procesa más volumen sin aumentar estructura en la misma proporción. Otra parte puede convertirse en coste evitado si el crecimiento habría exigido una contratación adicional.
El ejemplo muestra por qué medir solo «minutos ahorrados» habría contado una historia incompleta. El diagnóstico cambió al observar flujo, excepciones, calidad y economía de forma simultánea.
La medición no termina el día del despliegue
Una automatización cambia con el proceso que la rodea. Cambian APIs, volúmenes, catálogos, plantillas, personas, reglas y expectativas. Un resultado correcto durante el piloto puede degradarse meses después.
Por eso conviene revisar periódicamente si se mantienen la baseline de referencia, los objetivos, la distribución de tiempos, la calidad, el coste de excepción, la adopción y el coste operativo.
Puede ser útil plantear revisiones a 30, 60 y 90 días en determinados proyectos, pero no como calendario universal. La frecuencia debe responder al ritmo de cambio, volumen, criticidad y capacidad del equipo.
También hay que revisar los propios KPIs. Si una métrica deja de representar el objetivo, conservarla por continuidad puede ser peor que redefinirla.
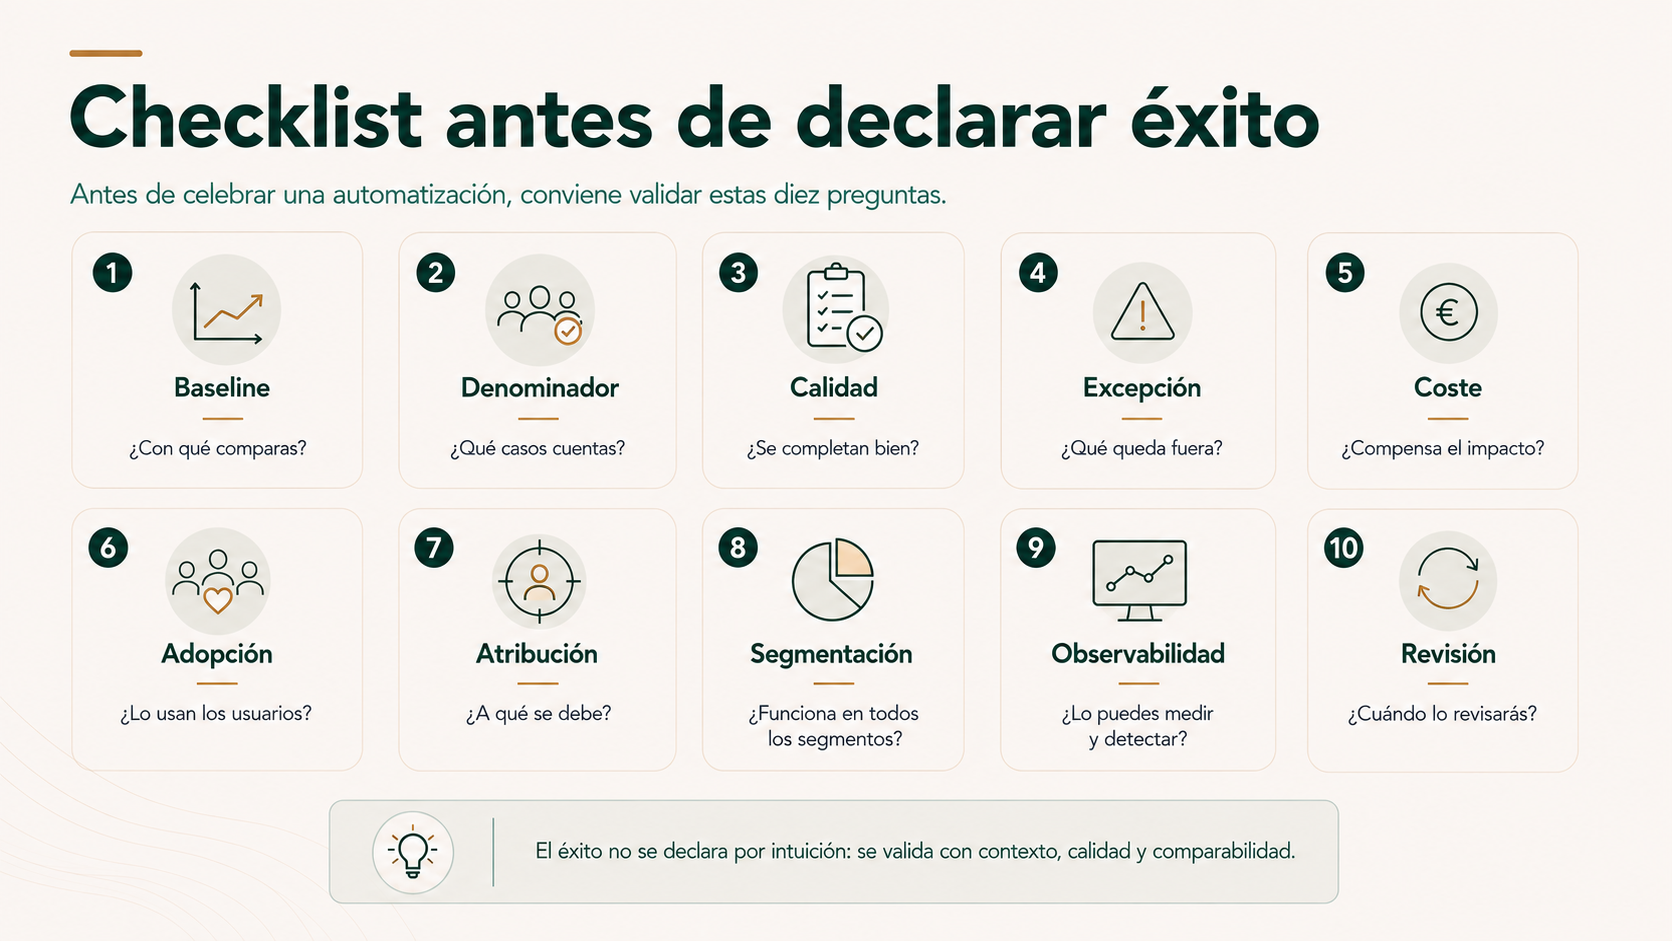
Si no puedes explicar qué mejoró, qué empeoró y cuánto cuesta operar la mejora, todavía no has medido la automatización
La medición útil no consiste en demostrar que el proyecto fue una buena idea. Consiste en saber dónde aporta, dónde falla y qué decisión tomar después.
Eso exige comparar contra una línea base, definir bien el caso y el denominador, mirar el proceso de extremo a extremo y hacer visibles el error, el retrabajo, las excepciones y los circuitos paralelos.
También exige una disciplina económica básica: tiempo liberado no es automáticamente ahorro en caja. Puede convertirse en capacidad, coste evitado, reducción directa o valor generado, pero cada categoría necesita evidencia suficiente.
Una automatización madura no es la que muestra el mayor número de ejecuciones. Es la que puede explicar con datos qué cambió en el negocio y seguir detectando cuando ese resultado empieza a deteriorarse.
DIAGNÓSTICO Y MEDICIÓN
Define cómo medir el proceso antes de automatizarlo
En Yarvia podemos mapear unidad de caso, baseline, objetivos, fuentes de datos, errores, excepciones, coste operativo y criterios de éxito antes de construir o revisar una automatización.
Revisar cómo medir mi procesoFuentes
- NIST — AI Risk Management Framework, AI RMF Core.
Marco voluntario para gestionar riesgos de IA. Se utiliza aquí únicamente cuando la automatización incorpora IA, especialmente para la función MEASURE.
Consultar fuente - Microsoft Azure Well-Architected Framework — Performance monitoring.
Referencia para baselines, latencia, distribuciones y uso de percentiles frente a promedios aislados.
Consultar fuente - Microsoft Azure Well-Architected Framework — Performance testing.
Referencia para el uso de baselines como punto de comparación para detectar mejora o degradación.
Consultar fuente - AWS Well-Architected Framework — Identify key performance indicators.
Referencia para alinear KPIs de observabilidad con objetivos empresariales y evitar métricas técnicas sin relación clara con el resultado.
Consultar fuente - Microsoft Power Automate — Process Mining overview.
Referencia para explicar process mining y el análisis de procesos reales a partir de datos de eventos.
Consultar fuente - Microsoft Power Automate — Process overview y rework metrics.
Referencia de producto para duración de casos, espera, variantes y retrabajo en procesos instrumentados.
Consultar fuente · Consultar fuente
Las métricas, baselines, costes y criterios de éxito deben adaptarse al proceso, al volumen, a la calidad de los datos, al modelo operativo y a las decisiones que la empresa necesita tomar. Los modelos y ejemplos de esta guía son marcos de diseño y medición, no benchmarks universales ni fórmulas contables aplicables sin contexto.
