
GESTORÍAS · AUTOMATIZACIÓN DE PROCESOS
Cómo automatizar el correo de una gestoría: documentos, solicitudes, tareas y seguimiento
La mayoría de gestorías no tienen un problema de correo. Tienen un problema de trabajo que nace en el correo y acaba viviendo en demasiados sitios a la vez: la bandeja, una carpeta, una llamada, una nota interna o la memoria de alguien del equipo.
El objetivo no es vaciar la bandeja. Es que ninguna solicitud relevante dependa de volver a encontrar un email.
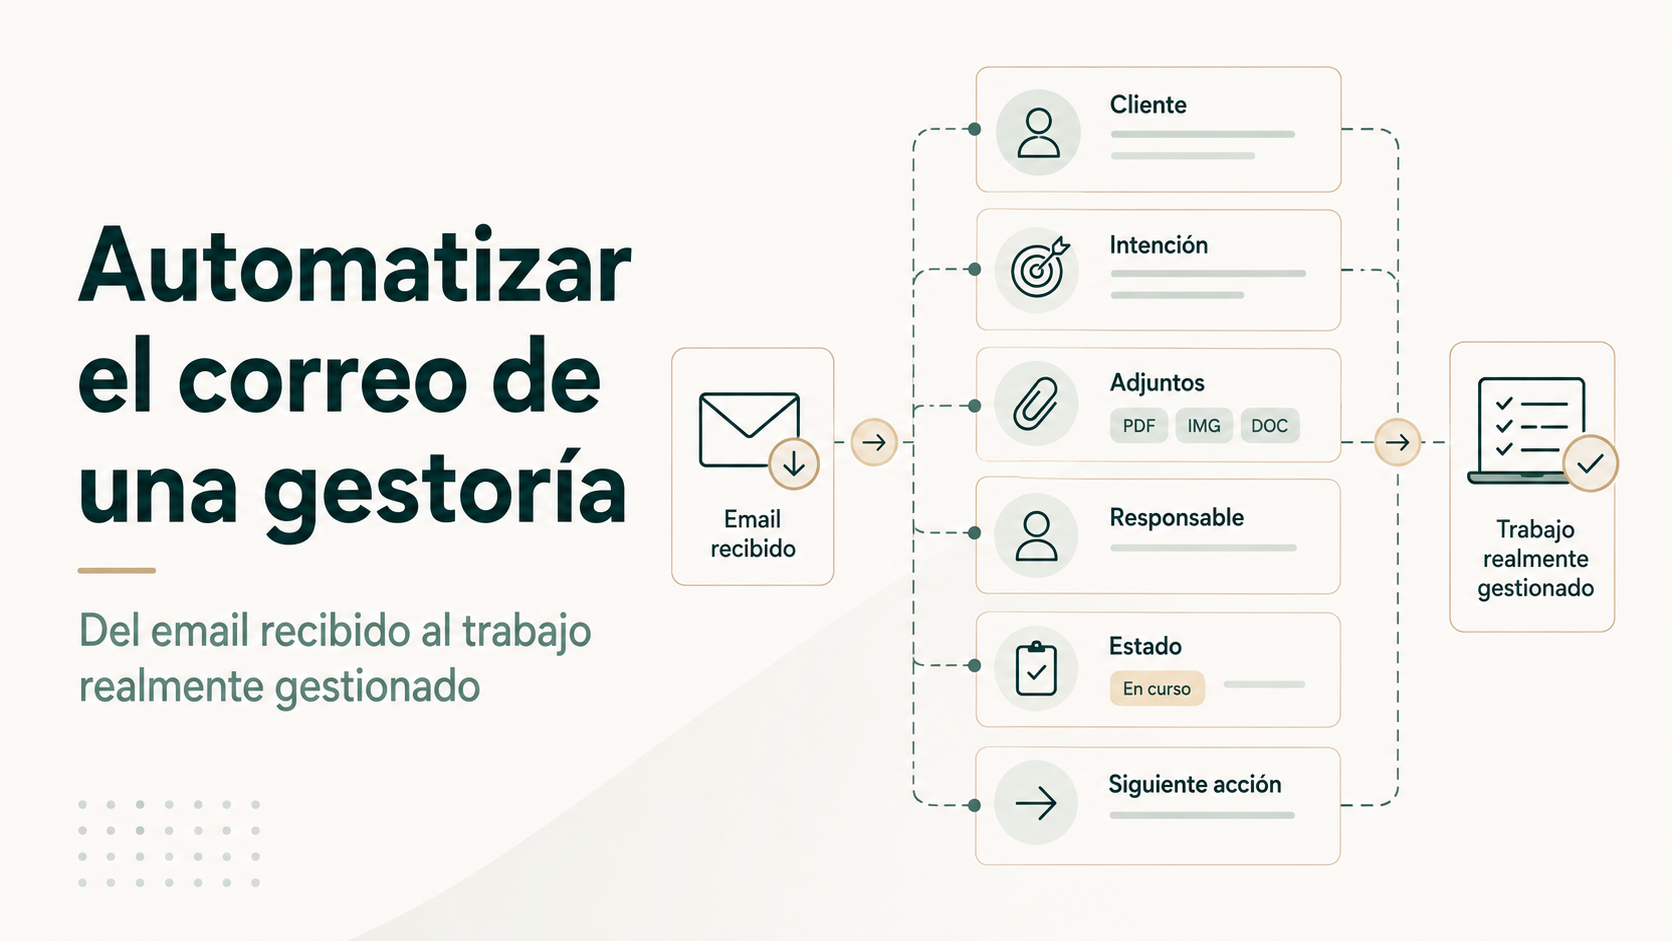
Automatizar el correo de una gestoría no consiste en poner una IA a contestar mensajes. Consiste en transformar un email entrante en un proceso trazable: cliente identificado, intención detectada, documentos tratados, responsable asignado, estado visible y siguiente acción definida.
Cuando el correo funciona como bandeja, gestor documental, lista de tareas y sistema de seguimiento a la vez, los problemas no tardan en aparecer: peticiones duplicadas, tareas sin dueño, adjuntos que nadie sabe dónde acabaron, hilos reabiertos y respuestas que dependen de quien leyó antes el mensaje.
La arquitectura correcta separa evento, identidad, clasificación, procesamiento documental, reglas y escalado profesional. Esa separación permite automatizar con control sin convertir el buzón en una caja negra.
Una bandeja de entrada no es un gestor de procesos
En muchas gestorías, el correo sigue siendo el lugar donde entra casi todo: facturas, altas y bajas, preguntas del cliente, documentación pendiente, confirmaciones, recordatorios, incidencias y mensajes internos. El problema no es que el email exista. El problema es utilizarlo como si fuera, al mismo tiempo, registro de trabajo, sistema de estados, gestor documental y memoria operativa del despacho.
Mientras el volumen es pequeño y el equipo conoce a todos los clientes, ese modelo parece funcionar. Pero a medida que aumentan los buzones compartidos, los expedientes, las excepciones y los miembros del equipo, el correo empieza a mostrar una limitación evidente: un mensaje puede estar leído y seguir sin estar gestionado.
La diferencia es decisiva. Leer un correo no crea responsable. Moverlo a una carpeta no define el siguiente paso. Reenviarlo a un compañero no garantiza seguimiento. Responder “lo revisamos” no cierra el proceso. Y descargar un adjunto no asegura que el documento se haya integrado donde corresponde.
Por eso el enfoque correcto no es preguntarse “¿cómo contesto emails con IA?”, sino “¿cómo hago para que un correo relevante se convierta en una unidad de trabajo controlable?”. Esa es la pregunta que separa una automatización útil de una demostración vistosa.
Qué significa automatizar el correo de una gestoría
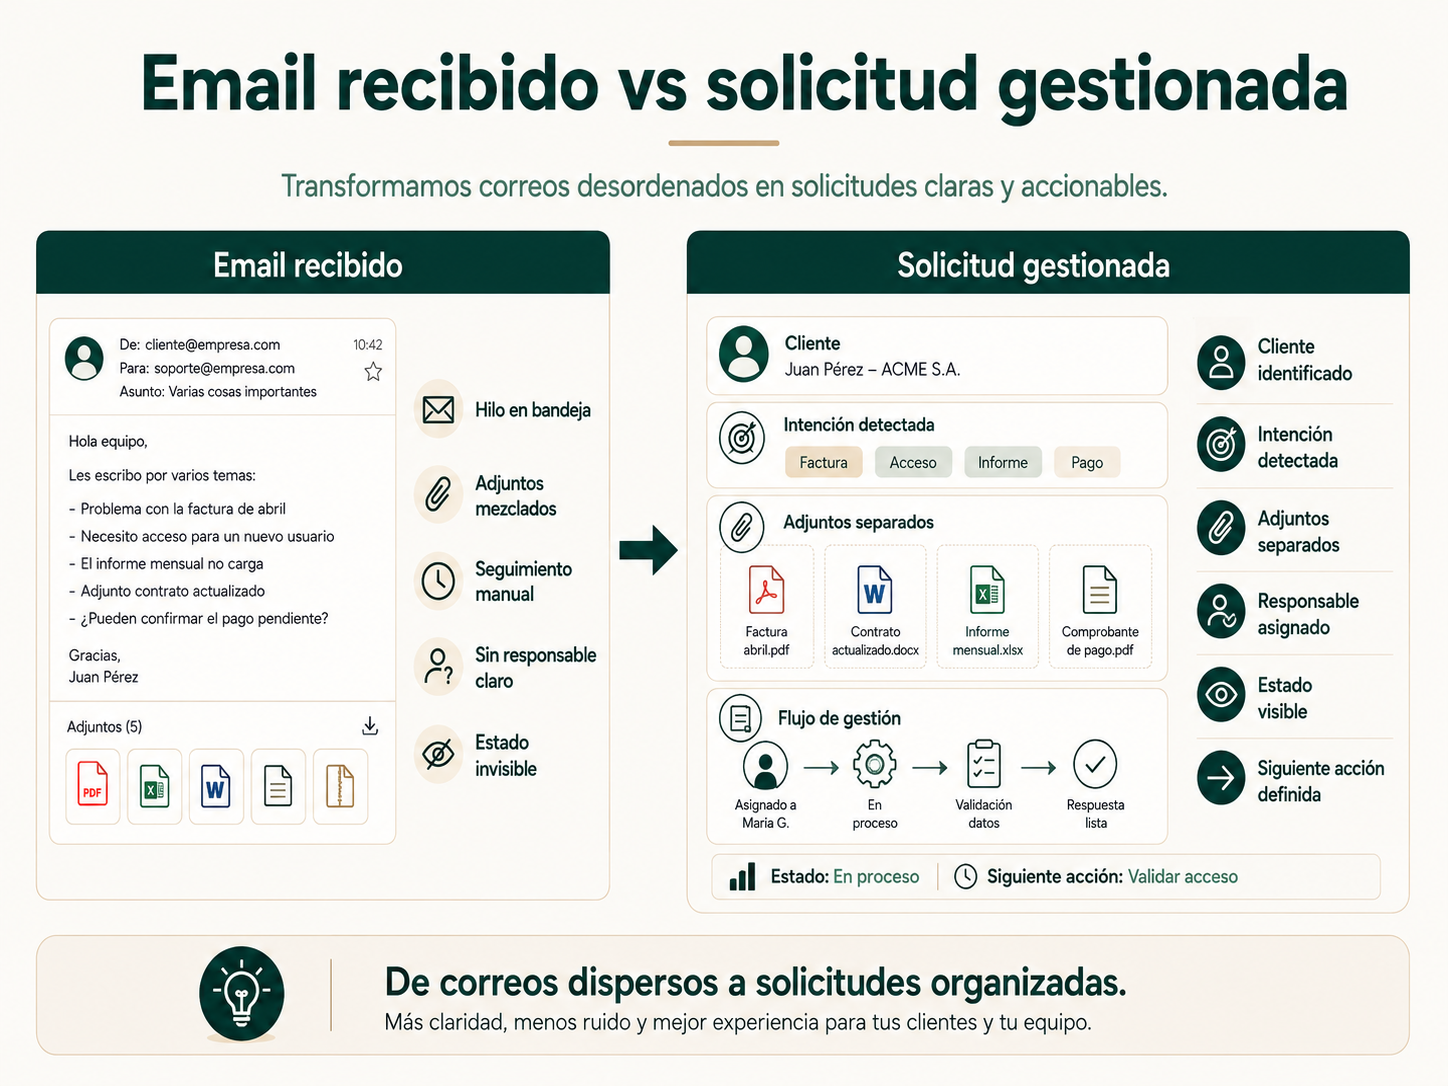
Automatizar el correo de una gestoría significa construir una cadena de decisiones y acciones alrededor del mensaje entrante. El correo sigue siendo el disparador, pero deja de ser el único sitio donde vive el trabajo.
Lo que sí es
- Detectar automáticamente que ha llegado un mensaje relevante.
- Identificar a qué cliente, expediente o contexto pertenece.
- Entender si contiene una o varias solicitudes.
- Separar mensaje y adjuntos para tratarlos correctamente.
- Crear o actualizar tareas, expedientes o circuitos documentales.
- Definir responsable, estado y siguiente acción.
- Responder, pedir datos o escalar solo cuando la política lo permita.
Lo que no es
- Poner una IA a escribir respuestas genéricas.
- Clasificar correos sin traducir esa clasificación a acciones reales.
- Crear reglas y carpetas como si eso sustituyera a un sistema de trabajo.
- Descargar adjuntos automáticamente y dar por hecho que ya están gestionados.
- Dar acceso indiscriminado al buzón completo a cualquier sistema.
- Automatizar consultas profesionales que requieren criterio fiscal, laboral o contable.
La clave está en entender el correo como punto de entrada y no como punto final. Si un cliente escribe para enviar dos facturas, consultar el estado de una presentación y comunicar un alta laboral, el sistema debe ser capaz de convertir ese único email en tres piezas de trabajo distintas o en un flujo compuesto con varias ramas. Si no hace eso, seguirá existiendo una dependencia excesiva de la persona que leyó el mensaje.
Los siete puntos de fuga más habituales del correo
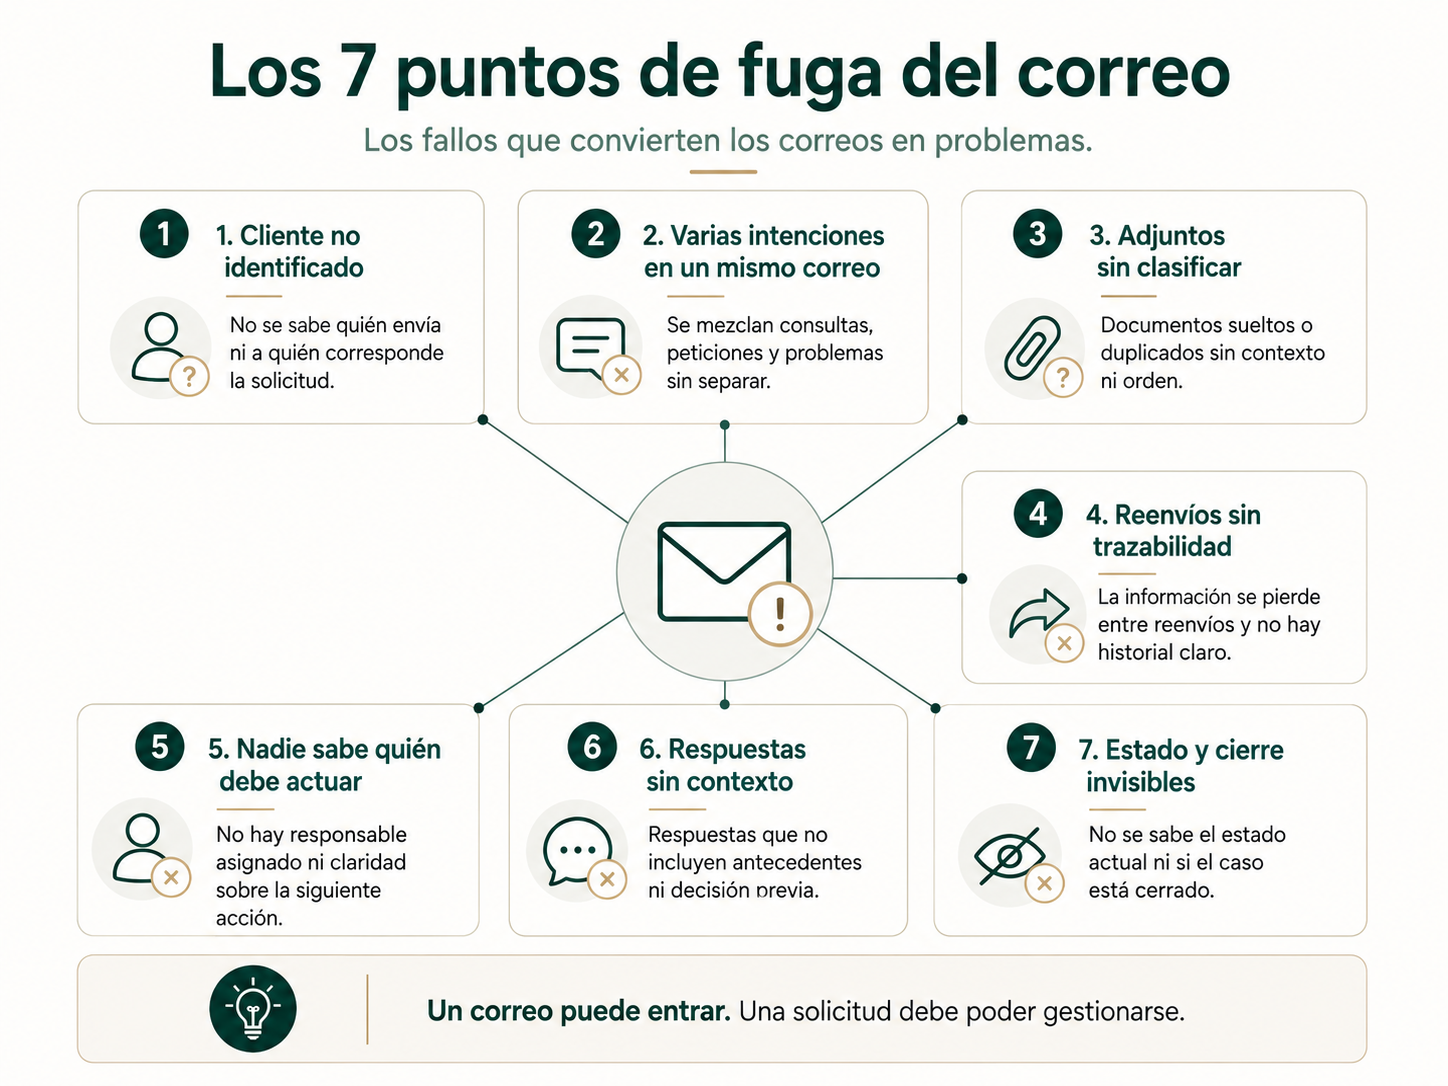
Una bandeja aparentemente bien organizada puede seguir generando fricción operativa. Los fallos repetidos suelen concentrarse en siete puntos:
- Correo leído pero no gestionado. Se abre el mensaje, se entiende el asunto, pero no se crea ninguna acción visible fuera del buzón.
- Solicitud sin responsable. Varios miembros del equipo la ven, pero nadie sabe quién debe actuar primero.
- Adjunto sin trazabilidad. El documento se descarga, se renombra, se vuelve a subir o se reenvía, pero nadie puede reconstruir el recorrido.
- Cliente mal identificado. Llega un mensaje desde una dirección personal, desde un nuevo empleado o desde una asesoría externa, y el sistema no sabe a quién asociarlo.
- Varias intenciones en un mismo correo. Se responde solo a una parte y las demás quedan mezcladas en el hilo.
- Hilos y reenvíos duplicados. El mismo asunto reaparece con otro asunto, en copia o como nuevo correo, y se crean duplicidades.
- Trabajo resuelto fuera del correo. La tarea se completa por teléfono, por WhatsApp o en otra herramienta, pero el estado no se devuelve al sistema.
Un buen proyecto de automatización del correo no empieza por redactar respuestas. Empieza por cerrar estos puntos de fuga. En otras palabras: antes de decidir qué parte del buzón puede automatizarse, conviene decidir qué información hace falta para considerar que una solicitud está realmente bajo control.
El caso conductor: un correo con tres intenciones distintas
Imagina esta situación. Un cliente escribe al buzón general de la gestoría a las 18:47. En el cuerpo del mensaje pregunta si ya está presentado un determinado modelo. Adjunta dos facturas para contabilizar. Y añade, al final, que ha incorporado a un nuevo trabajador y necesita saber qué documentación tiene que enviar.
Ese correo parece uno solo. Operativamente, no lo es. Contiene al menos tres líneas de trabajo diferentes:
- Una consulta de estado.
- Un envío documental que debe entrar en el circuito correcto.
- Una comunicación laboral que exige pedir información adicional y activar otro proceso.
Si la persona que lo lee responde solo a la primera parte, o reenvía el email a dos compañeros diferentes, la información sigue prisionera del hilo. Si en cambio el sistema es capaz de separar las tres intenciones, relacionarlas con el cliente, enviar los adjuntos al proceso documental y abrir una tarea de alta laboral con datos pendientes, entonces el correo ya ha dejado de ser un simple mensaje para convertirse en un proceso estructurado.
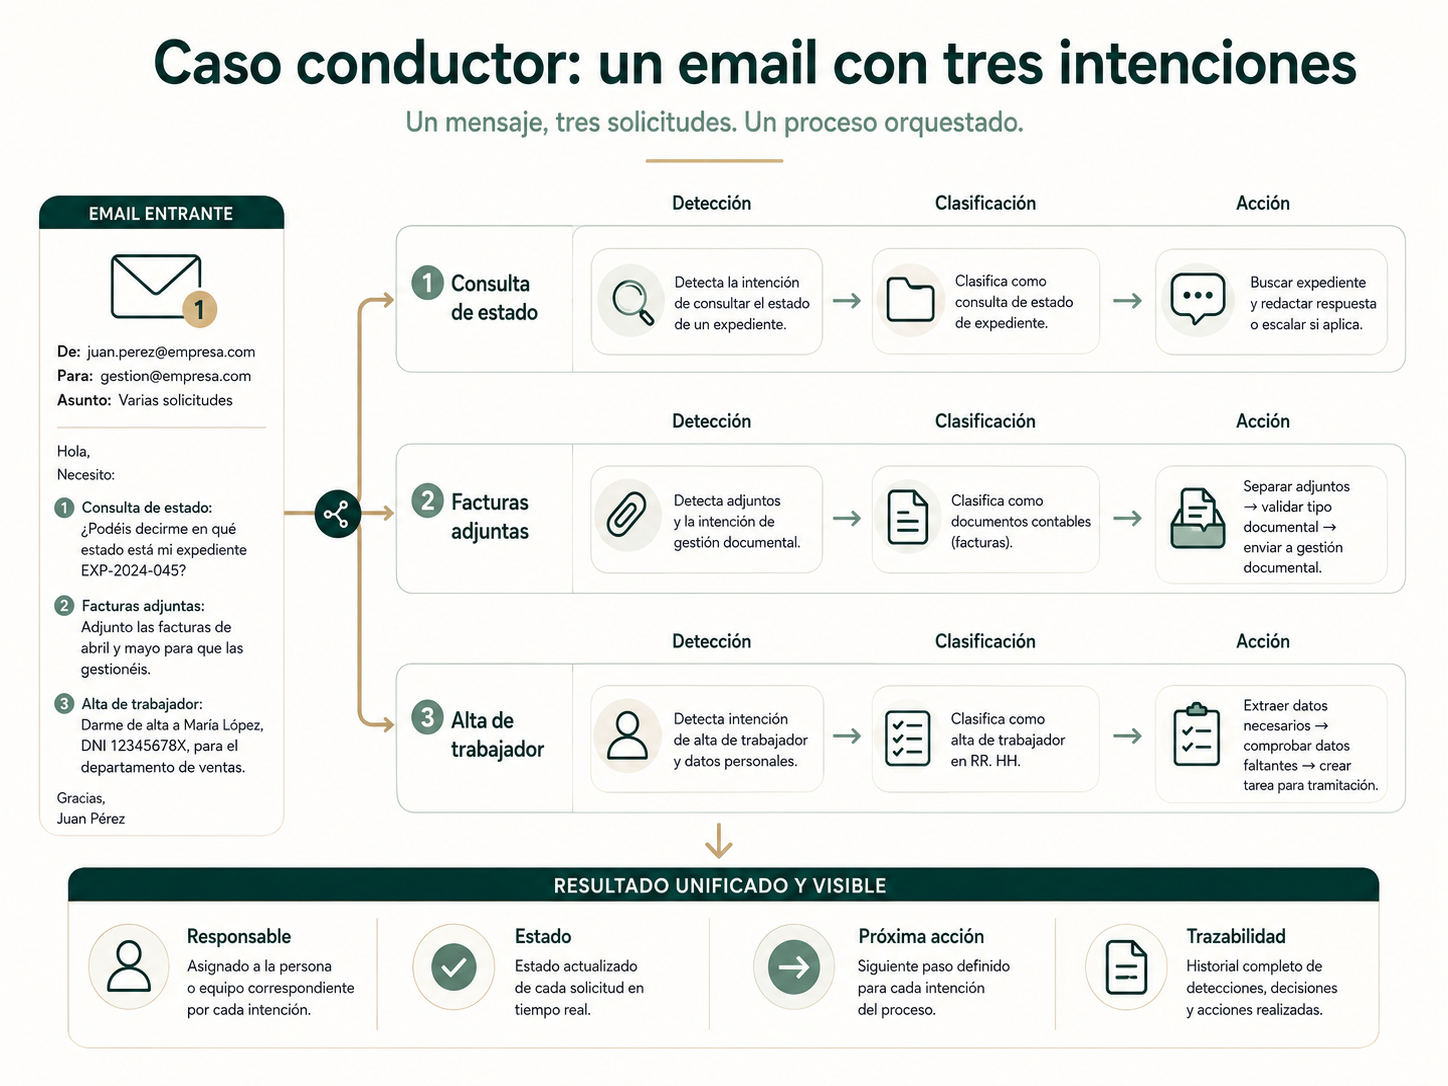
Ese es el criterio que debe guiar todo el artículo: un correo puede contener varias unidades de trabajo, y una automatización madura tiene que ser capaz de separarlas.
Cómo detectar correos nuevos sin depender de que alguien revise la bandeja
El primer paso técnico consiste en detectar que existe un mensaje nuevo o un cambio relevante en el buzón. Aquí conviene separar dos capas que a menudo se confunden: el proveedor del buzón y el programa con el que una persona lo consulta.
Por ejemplo, una gestoría puede usar Gmail como servicio de correo y abrirlo en el navegador, en Outlook o en Thunderbird. También puede usar Microsoft 365 y consultarlo desde Outlook de escritorio, Outlook web o el móvil. Incluso puede tener un servidor IMAP y usar Thunderbird como cliente principal. La automatización se integra con el sistema donde vive realmente el buzón o con el protocolo disponible, no con el gesto humano de abrir el correo desde una aplicación concreta.
Por eso es importante distinguir:
Cuando existe API o sistema de eventos
Plataformas como Gmail o Microsoft 365 permiten enterarse de cambios en el buzón mediante mecanismos de notificación. Dicho en lenguaje sencillo, el sistema “avisa” de que ha ocurrido algo y la automatización consulta el detalle para decidir qué hacer.
Cuando solo hay IMAP o acceso más limitado
La alternativa es el polling: revisar periódicamente si hay mensajes nuevos. No es tan elegante como recibir una notificación, pero puede ser suficiente en muchos casos si se controla bien la frecuencia, los duplicados y los errores.
Aquí aparecen dos términos técnicos que conviene entender:
- Webhook o notificación: un aviso automático de que se ha producido un cambio.
- Polling: una revisión periódica para preguntar si ha pasado algo nuevo.
Y hay un tercer término clave: idempotencia. En lenguaje llano significa que si el sistema recibe dos veces el mismo evento o vuelve a revisar un mensaje ya tratado, no debe ejecutar dos veces la misma acción. Es una condición básica. Sin ella, un reintento técnico podría crear dos tareas, dos expedientes o dos entradas documentales idénticas.
En la práctica, eso obliga a guardar identificadores del mensaje, del hilo o del evento técnico y a diseñar una lógica de reconciliación: si se perdió una notificación o el sistema estuvo caído, debe poder recuperar lo que ocurrió sin rehacer trabajo ya procesado.
Identificar correctamente al cliente: remitente no siempre significa identidad
Uno de los errores más peligrosos en este tipo de proyectos consiste en asumir que el remitente del correo identifica de forma inequívoca al cliente. A veces ocurre. Muchas otras no.
Un cliente puede escribir desde una dirección personal, desde una cuenta de un empleado nuevo, desde la asesoría jurídica externa, desde una central de compras o desde un tercero autorizado. En sentido contrario, una misma dirección puede usarse para varios asuntos o varias sociedades del mismo grupo.
Por eso la capa de identidad debe combinar varias señales:
- Dirección del remitente.
- Dominio del correo.
- Firma del mensaje.
- Asunto y referencias internas.
- Datos que ya existen en CRM, ERP o directorio de clientes.
- Histórico de conversaciones anteriores.
El resultado no tiene por qué ser binario. En muchos casos lo razonable es trabajar con un nivel de confianza: alta, media o baja. Cuando la confianza es alta, el flujo puede continuar. Cuando es media, quizá convenga generar un borrador o pedir validación. Cuando es baja, el caso debe escalarse antes de tomar decisiones que puedan mezclar información entre clientes.
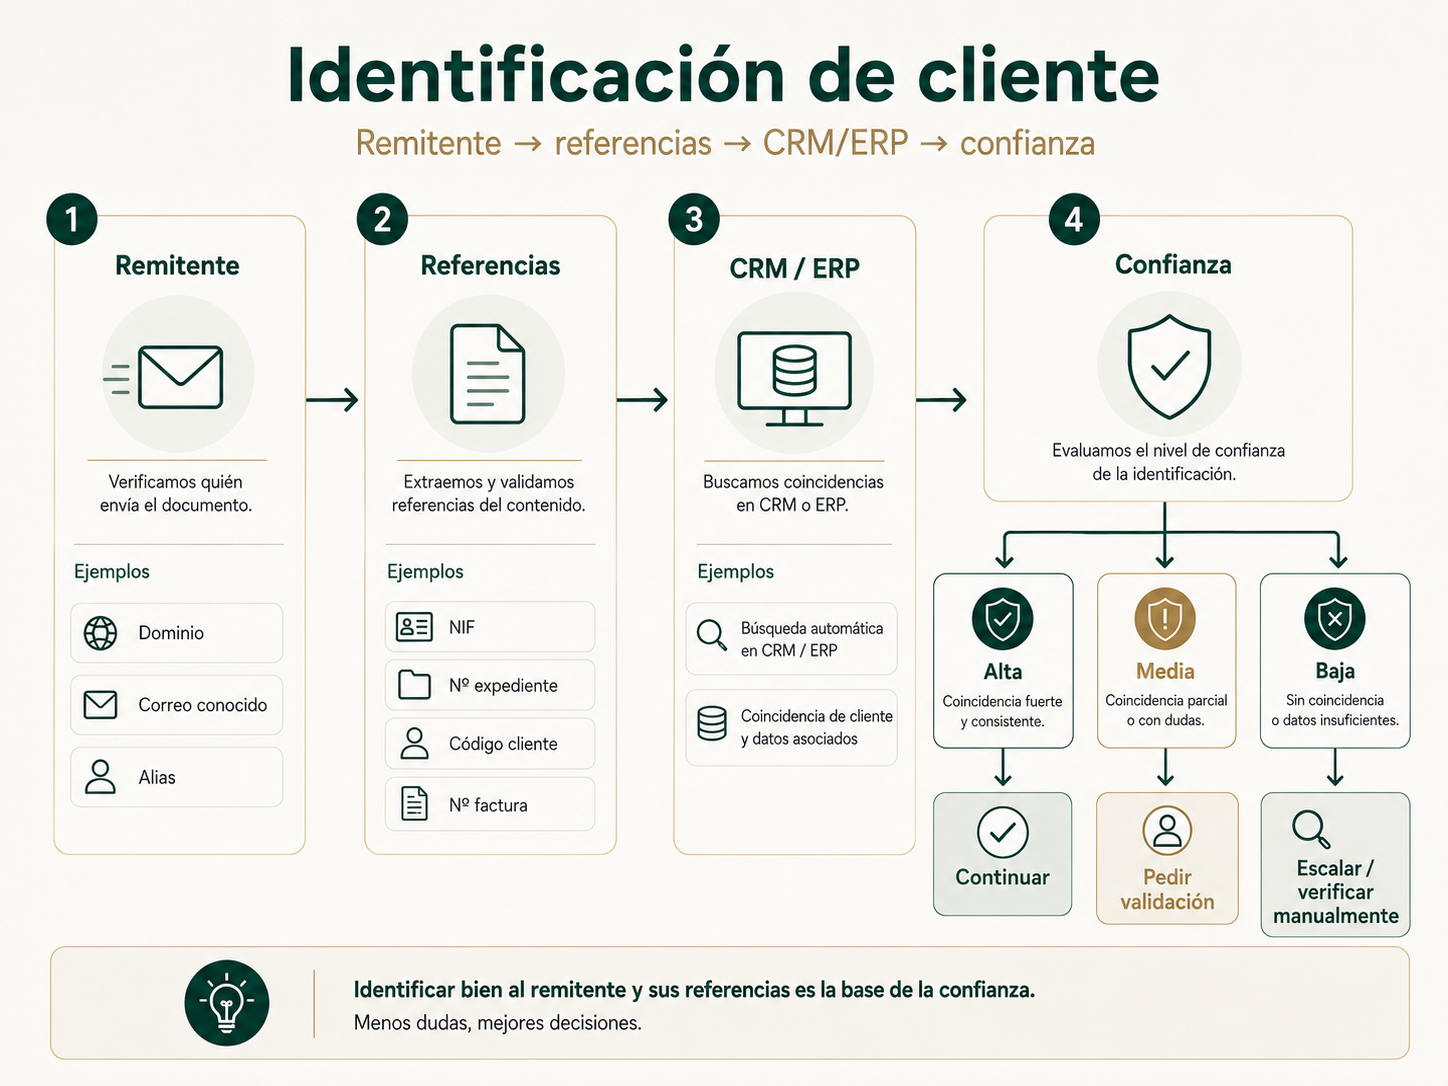
En una gestoría, esta capa no es un detalle técnico. Es una barrera de seguridad operativa. Si se falla aquí, todo lo demás se vuelve poco fiable: documentos mal asociados, respuestas enviadas al contexto incorrecto o tareas abiertas para quien no corresponde.
Clasificar no es gestionar: el email puede ser una categoría, varias intenciones o ambas cosas
Una vez identificado el contexto, el sistema necesita entender qué contiene el correo. Aquí puede haber reglas deterministas, IA asistida o una combinación de ambas. Pero conviene no confundir tres cosas diferentes:
| Concepto | Qué significa | Qué no resuelve por sí solo |
|---|---|---|
| Categoría | Tipo general del mensaje: facturas, laboral, consulta, proveedor, cliente, etc. | La acción exacta que debe ejecutarse. |
| Intención | Lo que el remitente quiere conseguir: enviar documentación, pedir estado, alta de trabajador, modificar datos, reclamar, etc. | Quién debe hacerlo y con qué reglas. |
| Urgencia o prioridad | Cuándo debe tratarse o cuánto riesgo operativo tiene esperar. | El proceso completo ni su resolución. |
Esto es importante porque un mismo correo puede pertenecer a una categoría y, al mismo tiempo, contener varias intenciones. El caso conductor lo demuestra bien: el mensaje puede etiquetarse como “cliente” o “gestión fiscal/laboral”, pero en realidad dispara tres rutas distintas.
La IA puede ser útil aquí porque permite interpretar lenguaje menos estructurado, detectar resúmenes y separar asuntos mezclados. Pero la IA no debería ser quien decida de forma autónoma una acción profesional. Su papel más útil suele ser proponer estructura: qué cree que pide el cliente, qué documentos detecta, qué datos faltan y qué proceso probablemente se activa. Después, las reglas y la política del despacho determinan qué puede ejecutarse solo y qué requiere revisión.
En otras palabras: la clasificación sirve para orientar el flujo; no sustituye al flujo.
Correo y adjuntos como objetos separados
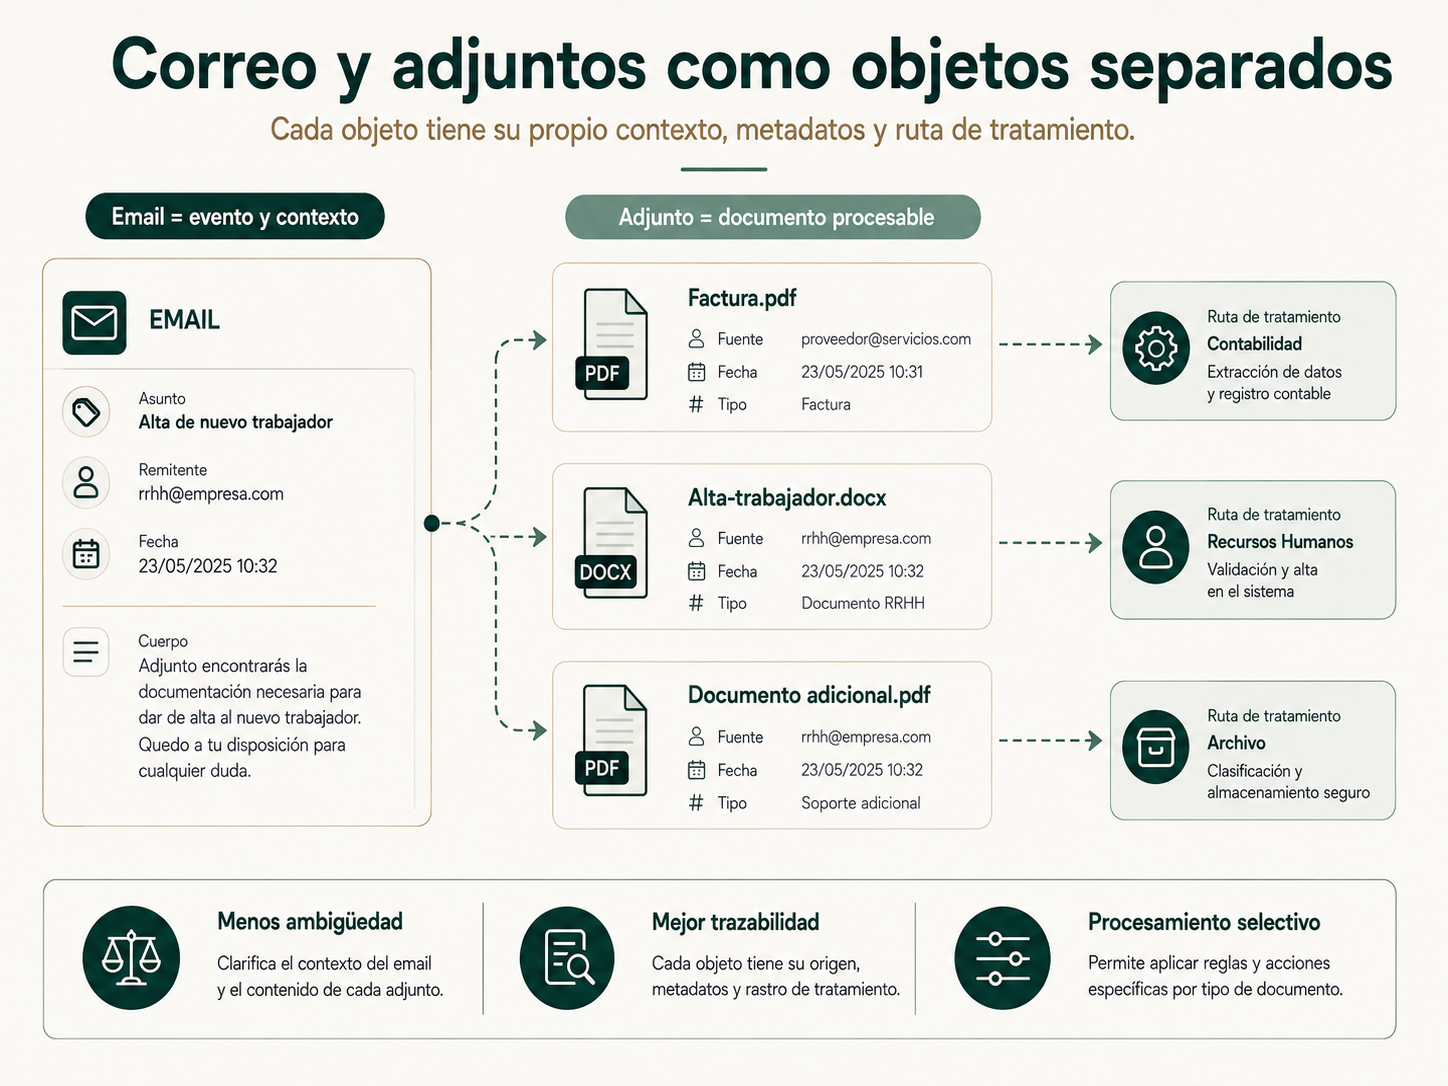
Otra fuente frecuente de errores es tratar el adjunto como si fuera una simple propiedad del correo. Desde un punto de vista operativo, no lo es. El mensaje y el documento deben poder seguir recorridos distintos.
Por ejemplo, unas facturas adjuntas pueden tener que pasar a un circuito documental como el que ya explicamos en automatización documental en gestorías, mientras que el texto del correo puede limitarse a registrar el contexto, la fecha y la intención. Si ambos elementos quedan fundidos en un único “email gestionado”, la trazabilidad se debilita.
La práctica recomendable consiste en separar varias capas:
- Metadatos del mensaje: remitente, asunto, fecha, identificadores, hilo.
- Cuerpo del mensaje: texto que debe clasificarse o resumirse.
- Adjuntos: archivos con su propio tratamiento.
- Relación entre ambos: qué documentos viajaban en ese correo y con qué solicitud estaban asociados.
Además, conviene tener un espacio de staging. Dicho en lenguaje simple, es una zona intermedia donde el documento entra antes de darse por bueno. Allí puede clasificarse, comprobarse si es duplicado, validar si pertenece a ese cliente y decidir si ya puede avanzar o si necesita revisión. Ese staging evita el salto directo desde “ha llegado por email” a “ya está integrado”.
De email a estado operativo: responsable, siguiente acción y cierre
Si el objetivo es dejar de depender de la bandeja, la automatización tiene que desembocar en estados visibles. No basta con clasificar, ni con almacenar un resumen, ni con mover el correo a una carpeta. Debe existir un punto donde el despacho pueda responder con claridad a preguntas como estas:
- ¿Quién tiene ahora la pelota?
- ¿Qué falta para considerar esto resuelto?
- ¿Qué siguiente acción está pendiente?
- ¿Desde cuándo está esperando?
- ¿Qué documentación o contexto tiene asociado?
Un modelo simple y útil puede incluir estados como: recibido, identificado, clasificado, pendiente de acción, esperando cliente, esperando interno, en revisión profesional, resuelto, cerrado y error/excepción. La lista concreta puede variar, pero lo importante es que exista una traducción clara entre estado y acción.
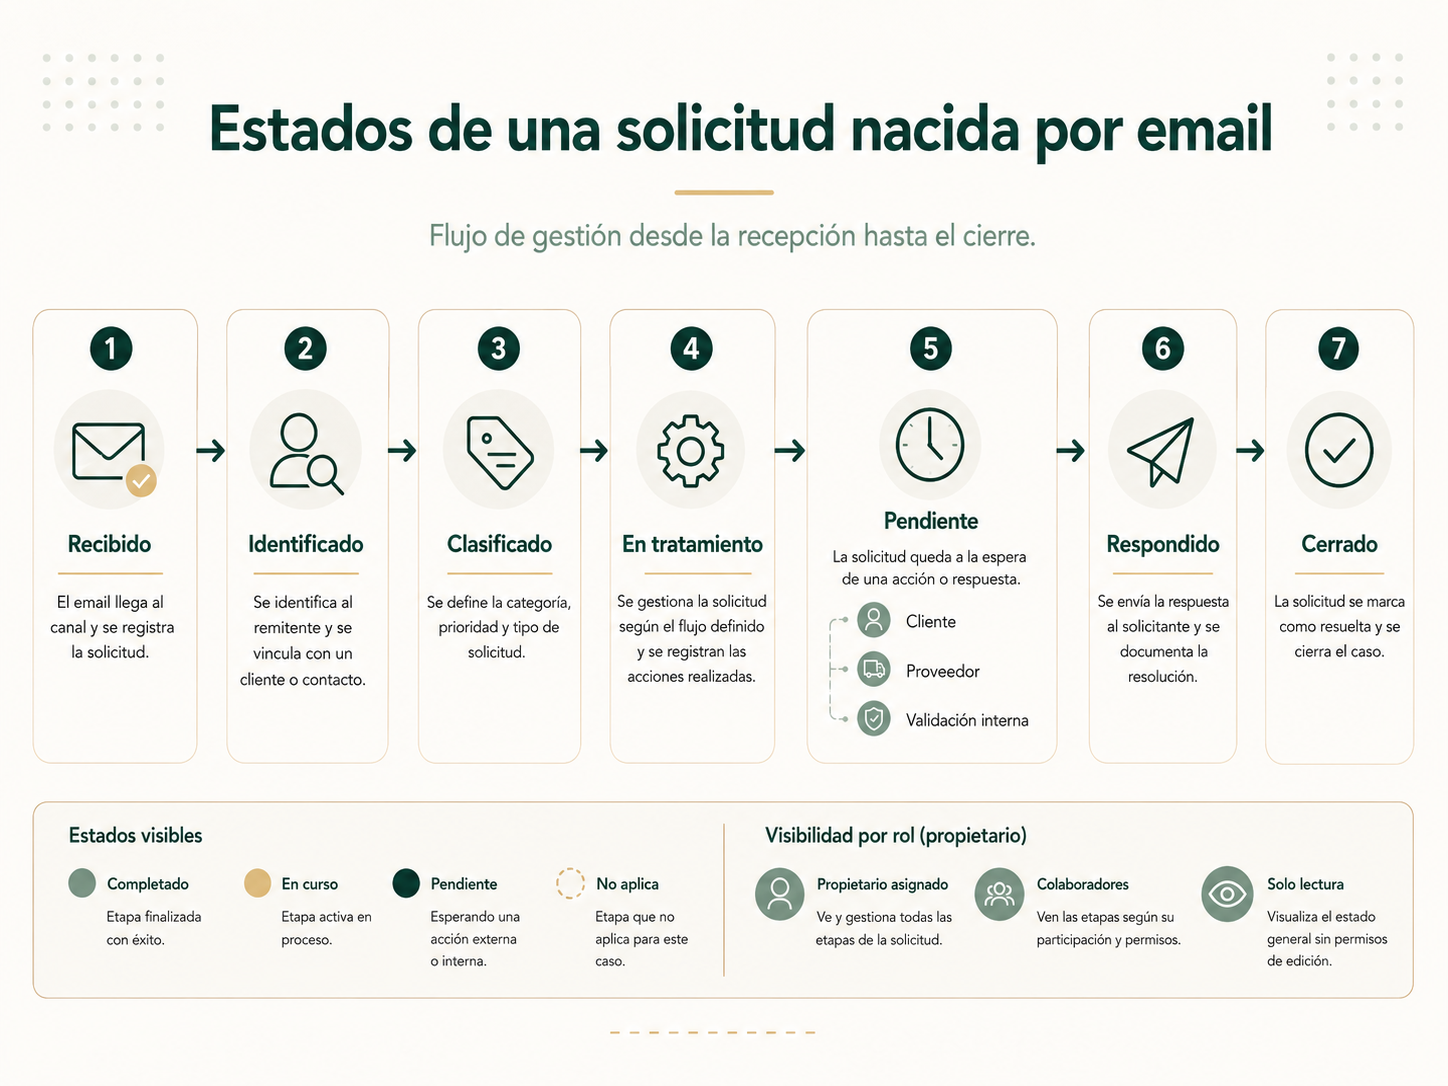
Este enfoque tiene además una consecuencia sana: obliga a definir políticas antes de automatizar. Por ejemplo, ¿cuándo una solicitud laboral pasa de “pendiente de datos” a “lista para tramitar”? ¿Quién puede cerrar una consulta? ¿Qué se considera “resuelto” si la respuesta dependía de confirmar un dato con el cliente?
Sin esas definiciones, la automatización solo acelera el caos. Con ellas, se convierte en un sistema de disciplina operativa.
Respuesta automática, borrador asistido y escalado profesional
Una vez creado el estado, llega la pregunta habitual: ¿qué parte del proceso puede responderse sola? La respuesta corta es: solo lo que sea administrativo, acotado y respaldado por una fuente fiable.
Hay tres niveles razonables:
Automático
Acuse de recibo, confirmación de que los documentos han entrado en revisión o petición estandarizada de un dato concreto que falta.
Borrador asistido
El sistema propone una respuesta con el contexto ya resumido, pero la envía una persona del equipo tras validarla.
Escalado profesional
Cuando la consulta requiere interpretación fiscal, laboral, contable o jurídica, el sistema no responde solo. Se limita a preparar el contexto, señalar el riesgo o pedir revisión.
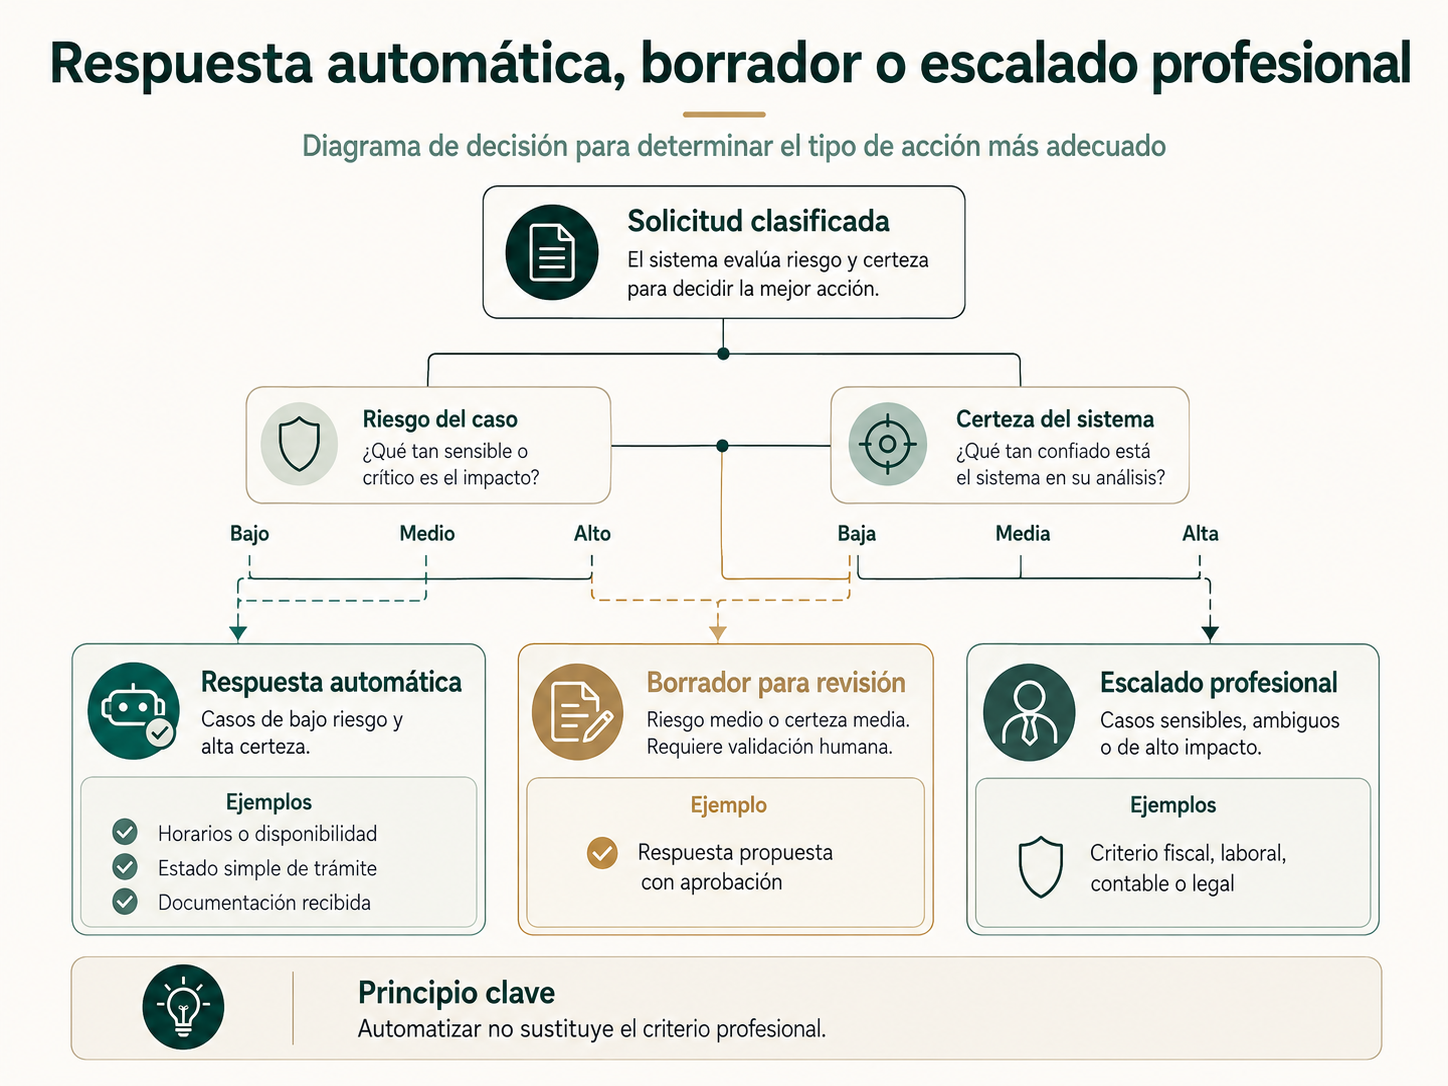
Esta separación evita un error muy frecuente: querer automatizar la parte más visible —la respuesta— antes de tener bajo control las capas invisibles —identidad, estado, fuente, permisos y trazabilidad—. Lo útil no es presumir de respuesta automática. Lo útil es que el despacho sepa cuándo puede usarla y cuándo no.
Privacidad, minimización, permisos y separación entre clientes
El correo de una gestoría contiene datos personales, documentos sensibles y, en algunos casos, información especialmente delicada. Por eso no basta con que la automatización “funcione”. Tiene que hacerlo respetando una lógica de mínima exposición.
Hay cuatro principios prácticos:
- Minimización. Procesar solo el contenido necesario para la tarea. No todo el buzón debe pasar por el mismo tratamiento.
- Separación de clientes. La identificación dudosa no puede resolverse arriesgando mezcla de datos entre expedientes o empresas distintas.
- Permisos. El sistema y las personas deben acceder solo a la información que realmente necesitan.
- Trazabilidad. Debe quedar registro de qué se detectó, qué se decidió y qué acción se ejecutó.
Esto obliga, por ejemplo, a evitar que un modelo reciba indiscriminadamente el histórico completo del buzón cuando solo necesita un correo o un hilo concreto. También obliga a revisar cómo se guardan logs, resúmenes y adjuntos, y qué equipos pueden consultar cada información.
La seguridad no es un bloque que se añade al final. En este tipo de proyectos, la seguridad es parte de la arquitectura.
Arquitectura técnica de referencia de un buzón automatizado
Una arquitectura razonable para este caso suele tener varias capas bien separadas:
- Entrada del correo. Gmail, Microsoft 365 o un buzón accesible por IMAP.
- Detección de cambios. Notificaciones, suscripciones o polling programado.
- Normalización. Extracción de metadatos, cuerpo, hilo y adjuntos.
- Control de idempotencia. Protección para no procesar dos veces el mismo evento o mensaje.
- Resolución de identidad. Cruce con CRM, ERP, directorios o tablas internas.
- Clasificación e interpretación. Reglas e IA asistida para detectar intención o múltiples solicitudes.
- Procesamiento documental. Entrada en staging de adjuntos, validación y circuito correspondiente.
- Motor de reglas. Decide qué se crea, qué se responde, qué se pide y qué se escala.
- Integraciones de negocio. CRM, ERP, gestor de tareas, expediente o herramienta sectorial.
- Observabilidad y revisión humana. Logs, reintentos, cola de errores, auditoría y equipo responsable.
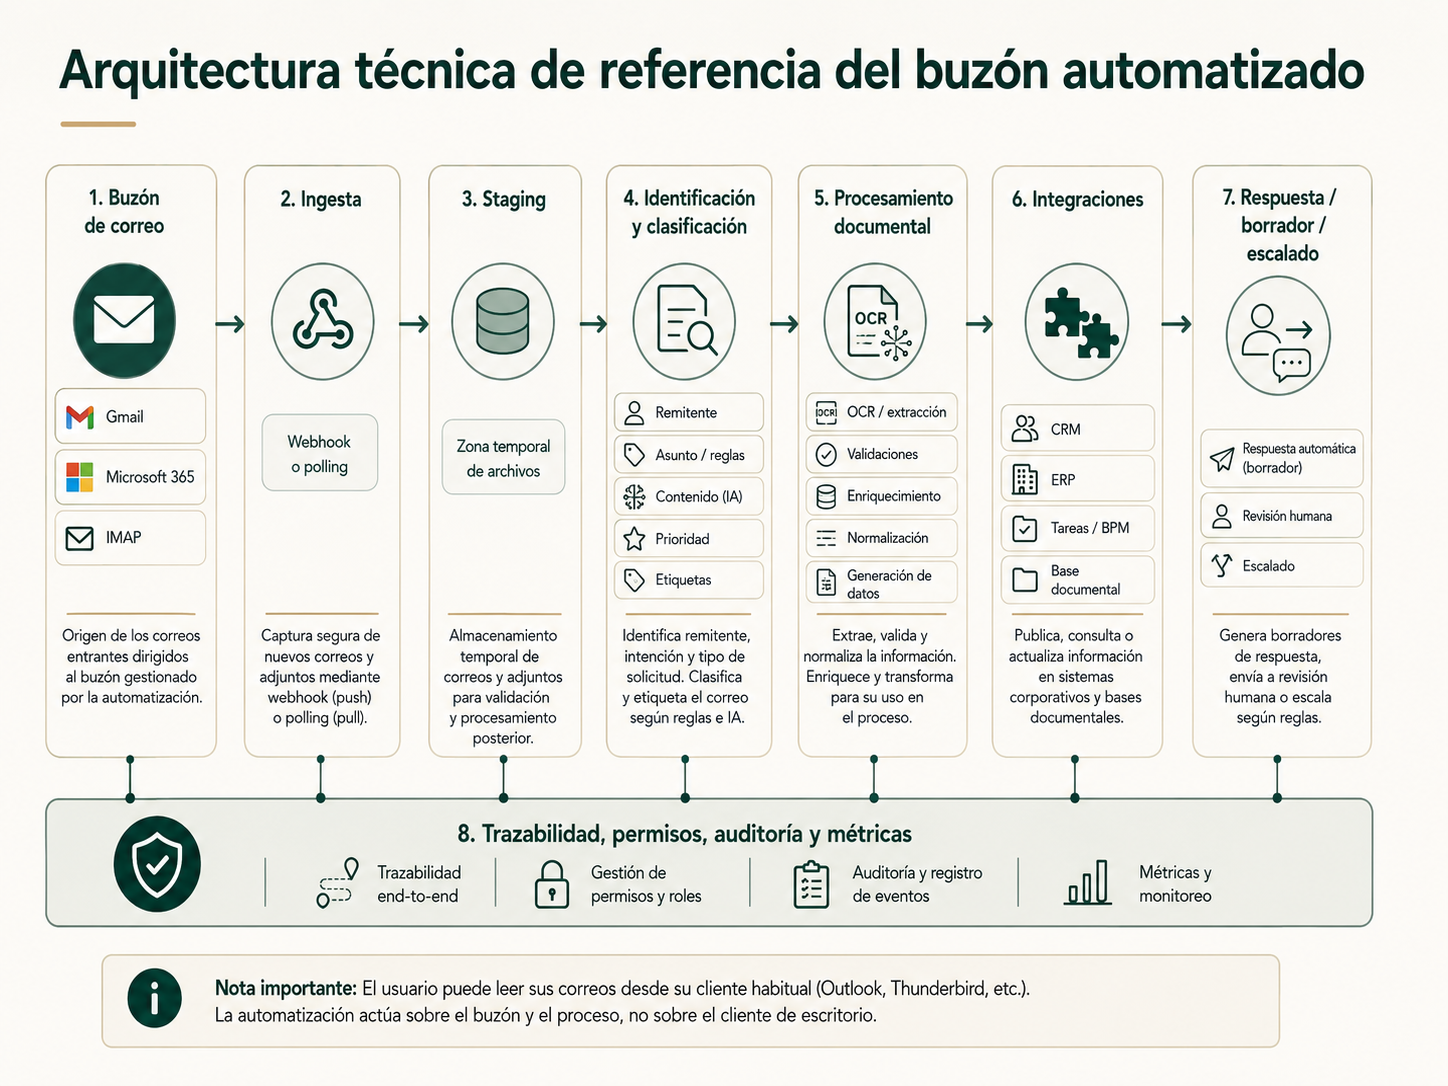
Esta estructura permite además convivir con diferentes formas de trabajo. Algunas gestorías necesitarán una integración fuerte con su ERP o software sectorial. Otras empezarán por crear tareas y paneles de seguimiento antes de conectar toda la capa documental. No hace falta hacer todo a la vez. Sí hace falta que el diseño permita crecer sin rehacerlo desde cero.
Métricas que sí indican si el correo está bajo control
Una automatización del correo no debería medirse por “número de correos clasificados” ni por “porcentaje de automatización” en abstracto. Lo que interesa es saber si el despacho controla mejor el trabajo que nace en el buzón.
Algunas métricas útiles son:
- Tiempo hasta primera acción válida.
- Solicitudes sin responsable.
- Pendientes sin siguiente acción.
- Correos con varias intenciones detectadas.
- Adjuntos enviados a proceso documental frente a adjuntos descartados o duplicados.
- Escalados a revisión profesional.
- Reaperturas o hilos que vuelven a activarse.
- Porcentaje de respuestas automáticas corregidas manualmente.
- Errores técnicos y reprocesos evitados por idempotencia.
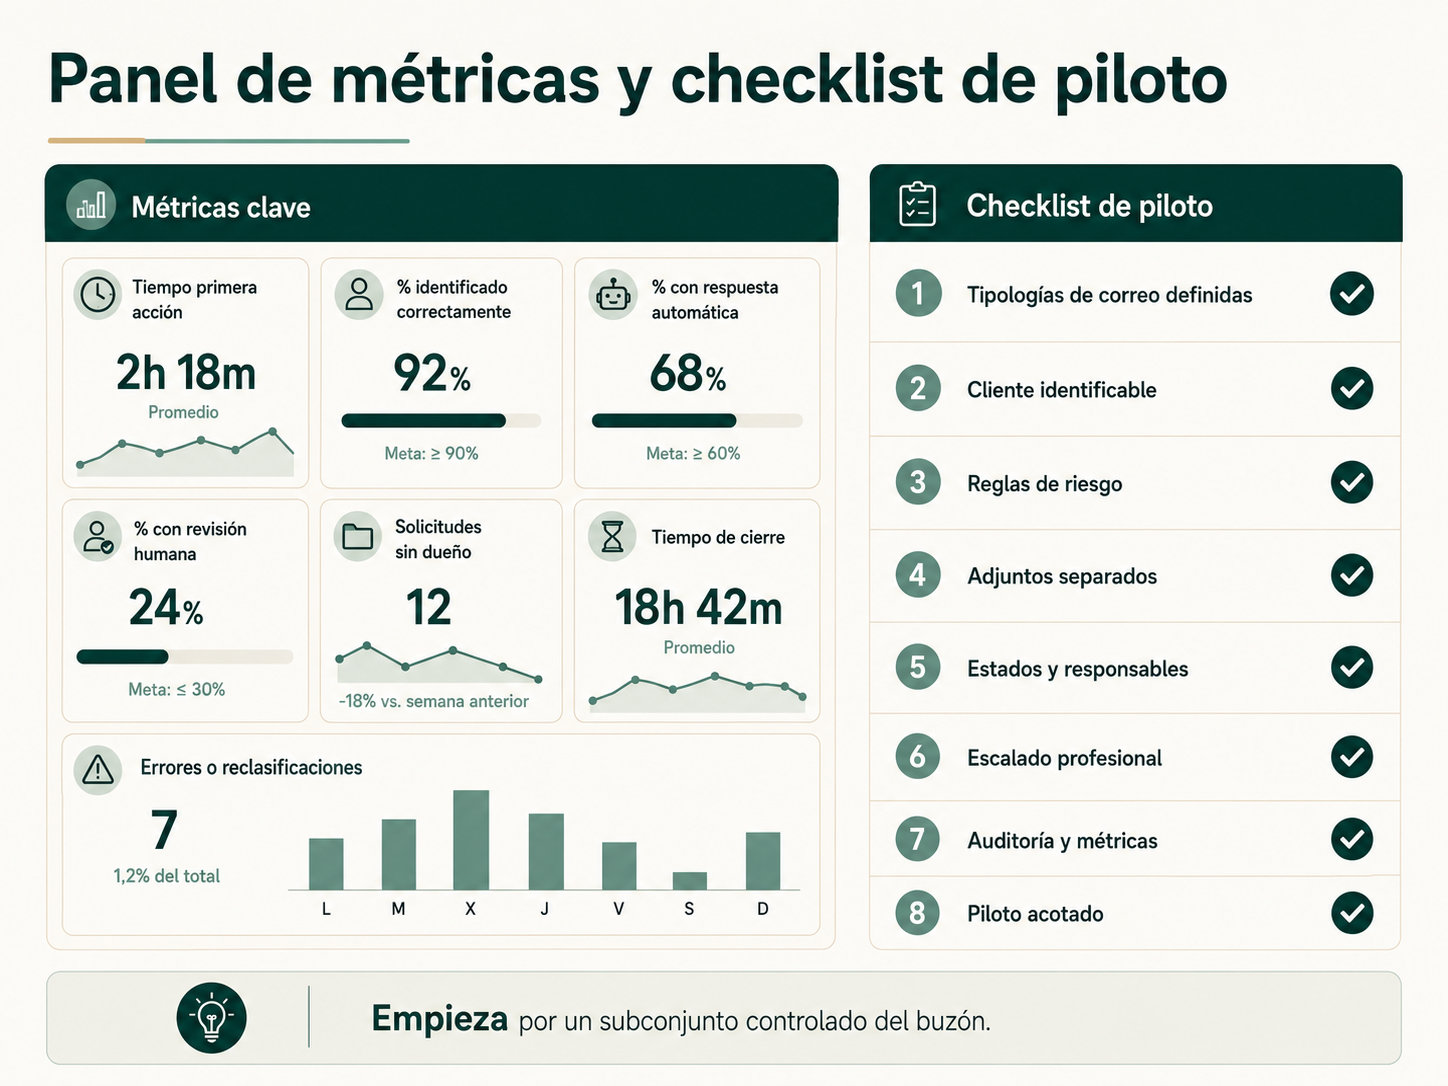
Estas métricas son mucho más útiles que presumir de “IA en el buzón”. Lo que le importa al negocio es otra cosa: si se pierden menos cosas, si el equipo trabaja con menos fricción y si el cliente obtiene una respuesta o una gestión más consistente.
Cómo diseñar un piloto útil sin intentar automatizar todo el despacho de golpe
La forma más sensata de empezar no es conectar todos los buzones y toda la casuística desde el primer día. Es escoger un tramo manejable con suficiente volumen y reglas razonables. Por ejemplo:
- Un buzón compartido concreto.
- Un tipo de solicitud repetitiva.
- Una tipología documental muy frecuente.
- Un equipo o área concreta del despacho.
El piloto debería recorrer, como mínimo, estas fases:
- Mapear el flujo actual. Qué entra, quién lo toca, dónde se pierde y dónde se decide.
- Definir estados y responsables. Sin esa parte, no hay base operativa.
- Seleccionar una muestra real. Preferiblemente histórica, controlada y representativa.
- Arrancar en modo observación. Primero clasificar y proponer; después ejecutar acciones limitadas.
- Activar automatismos por capas. Antes creación de tarea que respuesta automática; antes adjunto en staging que integración definitiva.
- Medir y corregir. No solo exactitud, también impacto operativo real.
En términos prácticos, suele ser mejor empezar por hacer visible el trabajo que por intentar cerrarlo de forma autónoma. Si el piloto logra convertir correos relevantes en tareas, expedientes o flujos con estado, ya habrá creado una mejora operativa importante. La respuesta automática vendrá después, donde tenga sentido.
Qué no deberías automatizar todavía
Hay procesos que conviene dejar fuera, al menos al principio:
- Consultas que requieren interpretación profesional y no solo información administrativa.
- Casos en los que el cliente no puede identificarse con suficiente confianza.
- Acciones irreversibles o sensibles sin una fuente de verdad fiable.
- Buzones cuyo trabajo ni siquiera tiene estados definidos.
- Respuestas automáticas a situaciones ambiguas o emocionalmente delicadas.
- Integraciones que escriben directamente en sistemas críticos sin capa de validación.
La regla es sencilla: si el despacho todavía no sabe cómo quiere decidir ese caso, la automatización no debería decidirlo por él.
Conclusión: el valor no está en responder más rápido, sino en trabajar con menos incertidumbre
Cuando una gestoría automatiza bien el correo, no está “modernizando la bandeja”. Está construyendo una capa de control sobre un canal del que nacen demasiados plazos y tareas recurrentes. El resultado no debería medirse solo por la velocidad de respuesta, sino por algo más importante: menos trabajo huérfano, menos documentos perdidos, menos duplicados, menos dependencia de la memoria de cada persona y más trazabilidad.
El correo seguirá existiendo. Lo que puede desaparecer es la costumbre de usarlo como si fuera el único sistema de gestión disponible. Ese cambio es menos vistoso que prometer una IA que responde todo. También suele ser bastante más útil.
¿Quieres revisar si el correo de tu gestoría está generando trabajo invisible?
En Yarvia analizamos cómo entra el trabajo en el despacho, qué solicitudes se mezclan en el buzón, qué parte puede automatizarse con seguridad y qué debe seguir bajo criterio humano.
Solicitar diagnósticoPreguntas frecuentes
¿Se puede automatizar un buzón compartido de una gestoría?+
Sí, y suele ser uno de los mejores puntos de partida. Precisamente porque varias personas actúan sobre el mismo buzón, la necesidad de crear responsables, estados y siguiente acción resulta más evidente.
¿Hace falta cambiar de proveedor de correo?+
No necesariamente. Gmail, Microsoft 365 e IMAP son formas distintas de acceder a un buzón, y la arquitectura puede adaptarse a cada caso. Lo importante es entender qué capacidades técnicas están disponibles y qué nivel de fiabilidad se puede construir.
¿Outlook o Thunderbird cambian la estrategia de automatización?+
Normalmente no. Son clientes de correo, es decir, programas para consultar el buzón. La automatización debe integrarse con el servicio que almacena y expone el correo o con el protocolo disponible, no con la interfaz que usa cada persona para leerlo.
¿Puede la IA identificar a qué cliente pertenece un correo?+
Puede ayudar, pero no conviene tratarlo como una certeza absoluta. Lo razonable es combinar señales técnicas y datos internos, trabajar con niveles de confianza y escalar a revisión cuando la identificación sea ambigua.
¿Se pueden guardar automáticamente los adjuntos?+
Sí, pero no debería hacerse como un simple volcado ciego. Lo recomendable es que pasen por una capa de validación o staging para comprobar duplicados, clasificación, contexto y destino correcto.
¿Puede una IA responder correos de clientes?+
Sí, pero solo en situaciones administrativas, acotadas y de bajo riesgo. Cuando la respuesta exige criterio profesional, lo razonable es que prepare contexto o un borrador y escale a una persona.
¿Cómo se evita crear tareas duplicadas?+
Con control de idempotencia, identificadores técnicos del mensaje o del hilo y reglas para detectar reaperturas, reenvíos y duplicados. Esa capa es obligatoria si el sistema debe ser robusto.
¿Qué ocurre si un mismo correo contiene varios asuntos?+
Esa es precisamente una de las situaciones más importantes que debe resolver la automatización. Lo correcto es detectar múltiples intenciones y convertirlas en ramas, tareas o subprocesos separados.
Fuentes
- Google Workspace Developers — Gmail API Push Notifications.
Documentación oficial sobre notificaciones de cambios en buzones mediantewatchy Cloud Pub/Sub, renovación de la suscripción y recuperación de cambios.
Consultar fuente - Google Workspace Developers — Gmail API History.
Referencia oficial para recuperar cambios del buzón a partir de unhistoryIdy resincronizar cuando el historial disponible ya no cubre el punto de partida.
Consultar fuente - Microsoft Learn — Microsoft Graph change notifications.
Documentación oficial sobre suscripciones a cambios en mensajes y otros recursos de Microsoft 365 mediante un modelo basado en eventos.
Consultar fuente - Microsoft Learn — Lifecycle notifications.
Referencia sobre reautorización, suscripciones eliminadas y notificaciones perdidas, relevante para diseñar recuperación, reconciliación y reintentos.
Consultar fuente - AEPD — Calidad, exactitud y minimización de datos personales en tratamientos con IA.
Nota técnica de la Agencia Española de Protección de Datos sobre finalidad, exactitud, idoneidad y minimización en sistemas que incorporan IA.
Consultar fuente - Yarvia — Automatización para gestorías.
Artículo pilar del clúster sectorial utilizado para mantener coherencia con el mapa de procesos, los límites de automatización y el enlazado interno.
Consultar fuente - Yarvia — Automatización documental en una gestoría.
Arquitectura de referencia para el tratamiento separado de adjuntos, staging, validaciones y excepciones documentales.
Consultar fuente
Las referencias técnicas se utilizan como base de arquitectura y no implican dependencia de un proveedor concreto. La solución puede adaptarse al sistema de correo, software sectorial e integraciones existentes en cada gestoría.
